

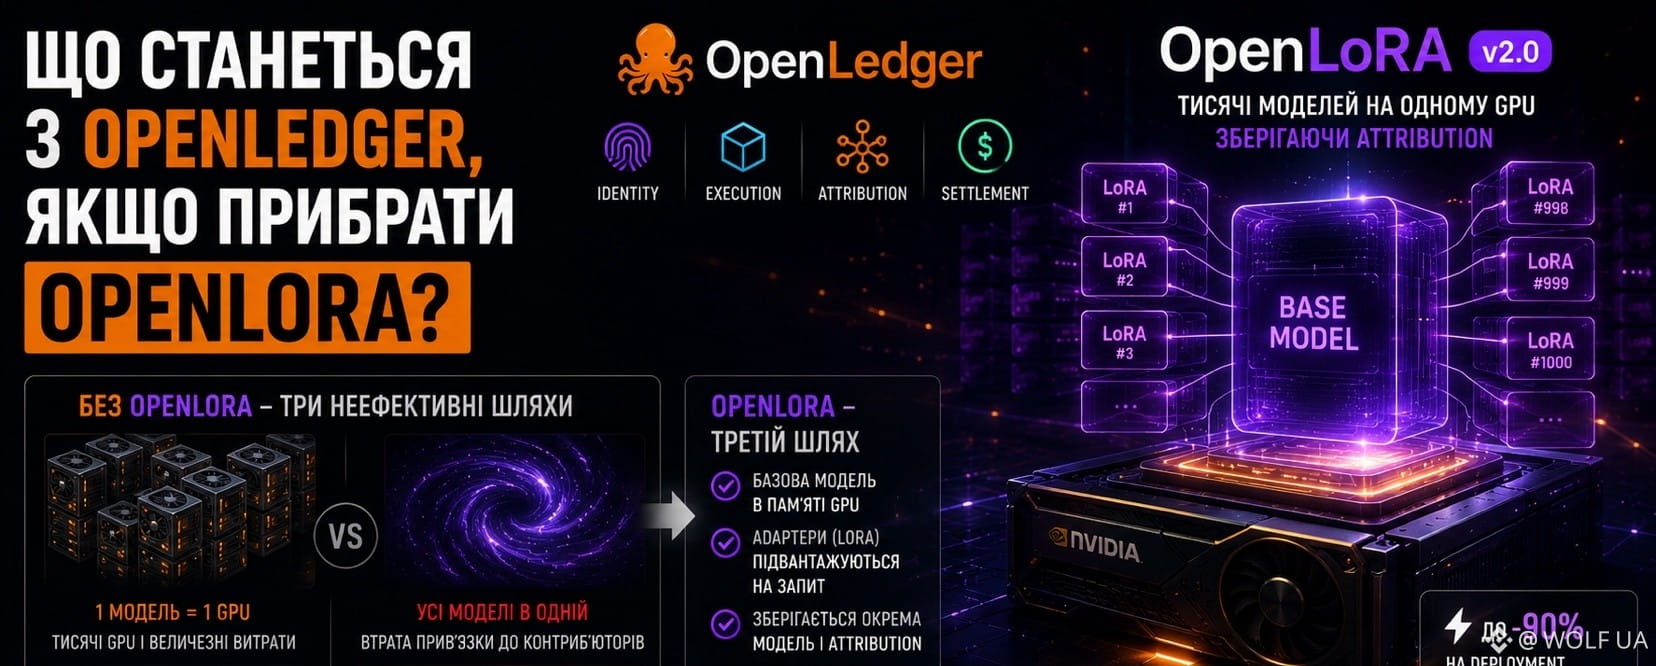

Je länger ich mir OpenLoRA von @OpenLedger anschaue, desto weniger nehme ich es als die nächste Optimierung für KI wahr. Für mich sieht es eher nach einem Test aus, ob die gesamte OpenLedger-Ökonomie im Maßstab überhaupt funktionieren kann.
Interessant ist, dass ich zu diesem Schluss nicht aufgrund der technischen Produktbeschreibung gekommen bin, sondern wegen einer einfachen Frage: Was passiert, wenn man OpenLoRA aus der Architektur entfernt?
Zunächst kurz zur Technologie selbst. OpenLoRA basiert auf dem Gedanken, viele feinabgestimmte Modelle effizient auszuführen, ohne für jedes einzelne einen eigenen GPU zu reservieren. Das Basismodell bleibt dauerhaft geladen, und die LoRA-Adapter werden erst zum Zeitpunkt der Anfrage zugeschaltet. Das Team erklärt, dass man in der Lage ist, tausende Adapter auf einer GPU zu betreiben und die Inferenzkosten deutlich zu senken. Mechanismen wie 4-bit Quantization, dynamic loading und flash attention werden offen beschrieben. Die Zahlen zu tausenden Modellen und die Einsparungen bis zu 90% bleiben jedoch Ergebnisse interner Tests — unabhängige Messungen habe ich nicht gefunden.
Und jetzt zurück zur Frage der fehlenden OpenLoRA.
В основі @OpenLedger лежить Proof of Attribution. Ідея проста: система має знати, які дані вплинули на конкретnu मॉडल та її результат. Але якщо мережа хоче підтримувати не десятки, а тисячі спеціалізованих моделей — юридичних, фінансових, медичних, дослідницьких — виникає проблема розміщення.
Die erste Variante liegt auf der Hand: ein eigenes Modell auf einer eigenen GPU. Aber dann beginnt die Ökonomie sehr schnell nicht mehr wie Web3 auszusehen, sondern wie ein traditionelles Cloud-Geschäft mit riesigen Rechnungen für Rechenleistung.
Die zweite Option wäre, alles in einem großen Modell zu bündeln und das Verhalten über Prompts zu steuern. Das ist günstiger, aber dann verliert Attribution an Genauigkeit. Es wird schwierig zu verstehen, wer genau zum Ergebnis beigetragen hat und wem die Vergütung zusteht.
Faktisch versucht OpenLoRA, einen dritten Weg zu finden. Die Eigenständigkeit der Modelle bewahren, ohne die Notwendigkeit, die Anzahl der GPUs zu vervielfachen. Wenn dieses Schema so funktioniert, wie behauptet, dann bekommt OpenLedger die Chance, seine eigene Ökonomie zu skalieren, ohne die Verknüpfung zwischen Modell, Daten und Mitwirkenden zu verlieren.
Genau deshalb sehe ich mir OpenLoRA nicht als ein Tool an, um Inferenz zu beschleunigen. Solche Lösungen gibt es auf dem Markt genug. Für @OpenLedger übernimmt sie eine andere Rolle — sie hält die Verbindung zwischen der Ausführung des Modells und der Mechanik der Attribution.
Allerdings bleibt hier die entscheidende Frage. Wie sehr braucht der Markt diese Eigenschaft überhaupt?
Wenn Unternehmen und Entwickler beginnen, transparente Herkunft der Daten und eine faire Verteilung der Einnahmen zu fordern, dann könnte OpenLoRA ein wichtiges Element der zukünftigen KI-Infrastruktur werden. Wenn der Markt jedoch weiterhin nur Geschwindigkeit und Günstigkeit bevorzugt, dann dürfte selbst die eleganteste Architektur als Nischenlösung enden.
Daher ist OpenLoRA für mich keine Geschichte über GPUs. Es ist eine Wette darauf, dass Attribution in ein paar Jahren nicht weniger wertvoll sein wird als die Qualität des Modells selbst.
Und wie bewertest du solche Technologien? Warten auf unabhängige Benchmarks und Beweise, oder bist du bereit, dem Projekt Vertrauen zu geben, wenn die Logik der Entscheidung schon überzeugend wirkt?
