

Ich habe in letzter Zeit viel über eine Situation nachgedacht.
Eine Kanzlei nutzt ein Künstliche Intelligenz-System, um Verträge zu überprüfen. Das KI-Modell übersieht eine Klausel. Der Kunde verliert einen Rechtsstreit. Der Partner, der dem Kunden präsentiert, sagt nicht: "Unser KI-Modell hatte eine Genauigkeitsrate von 94 Prozent." Er sagt: "Wir haben einen Fehler gemacht." Dann stellt jemand die Frage, die tatsächlich zählt.
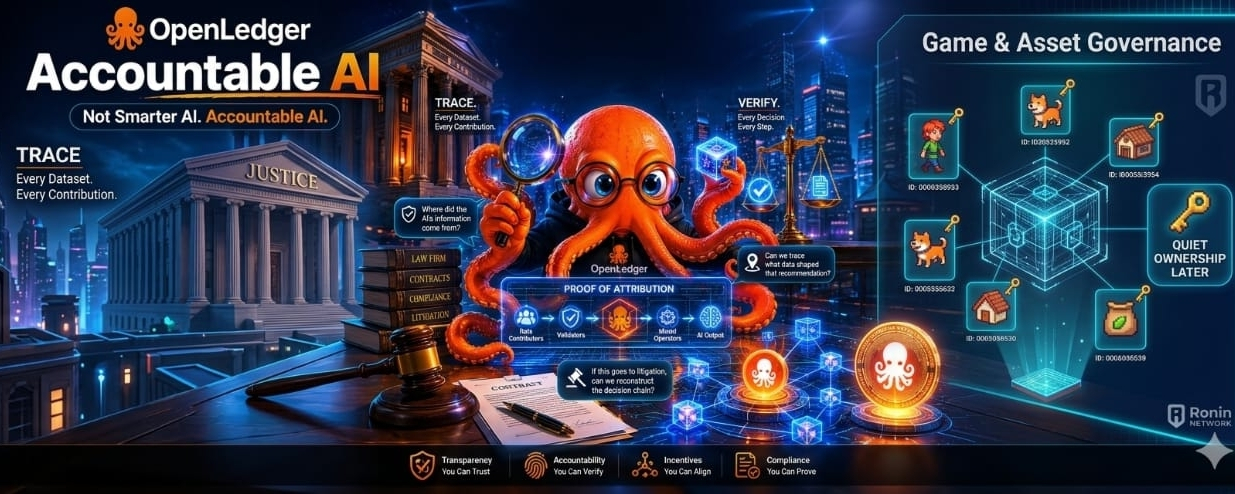
Woher stammen die Informationen über die Künstlichen Intelligenzen?
Können wir zurückverfolgen, welche Daten diese Empfehlung geprägt haben?
Wenn das vor Gericht landet: Können wir dann die Entscheidungskette rekonstruieren?
In aktuellen KI-Implementierungen lautet die ehrliche Antwort auf alle drei Fragen: nein.
Diese Antwort ist im Moment in Ordnung. Heute ist Künstliche Intelligenz größtenteils ein Produktivitätswerkzeug. Sie hilft Menschen, schneller zu arbeiten. Wenn sie falsch liegt, merkt es der Mensch, korrigiert es und macht weiter. Die Kosten, wenn man falsch liegt, werden still auf der Ebene geschluckt.
Irgendetwas verändert sich.
Künstliche Intelligenz bewegt sich von der Produktivitäts-Schicht hin zur Entscheidungs-Schicht. Nicht überall, nicht überall zugleich, aber in bestimmten Domänen und in spezifischen Workflows passiert das bereits. Kreditgenehmigungen. Versicherungsbewertungen. Tools für medizinisches Triage. Vertragsanalyse. Automatisierter Handel. In diesen Kontexten hilft die KI nicht nur dabei, zu entscheiden. In manchen Fällen trifft sie Entscheidungen.. Sobald Entscheidungen echtes finanzielles und rechtliches Gewicht tragen, hört die Frage auf, woher die Intelligenz kommt, auf, rein akademisch zu sein.
Märkte verzeihen Fehler. Was sie anders bepreisen, ist wiederkehrende Unzuverlässigkeit ohne jede Rechenschaftspflicht. Diese Unterscheidung hat meine Sicht darauf verändert, was OpenLedger tatsächlich baut.
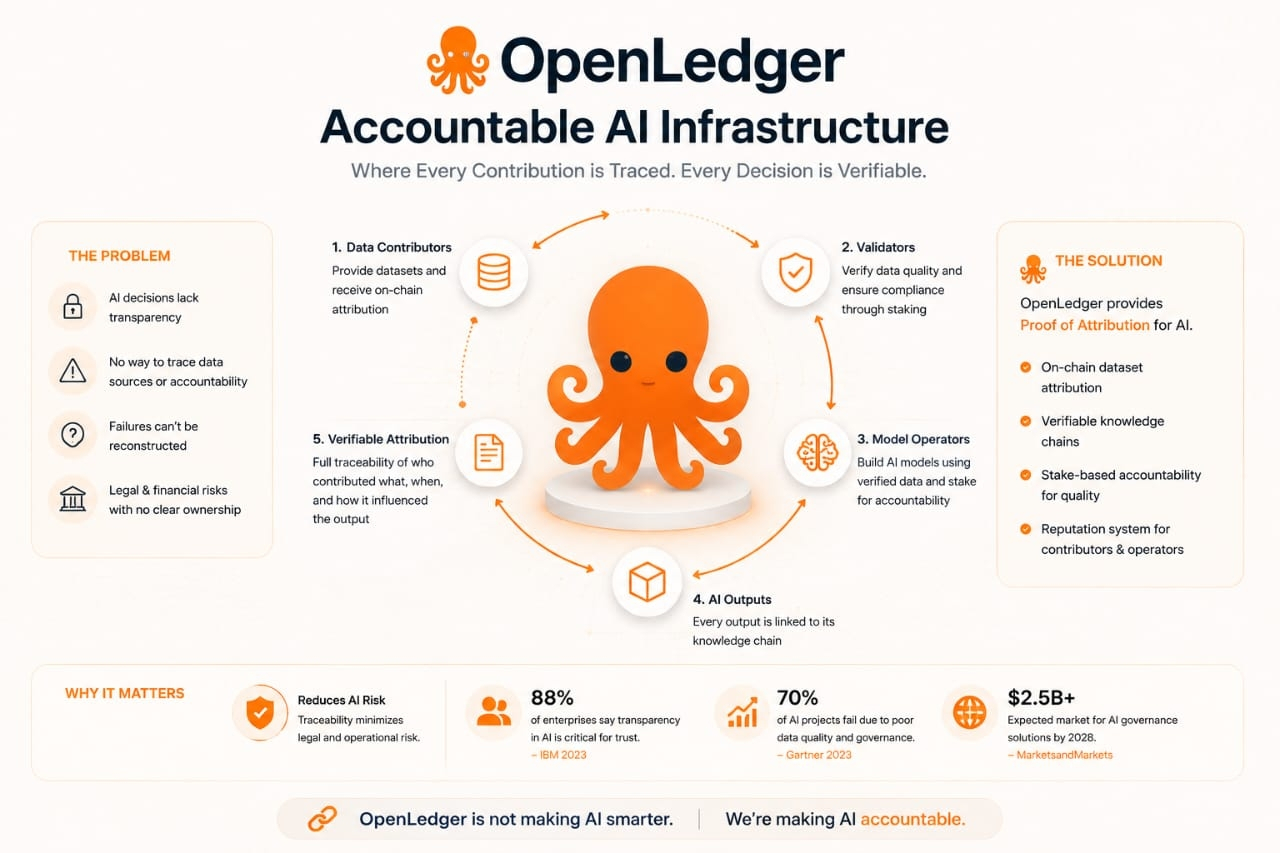
Das meiste, worüber bei KI-Infrastruktur gesprochen wird, dreht sich um die Modellleistung. Benchmark-Scores. Verbesserungen beim Schlussfolgern. Größen von Kontextfenstern. Diese Dinge sind wichtig.. Sie messen alle die Output-Seite der Gleichung. OpenLedger scheint eher die Input-Seite im Blick zu haben – insbesondere die Frage, ob die Wissensbasis, die KI-Outputs hervorbringt, zurückverfolgbar, verifizierbar und in den relevanten Aspekten zur Rechenschaft gezogen werden kann, wenn etwas schiefgeht.
Proof of Attribution ist der Mechanismus. Jeder Datensatz, der zu einem KI-Modell beiträgt, wird als veränderbarer, verifizierbarer Zustandswechsel auf der Kette erfasst. Nicht in einer Datenbank. Nicht in einem Log, das man revidieren kann. Auf einem Ledger, bei dem der Eintrag von Mathematik abhängt statt von institutionellem Gedächtnis. Wenn ein Modell eine Ausgabe erzeugt, ist die Wissenskette hinter dieser Ausgabe nachvollziehbar: Wer hat was beigetragen, wann und wie hat es das Ergebnis beeinflusst. Nachvollziehbar statt undurchsichtig.
Hier wird es aus Sicht des Anreizdesigns interessant.
Wenn Validatoren, Datenbeitragende und Modellbetreiber ihren Wert in die Qualität der Outputs investieren, hören Fehler auf, nur ein reines Produktproblem zu sein. Dann funktionieren sie wie ein Reputationssaldo, der sich gegen die Teilnehmenden aufbaut. Der Beitragsleistende, der minderwertige Daten geliefert hat und dadurch einen Fehler verursacht hat, wird nicht einfach in einer Pipeline vergessen. Er hat einen Nachweis, dass sein Beitrag zu einem schlechten Ergebnis geführt hat. Hochwertige Beitragsleistende entwickeln Erfolgshistorien. Das Ökosystem beginnt, Signal vom Rauschen zu unterscheiden – auf eine Weise, die kein zentrales System nachbilden kann, weil kein zentrales System den Anreiz hat, seine eigenen Fehler korrekt zu dokumentieren.
Das ist eine andere Architektur als die, die derzeit läuft.
Ich möchte ehrlich über die Reibung sein, weil die Idee sauberer ist als die Umsetzung es sein wird.
Unternehmen dazu zu bringen, Attribution-Infrastruktur zu integrieren, erfordert, dass diese Unternehmen ein Maß an Transparenz über ihre KI-Workflows akzeptieren, das viele von ihnen lieber vermeiden würden. Wenn Ihr Modell eine Empfehlung abgegeben hat, die einem Kunden Geld gekostet hat, und diese Empfehlung ist jetzt dauerhaft auf einem öffentlichen Ledger nachvollziehbar, schafft das rechtliche Risiken – auf eine Weise, die das Beibehalten von allem in privaten Logs nicht kann. Die Unternehmen, die Attribution- und Accountability-Infrastruktur brauchen, sind oft genau die, die die stärksten Anreize haben, sich dagegen zu wehren, bis Regulierung ihnen den Weg versperrt.
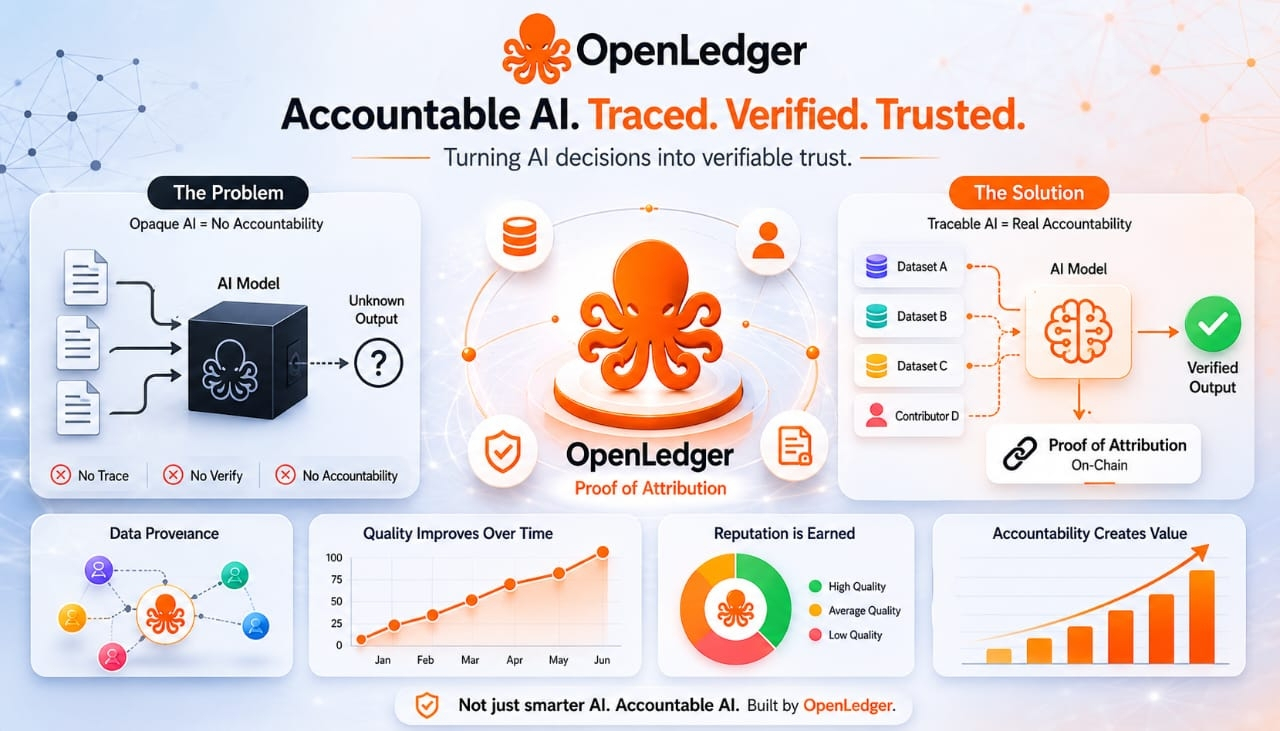
Diese externe Zwangsfunktion kommt. Der EU AI Act schafft Compliance-Pflichten rund um Erklärbarkeit und Datenherkunft. Mehrere Rechtsräume bewegen sich gleichzeitig in Richtung Anforderungen, nach denen Organisationen nachweisen können müssen, wie ihre KI-Systeme zu ihren Schlussfolgerungen gelangt sind. Die Unternehmen, die jetzt Attribution-Infrastruktur bauen, tun nicht nur etwas Richtiges. Sie bauen die Compliance-Schicht, die am Ende jeder brauchen wird, bevor der Zeitdruck durch Fristen ankommt.
Ob die OpenLedger-Nachfrage aus wiederkehrender Nutzung oder aus einem Narrativ-Wechsel kommt, ist das Signal, das hier tatsächlich zählt. Infrastrukturtokens überleben, wenn betriebliche Schmerzen weiterhin wiederholte Nachfrage erzwingen. Ein Entwickler, der Attribution-Infrastruktur in seinen KI-Workflow integriert und feststellt, dass das seine Exponierung und Compliance-Kosten senkt, ist eine andere Art Kunde als jemand, der einen Token kauft, weil die Geschichte überzeugend klingt. Der eine schafft Nachfrage. Der andere erzeugt ein Kursdiagramm, das gut aussieht, bis es das nicht mehr tut.
Der volle Dollar-Wert kann laut bleiben, während die reale Nutzung dünn ist. Diese Lücke ist es, an der die meisten Infrastrukturnarrative still zerbrechen.
Ich komme immer wieder zu dieser Anwaltskanzlei-Szenario-Variante. Nicht weil es dramatisch ist, sondern weil es alltäglich ist. Das passiert bereits still in Situationen, in denen KI-gestützte Workflows Ausgaben erzeugen, die sich als falsch erweisen – auf eine Weise, die sich danach von niemandem vollständig rekonstruieren lässt. Die teure Version dieser Geschichte wurde bisher noch nicht weithin erzählt, weil Künstliche Intelligenz in ihrer Einführung in Hochrisiko-Bereiche noch früh genug ist, dass die Fehler aufgefangen werden, ohne zu Schlagzeilen zu werden.
Das ändert sich, je tiefer die Einführung voranschreitet.
Die Frage, mit der ich mich beschäftige, lautet nicht, ob Künstliche Intelligenz in folgenreichen Bereichen Fehler machen wird. Das wird sie. Jede Technologie, die im großen Maßstab arbeitet, macht Fehler. Die Frage ist, ob die Infrastruktur existiert, um nachzuvollziehen, was passiert ist, Verantwortung den Teilnehmenden zuzuweisen und die Anreize so zu verändern, dass Verlässlichkeit mit der Zeit besser wird, statt still zu verfallen.
Das ist die Wette, die OpenLedger eingeht.
Nicht die schlauere Künstliche Intelligenz. Rechenschaftspflichtige Künstliche Intelligenz.
Das sind nicht die Dinge.. Ich bin zunehmend überzeugt, dass der Markt den Unterschied unterpreist.
