

Vor ein paar Jahren nahm ich an, dass die wichtigste Ressource in der KI Rechenleistung war.
Wer immer die meiste Rechenleistung hatte, würde gewinnen. Diese Annahme schien damals offensichtlich. In letzter Zeit habe ich jedoch festgestellt, dass ich meiner Aufmerksamkeit etwas viel weniger Aufregendem widme. Nicht Intelligenz. Nicht einmal Genauigkeit.
Oder genauer gesagt, was passiert, wenn der Maschinen-Speicher anders funktioniert als der menschliche Speicher.
Menschen vergessen ständig Dinge. Wir vergessen Gespräche, Details, Namen, Fehler. Manchmal ist Vergessen gesund. Ganze Rechtssysteme sind darauf aufgebaut, wie lange bestimmte Informationen Menschen begleiten. Aber wenn eine Wirtschaft wichtige Informationen vergisst, können die Konsequenzen überraschend teuer sein.
Dieser Unterschied lässt mich nicht los, wenn ich mir KI-Infrastruktur anschaue.
Die meisten sprechen noch immer über KI, als wäre das Kernproblem, bessere Antworten zu erzeugen. Doch je mehr ich beobachte, wie Unternehmen mit KI experimentieren, desto weniger überzeugt bin ich davon, dass bessere Antworten die eigentliche Engstelle sind. In vielen Fällen zeigt sich das Problem erst, nachdem die Antwort bereits erzeugt wurde.
Woher kam diese Information?
Wer hat es beigesteuert?
Kann das irgendjemand verifizieren?
Und vielleicht am wichtigsten: Wenn in sechs Monaten etwas schiefgeht – kann dann irgendjemand rekonstruieren, was passiert ist?
Diese Fragen klingen langweilig, bis Geld ins Spiel kommt.
Viele KI-Projekte ringen im Intelligenz-Wettlauf miteinander. Schnellere Modelle. Besseres Reasoning. Effizienteres Training. @OpenLedger seems to be looking somewhere else. Fast unter der KI selbst.
So wie ich es interpretiere, stellt das Projekt eine seltsame Frage: Was wäre, wenn die knappe Ressource nicht Intelligenz ist, sondern nachvollziehbares Wissen?
Zuerst dachte ich, das klingt nach einem Branding-Exercise rund um Datenbesitz. Je länger ich darüber nachgedacht habe, desto unwohlere Gefühle brachte mir diese Erklärung.
Denn sobald KI-Systeme anfangen, miteinander zu interagieren, wird die Wissenskette sehr schnell unübersichtlich. Stell dir vor, zehn KI-Systeme tragen zu einem einzigen Output bei. Eines liefert Forschung. Ein anderes liefert Marktdaten. Ein weiteres steuert historische Aufzeichnungen bei. Andere ergänzen Analysen, Filter- oder Ranking-Mechanismen. Irgendwann erscheint eine Antwort. Alle sehen die Antwort. Fast niemand sieht den Weg dorthin. Dieser verborgene Pfad könnte am Ende wichtiger werden als der finale Output.
Ich erinnere mich daran, wie ich von einer Finanzinstitution gelesen habe, die AI-gestützte Workflows testet. Was mich nicht interessiert hat, war ob das Modell nützliche Ergebnisse liefert. Mich interessierte die Compliance-Diskussion danach. Die Organisation fragte nicht, ob die KI intelligent ist. Sie fragte, ob sie den Entscheidungsprozess gegenüber Aufsichtsbehörden erklären können, falls es nötig wird. Das fühlt sich nach einer ganz anderen Art von Problem an.
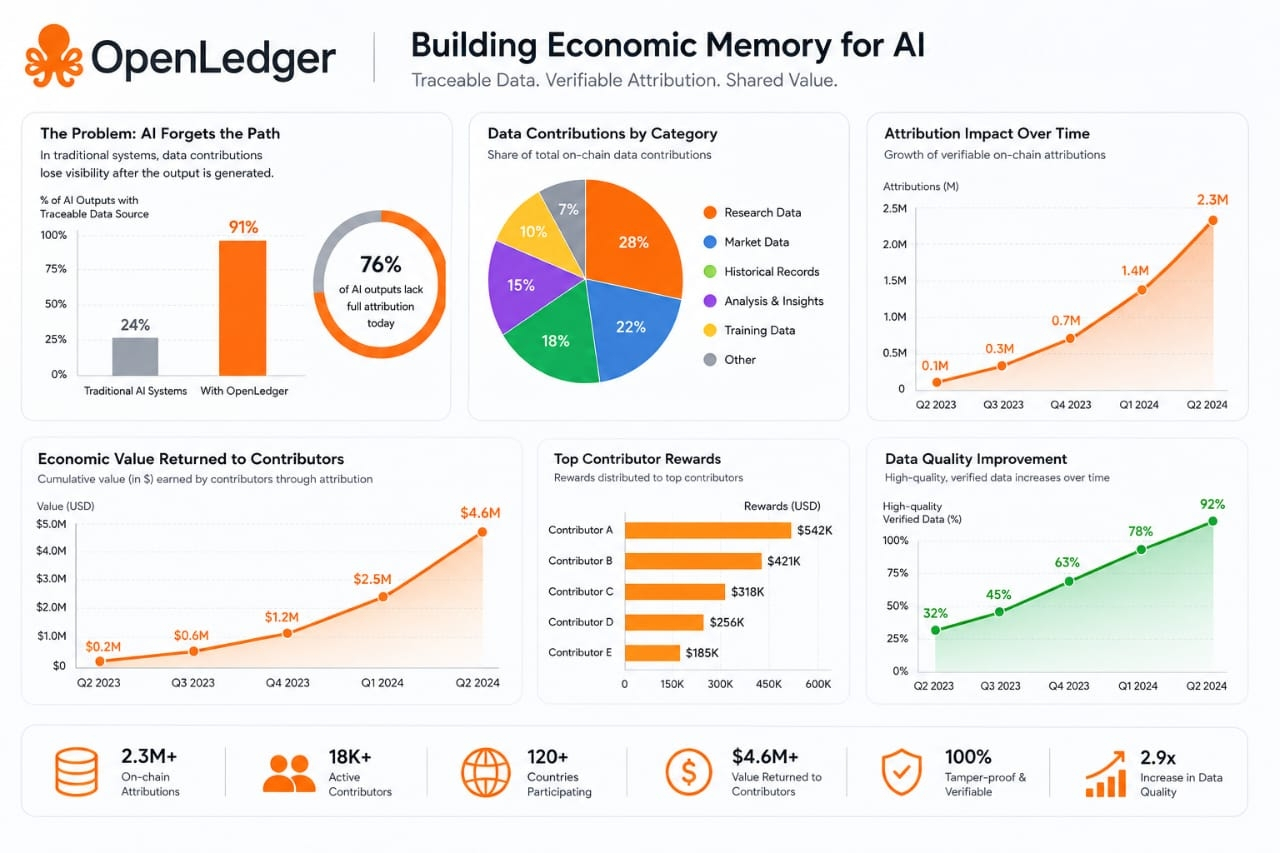
Eine Volkswirtschaft kann erstaunlich lange mit unvollkommener Intelligenz tolerieren. Was sie nur schwer tolerieren kann, ist unsichtbare Verantwortlichkeit.
Daran liegt teilweise, dass OpenLedger meine Aufmerksamkeit gewonnen hat.
In Lieferketten sind Herkunfts- bzw. Provenienzaufzeichnungen wichtig, weil Unternehmen wissen müssen, woher Produkte stammen. Im Gesundheitswesen gibt es Dokumentation, weil man sich auf das Gedächtnis allein nicht verlassen kann. Doch ein Großteil der KI arbeitet noch immer so, als wäre Attribution optional. Das kommt mir seltsam vor. Wir bauen Systeme, die zunehmend wirtschaftliche Entscheidungen beeinflussen, behandeln aber gleichzeitig die Herkunft von Informationen als nachrangige Infrastruktur. Vielleicht ist das in Ordnung, solange KI nur ein Produktivitätswerkzeug bleibt. Weniger sicher bin ich, wenn KI selbst zu einem Teilnehmer wirtschaftlicher Aktivität wird.
Aus dieser Perspektive wird die OpenLedger-These noch interessanter.
Wenn Datenbeiträge nachvollziehbar bleiben, verschwindet Wissen nicht einfach in einem Modell. Beiträger können potenziell mit der nachgelagerten Wertschöpfung verbunden bleiben. Noch wichtiger: Entscheidungsabläufe werden beobachtbar. Proof of Attribution ist der zentrale Mechanismus: Er zeichnet jede Datenbeitragsleistung als dauerhafte, verifizierbare Zustandsänderung direkt on-chain auf. Nicht in einer privaten Datenbank eines Unternehmens. Nicht in einem Log, das still und heimlich überarbeitet werden kann. Auf einem Ledger, dessen Aufzeichnung von Mathematik abhängt – nicht vom Goodwill von Institutionen.
Das größere Problem könnte wirtschaftliches Gedächtnis sein.
Wenn ein System den Überblick verliert, woher Wissen ursprünglich stammt, verliert es nach und nach seine Fähigkeit, Signal von Rauschen zu unterscheiden. Hochwertige Beiträger werden schwerer zu identifizieren. Schlechte Informationen und gute Informationen beginnen, auf ähnlichem Niveau zu konkurrieren. Schließlich verschieben sich die Anreize. Dieser Prozess ist langsam. Beinahe unsichtbar. Und dann, plötzlich, merkt jeder, dass die Qualität nachlässt.
Ich habe ähnliche Muster außerhalb von KI gesehen. Finanzmärkte verbringen oft Jahre damit, Effizienz zu optimieren, bevor sie feststellen, dass sie aus Versehen Transparenz entfernt haben. Social-Plattformen optimieren auf Engagement, bevor sie merken, dass sie damit die Glaubwürdigkeit geschwächt haben. Systeme brechen selten gleichzeitig komplett. Sie driften. Möglicherweise steht KI-Infrastruktur vor etwas Ähnlichem.
Trotzdem glaube ich nicht, dass der Pfad von OpenLedger so geradlinig ist. Hier gibt es einen Trade-off, über den eigentlich niemand wirklich spricht. Alle unterstützen Verantwortlichkeit in der Theorie. Doch Verantwortung wird viel dünner, sobald sie mit zusätzlicher operativer Mehrarbeit verbunden ist. Deshalb betrachte ich OpenLedger nicht als garantierten Gewinner. Was ich spannend finde, ist die Richtung der Wette selbst.
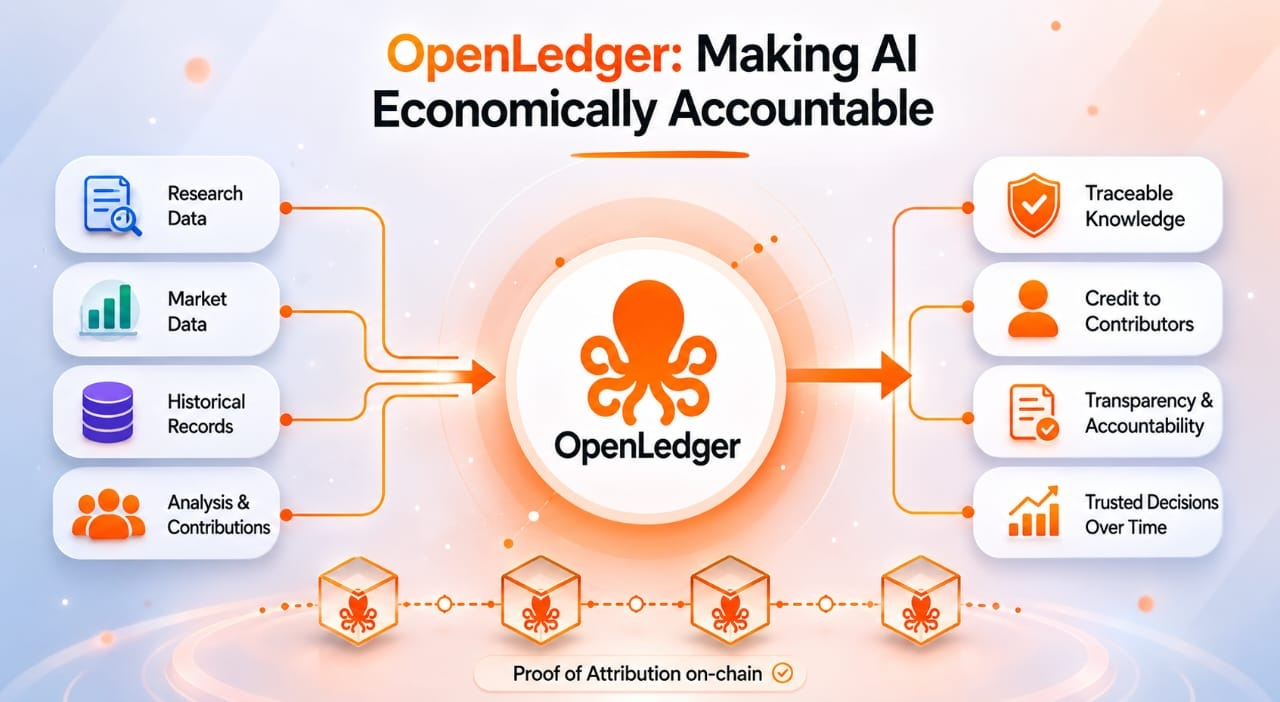
Die Branche ist besessen davon, KI intelligenter zu machen. OpenLedger scheint eher daran interessiert, KI wirtschaftlich zur Rechenschaft ziehen zu können. Das sind nicht dieselben Ziele. Und ich frage mich immer wieder, ob sich der Markt auf die falsche Knappheit konzentriert.
Rechenleistung wird mit der Zeit günstiger. Modelle werden besser. Die Kosten für Inferenz sinken. Aber vertrauenswürdige Aufzeichnungen haben eine merkwürdige Tendenz, mit zunehmender Komplexität der Systeme immer wertvoller zu werden.
Vielleicht klingt KI-Vergesslichkeit heute noch nach einem technischen Ärgernis. Nach einem Produktproblem. Etwas, das Ingenieurteams irgendwann lösen. Oder Vergesslichkeit wird zur versteckten Quelle des Risikos, die niemand bemerkt, bis ganze KI-getriebene Märkte davon abhängen, sich zu merken, wer was beigetragen hat – und zwar wann und warum.
Das ist die Wette, die OpenLedger eingeht.
Ich finde es interessanter als die meisten Wetten, die gerade gemacht werden
