
Als ich am Abend meinen Computer aufräumte und einige alte Projekt-Logs sortierte, blieb der Cursor von selbst stehen, und ich blätterte ein paar Seiten in den handschriftlichen Notizen durch, die ich damals für das Debugging von Smart Contracts gemacht hatte. Darin waren dicht gedrängt Aufzeichnungen zu den Gasverbrauchs-Kurven in allerlei Randfällen und den Vorgehensweisen zur Fehlersuche bei fehlgeschlagener Status-Synchronisation – allein beim Lesen musste ich selbst ein kleines Lächeln unterdrücken. In den letzten Jahren habe ich viele praktische Erfahrungen und Daten in verschiedenste Tools eingespeist, um Ideen zu validieren. Dabei stellte sich heraus, dass die wirklich wertvollen grundlegenden Erkenntnisse oft an zentralisierten Plattformen leicht abgegriffen werden, während die Beitragenden selbst nur schwer eine angemessene Gegenleistung daraus erhalten. Dieses Gefühl macht mich bei Projekten, die behaupten, den Wert von Daten neu aufzubauen, von Natur aus vorsichtiger.
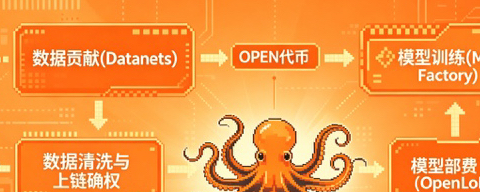
Genau in dieser Stimmung hat der Kerl mit den Karren (Karte?) in letzter Zeit seine Aufmerksamkeit auf das OpenLedger-Projekt gelenkt, das in der Community nach und nach immer häufiger erwähnt wird. Anfangs hatte ich nicht allzu hohe Erwartungen, denn ich habe in der Vergangenheit zu viele Lösungen gesehen, die mit einem KI-Label versehen waren, aber nur an der Oberfläche etwas gemacht haben. Doch als ich mir ein paar Tage Zeit genommen habe, um ihren Kernprotokollcode wirklich sorgfältig zu lesen – @OpenLedger insbesondere das dezentrale Daten-Netzwerk-Modul namens Datanets – habe ich festgestellt, dass sie tatsächlich einen eher pragmatischen Weg einschlagen: Mit der Blockchain soll der Wertfluss aus dem KI-Inferenzprozess wirklich auf eine verifizierbare On-Chain-Abrechnung abgebildet werden.
Sie schlagen ein „Payable AI“-Mechanismus vor: Im Kern geht es darum, eine verschlüsselte Kennungslogik und ein modulares Vertragsdesign zu nutzen, damit jeder einzelne Modellaufruf, jeder Beitrag von Daten oder jede Bereitstellung von Rechenleistung eindeutig nachvollziehbar wird und die entsprechende Vergütung erhält. Stell dir vor, ein Entwickler lädt ein eigenes, trainiertes proprietäres Feature-Extraktionsmodul ins Netzwerk hoch. Wenn später ein Quant-Team dieses Modul für die Unterstützung bei der Kursprognose nutzt, teilt das zugrunde liegende Protokoll die Kosten automatisch gemäß den vordefinierten Gewichtungen des Beitrags auf und leitet sie an die relevanten Adressen weiter. Von der Idee her ist das recht „clean“: Die Verteilung, die früher vollständig von großen Plattformen monopolisiert wurde, soll in dezentralen Strukturen an die tatsächlichen Beitragsleistenden zurückgegeben werden.
Aus Sicht eines Ingenieurs ist #OpenLedger vor allem die modulare Aufteilung dieses Architektursatzes das, was ich am meisten schätze. Datanets organisiert die Datenschicht, die Modelschicht und die Abrechnungsschicht relativ unabhängig voneinander, sodass spätere Iterationen und lokale Upgrades möglich sind und nicht das gesamte System zusammenbricht, nur weil in einem Teil etwas schiefgeht. Ich bin selbst anhand der Dokumentation ein paar Mal durch den End-to-End-Aufrufablauf im Testnetz gegangen. Die Einstiegshürde ist nicht niedrig, aber die Logik ist recht klar. Für Menschen mit Erfahrung in Solidity und verteilten Systemen reichen ein bis zwei Tage, um die grundlegenden Interaktionen zusammenzustellen. Und nachdem es dann wirklich läuft, sind Latenz- und Gebühren-Performance stabiler, als ich erwartet hatte. Allerdings ist das nur ein kleinerer Test; wie es sich in echten Hochlast-Szenarien mit starker Parallelität verhält, muss noch länger beobachtet werden.$OPEN
Ich weiß aber auch, dass jeder dieser Ansätze an realen technischen Herausforderungen nicht vorbeikommt. Eine starke Abhängigkeit von On-Chain-Echtzeitabrechnung: Wenn man es mit multimodalen KI-Aufgaben in großem Maßstab und hoher Parallelität zu tun hat, werden Netzwerk-Latenz und die Belastung durch Knotensynchronisation schnell zum Problem. Ich habe das zuvor schon in anderen Hochlast-öffentlichen Chains am eigenen Leib erlebt: Häufige Bestätigungsdelays und sprunghafte Gebührenänderungen haben direkt viele der ursprünglich geplanten automatisierten Abläufe durcheinandergebracht. Wenn Datanets in Zukunft nicht kontinuierlich an der Erweiterung von Knoten und der Optimierung über Sharding hinweg iteriert, könnte dieses Risiko dazu führen, dass einige Nutzer finden, dass ein traditioneller zentralisierter Service zuverlässiger ist.$BTC
Außerdem sind die Arten der aktuell in ihrem Netzwerk fließenden Daten noch relativ konzentriert: vor allem strukturierte Aufzeichnungen im Finanzbereich und Teile öffentlich verfügbarer Trainingsdaten. Das kann zwar die frühe Validierung fokussierter machen, bedeutet aber auch, dass es noch einen deutlichen Abstand gibt, um branchenübergreifende und wirklich vielfältige KI-Anwendungen zu unterstützen. Wenn sich das Entwickler-Ökosystem später nicht schnell genug erweitert und kontinuierlich frische hochwertige Daten hinzukommen, kann der gesamte Kreislauf der Wertverteilung in eine Phase niedriger Aktivität geraten – dann leisten nur noch wenige Knoten im Grunde alles für sich selbst.
Trotz dieser potenziellen Probleme bin ich diesem Ansatz gegenüber vorsichtig zustimmend. Die Preisbildungs- und Vergütungslogik auf der Angebotsseite von KI aus der Hand weniger großer Konzerne zurückzuholen und sie mit Blockchain-Technologie für normale Entwickler zugänglich zu machen, damit sie ihre einzigartigen Ressourcen leichter monetarisieren können, ist an sich schon einen ernsthaften Versuch wert. Zumindest eröffnet es Menschen, die über Nischen-Datensets oder optimierte Modelle verfügen, einen neuen möglichen Pfad.
In den nächsten Monaten will ich weiterhin als Beobachter auf ihre tatsächlichen On-Chain-Aktivitäten achten: auf die echte Aufrufhäufigkeit der Smart Contracts, auf den Wachstumskurs der dezentralen Adressen für das Hochladen von Daten im Datanets-Netzwerk und auf die Stabilität der Abrechnung über Module hinweg. Diese Daten werden ehrlicher sein als jedes Whitepaper. Wenn die Beobachtungsphase abgeschlossen ist, entscheide ich anhand der tatsächlichen Performance, ob ich mehr Zeit und Einsatz investieren möchte. Insgesamt habe ich bei solchen Erkundungen, bei denen technischer Enthusiasmus auf Code-Ebene umgesetzt wird, stets eine gedämpft-optimistische Haltung – nicht weil es so revolutionär klingt, sondern weil es die Komplexität der realen Welt in den technischen Details nicht ausblendet.