
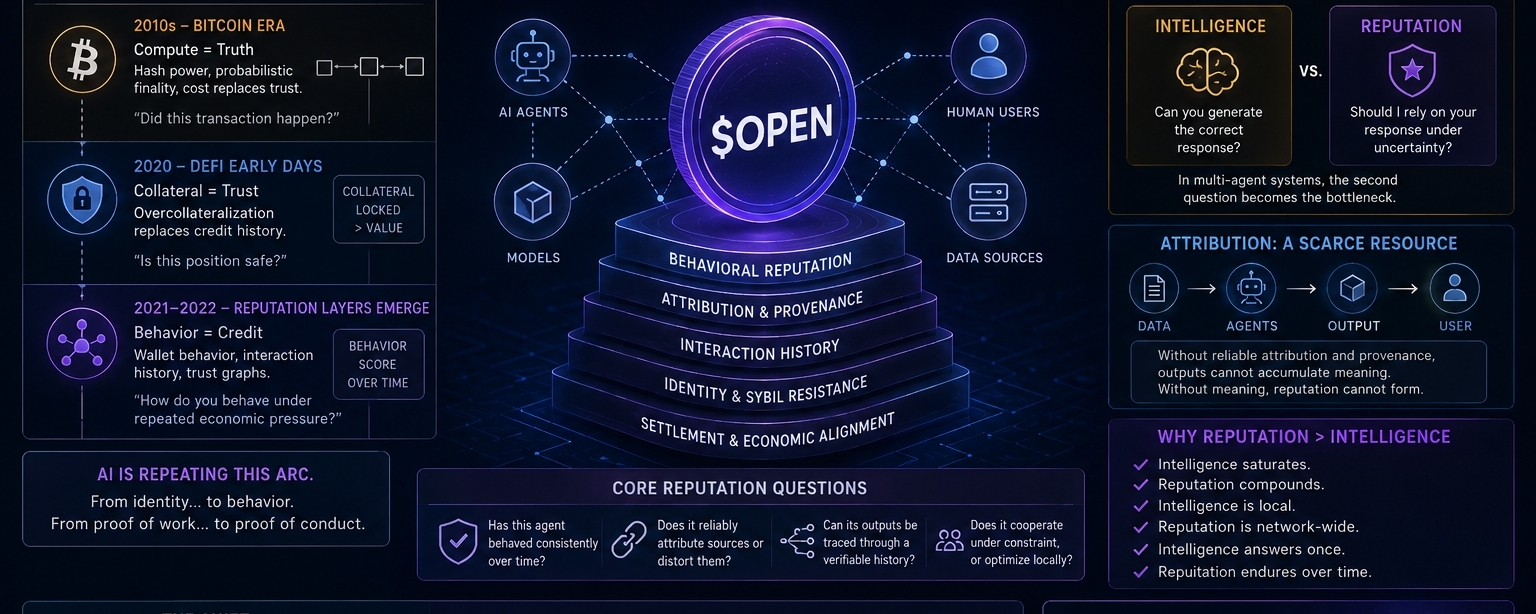
Ich komme immer wieder auf ein einfaches Missverhältnis zurück, wie wir derzeit Intelligenzsysteme bewerten: Wir neigen immer noch dazu, die Ausgabequalität zu belohnen, während die Systeme selbst sich leise in Richtung etwas Grundlegendem bewegen – verhaltensmäßige Zuverlässigkeit über die Zeit.
$OPEN ist in diesem Sinne besser als Infrastruktur-Signal zu verstehen als als Token-Erzählung. Nicht weil es ein fertiges System repräsentiert, sondern weil es sich innerhalb einer breiteren Richtung befindet, in die sich der AI-Stack bewegt: Reputation als erstklassiges primitives Konzept.
Von Berechnung zu Verhalten
In der frühen Krypto war die dominante Abstraktion einfach: Berechnung entspricht Wahrheit. Bitcoin machte das explizit—Hash-Power, probabilistische Endgültigkeit und die Annahme, dass wirtschaftliche Kosten Vertrauen ersetzen können. Das System musste nicht „wissen“, wer du warst; es musste nur überprüfen, was du getan hast.
Aber dieses Modell, obwohl elegant, war eng. Es funktionierte, weil die Frage eng war: Ist diese Transaktion passiert oder nicht?
KI-Systeme operieren nicht in diesem binären Raum. Ihre Ausgaben sind probabilistisch, kontextuell und stark abhängig von vorherigem Verhalten. Ein Modell, das einmal „korrekt“ ist, ist weniger nützlich als ein Agent, der unter Bedingungen, Datensätzen und Anreizen konsistent korrekt ist.
Hier beginnt der Ruf nach Reputation wichtiger zu werden als rohe Intelligenz.
Die Krypto-Analogie, die tatsächlich passt
Wenn ich das auf etwas Vertrautes abbilden soll, ist es weniger Bitcoin und mehr frühe DeFi-Kreditlagen, die sich um primitive Liquiditätsmärkte bilden.
Im Zyklus 2020–2022 versuchte DeFi, Risiko ohne Identität zu bepreisen. Sicherheiten ersetzten Vertrauen. Überbesicherung ersetzte die Kreditgeschichte. Es funktionierte, aber nur bis zu einem gewissen Punkt. Schließlich begannen Protokolle leise, reputationsähnliche Signale wieder einzuführen: Wallet-Verhaltensbewertung, Liquiditätskonsistenz, Interaktionsgeschichte und protokollnative „Vertrauensgraphen“.
Wir sahen frühe Versionen davon in Systemen wie Gitcoin Passport und verschiedenen Sybil-Widerstandsrahmen, wo Identität nicht ein einzelnes Credential war, sondern eine Ansammlung von Verhaltensbeweisen über die Zeit.
Dieser Wandel ist wichtig: Er markierte den Übergang von „Wer bist du?“ zu „Wie verhältst du dich unter wiederholtem wirtschaftlichen Druck?“
KI-Reputationssysteme wiederholen jetzt denselben Bogen.
$OPEN als Koordinationsschicht, nicht als Produkt
In diesem Rahmen sitzt OPEN näher an einem Koordinationsprimitive als an einem Anwendungstoken. Die interessante Frage ist nicht, was es in Isolation „macht“, sondern welche Art von Verhaltensgraphen es über Agenten, Modelle und menschliche Teilnehmer ermöglicht.
Denn sobald KI-Agenten beginnen, wirtschaftlich zu interagieren—Handelssignale, das Teilen von Inferenzaufgaben, das Delegieren von Berechnungen—stößt man sofort auf ein Problem, das Krypto bereits gut kennt:
Sybil-Widerstand wird alles.
Ein Agent, der unendliche Identitäten erschaffen kann, bricht nicht nur Märkte, sondern auch die Lernsysteme selbst. Wenn jede Interaktion zurückgesetzt werden kann, dann hat keine Interaktion Bedeutung. Und ohne angesammelte Bedeutung kann man keine Reputation bilden.
Also verschiebt sich der Designsdruck in Richtung Systeme, die beantworten können:
Hat sich dieser Agent über die Zeit hinweg konsistent verhalten?
Kann es zuverlässig Quellen zuordnen oder sie verzerren?
Können seine Ausgaben durch eine überprüfbare Interaktionshistorie zurückverfolgt werden?
Kooperiert es unter Einschränkungen oder optimiert es nur lokal?
Das sind keine Fragen der Intelligenz. Es sind Fragen des Verhaltens.
Die verborgene Schicht: Attribution als knappe Ressource
Eine hier wenig diskutierte Dimension ist Attribution.
In aktuellen KI-Workflows ist Attribution fast entbehrlich. Ausgaben werden generiert, konsumiert und von ihrem Ursprung getrennt. Doch wenn KI beginnt, an wirtschaftlichen Systemen teilzunehmen, insbesondere in Forschung, Handel und Automatisierung, wird Attribution zu einer knappen Ressource.
Nicht im rechtlichen Sinne, sondern im Sinne der Koordination.
Wenn ich nicht zuverlässig zurückverfolgen kann, wie eine Ausgabe gebildet wurde, auf welchen Daten sie basierte, welche Zwischenagenten sie berührt haben, welche vorherigen Signale sie geprägt haben, dann kann ich ihr in einem System, das sich über die Zeit entwickelt, kein Gewicht zuweisen.
Hier beginnen die Reputationsschichten, etwas Ähnliches wie „Liquiditätsgeschichte“ in DeFi zu ähneln.
In DeFi zählt die Liquiditätstiefe mehr als der Preis. Preis ohne Tiefe ist Lärm. Ähnlich ist Intelligenz ohne Verhaltens Tiefe nur Ausgabe.
Warum Intelligenz nicht mehr der Engpass ist
Hier passiert eine subtile Umkehrung.
Wir gingen davon aus, dass der Engpass in KI-Systemen die Intelligenz sein würde: bessere Modelle, größere Parameterzahlen, mehr Daten.
Aber in Multi-Agenten-Umgebungen sättigt sich die Intelligenz schnell. Sobald Modelle einen bestimmten Fähigkeitsgrad erreichen, verschiebt sich die Differenzierung von „Kann es das Problem lösen?“ zu „Kann es vertrauenswürdig in einem Netzwerk anderer Agenten agieren?“
An diesem Punkt wird Reputation zum dominierenden Engpass.
Du kannst es dir so vorstellen:
Intelligenz beantwortet: Kannst du die richtige Antwort generieren?
Reputation beantwortet: Sollte ich auf deine Antwort unter Unsicherheit vertrauen?
In realen Systemen dominiert zunehmend die zweite Frage.
Der Geist der frühen Krypto-Zyklen
Hier gibt es ein vertrautes Muster aus den frühen Krypto-Märkten.
Im Jahr 2017 war die dominante Erzählung Durchsatz und Dezentralisierung. 2020 wurde es Komponierbarkeit und Liquidität. Bis 2022 verschob es sich hin zu Risikomanagement, Identität und Überlebensfähigkeit unter Stress.
Jeder Zyklus hat leise die Bedeutung technischer Fähigkeiten verringert und die Bedeutung von vertrauensbildenden Signalen auf Systemebene erhöht.
KI durchläuft jetzt eine komprimierte Version dieses gleichen Übergangs.
Wir bewegen uns von:
> „Was kann das Modell tun?“
zu
> „Was hat dieser Agent über die Zeit hinweg, unter Druck und im Austausch mit anderen zuverlässig bewiesen?“
Das ist ein Reputationsproblem, kein Intelligenzproblem.
Die unbequeme Implikation
Wenn diese Trajektorie anhält, dann könnten die wichtigsten KI-Systeme im nächsten Zyklus nicht die intelligentesten sein.
Sie könnten über die Zeit hinweg am lesbarsten sein.
Das ist ein ganz anderes Optimierungsziel.
Lesbarkeit bedeutet hier:
Stabile Verhaltenssignaturen
Rückverfolgbare Entscheidungswege
Konsistente Attributionsmuster
Widerstand gegen Identitätsfragmentierung
Vorhersehbare Antworten unter widrigen Bedingungen
Diese Eigenschaften verbessern nicht die rohe Intelligenz. Sie verbessern die Vertrauensdichte.
Und die Vertrauensdichte ist es, die es Systemen ermöglicht, über isolierte Anwendungsfälle hinaus in wirtschaftliche Infrastruktur zu skalieren.
Wo OPEN in diesen Wandel passt
Ich sehe nicht, dass OPEN irgendetwas davon löst. Es sitzt früher im Stapel, näher an Experimenten, wie Reputation tokenisiert, geteilt oder portabel über KI-Systeme gemacht werden könnte.
Aber die Richtung, in die es zeigt, stimmt mit einem breiteren Muster überein, das bereits in Krypto sichtbar ist: jedes skalierbare System führt schließlich das Gedächtnis wieder ein.
In diesem Fall ist Gedächtnis keine Speicherung. Es ist Verantwortlichkeit über die Zeit.
Und Verantwortlichkeit ist es, die Intelligenz von einer momentanen Ausgabe in ein Infrastrukturkomponente verwandelt.
Abschließender Gedanke
Wir tendieren dazu, zu sehr auf Intelligenz zu setzen, weil sie sichtbar ist. Du kannst sie benchmarken, vergleichen, bewerten.
Reputation ist weniger sichtbar. Sie sammelt sich leise an, wie Liquiditätstiefe oder Validatorhistorie, bis sie plötzlich das einzige wird, was zählt, wenn die Bedingungen ungewiss sind.
Wenn KI-Systeme weiterhin mit wirtschaftlichen Systemen verschmelzen, wird Intelligenz zunehmend eine Grundannahme werden.
Reputation wird der Differenzierer werden.
Und OPEN, ob es als Protokoll erfolgreich ist oder nicht, sitzt innerhalb dieses größeren Übergangs: von Systemen, die Fragen korrekt beantworten, zu Systemen, die vertrauenswürdig bleiben können, lange genug, damit diese Antworten wichtig werden.