

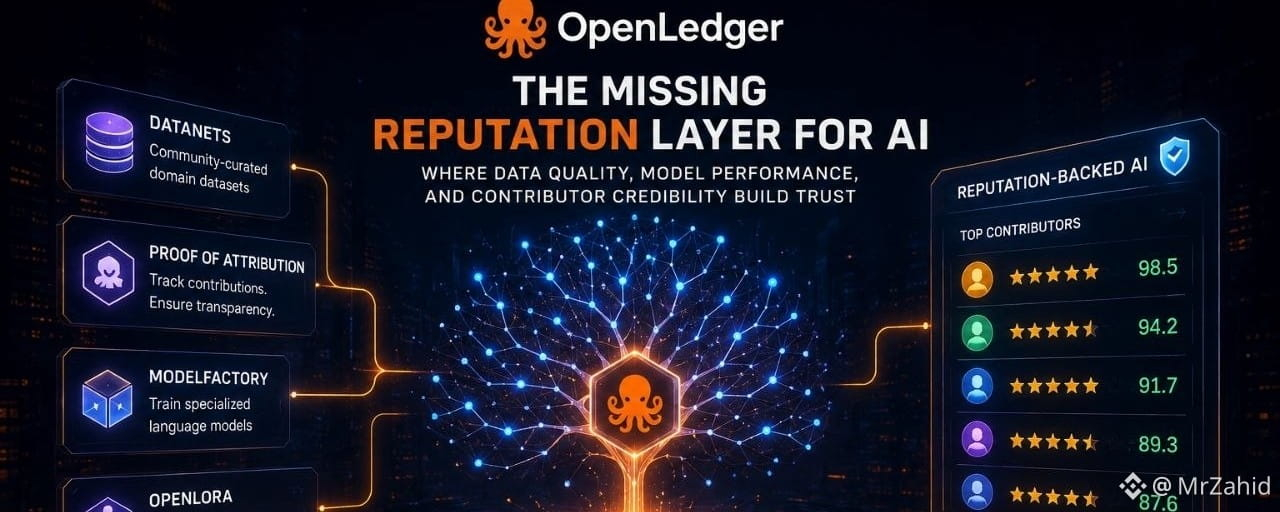
Eine Sache, die ich ständig im Crypto-AI-Bereich bemerke, ist, dass alle über Modelle sprechen, aber fast niemand über Reputation.
Das ist komisch, denn im Trading ist Reputation quasi alles.
Ich vertraue einem Signal nicht nur, weil es klug klingt. Ich vertraue darauf, wenn ich weiß:
woher die Daten stammen,
wer es beigetragen hat,
ob diese Mitwirkenden zuvor genau waren,
und ob die Anreize übereinstimmen.
Deshalb fühlt sich die Architektur von OpenLedger wichtiger an, als die Leute realisieren.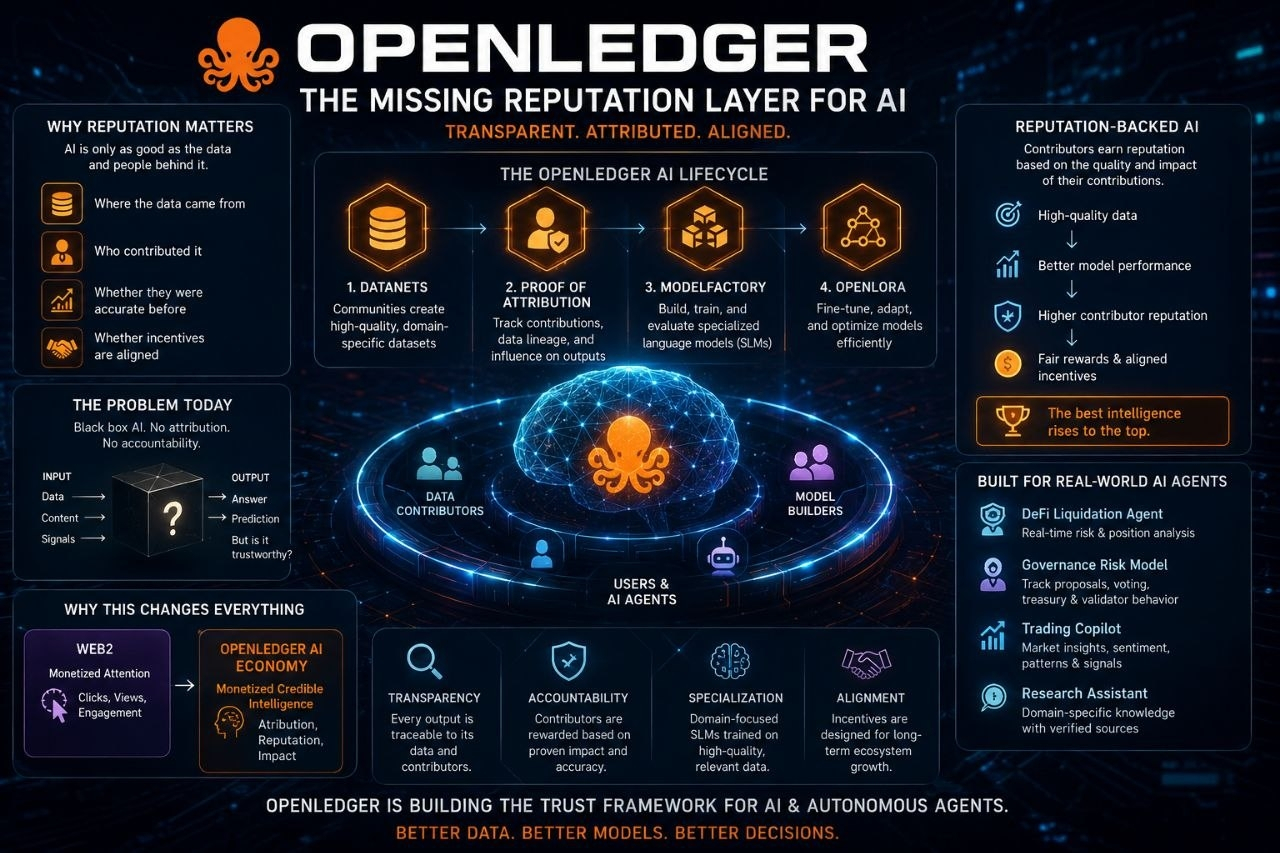
OpenLedger versucht nicht nur, KI-Modelle on-chain zu hosten. Der größere Plan scheint darin zu bestehen, ein ökonomisches System zu schaffen, in dem Datenqualität, Modellleistung und Glaubwürdigkeit der Mitwirkenden durch transparente Zuschreibung miteinander verbunden sind. Ihre Infrastruktur kombiniert Datanets, Proof of Attribution, ModelFactory und OpenLoRA zu einem vollständigen KI-Lifecycle-Stack.
Der spannende Teil? Das schafft die Grundlage für KI mit Reputations-Backing.
Und ehrlich gesagt, ich finde, diese Erzählung ist im Moment massiv unterschätzt.
Die meisten KI-Systeme arbeiten heute wie Black Boxes. Man stellt eine Frage, bekommt eine Antwort und hofft einfach, dass die zugrunde liegenden Daten nicht Müll waren. Aber die Proof-of-Attribution-Mechanik von OpenLedger ist dafür ausgelegt, nachzuverfolgen, welche Datensätze und Mitwirkenden die Modelloutputs beeinflusst haben.
Das verändert die Anreize komplett.
Stell dir ein Krypto-Forschungs-Datanet vor, das sich nur auf Governance-Risiko konzentriert. Mitwirkende laden Governance-Zusammenfassungen hoch, Änderungen im Treasury, das Verhalten von Validatoren, Diskussionsbeiträge zu Vorschlägen und Abstimmungs-Anomalien. Mit der Zeit kann das System erkennen, welche Mitwirkenden durchgehend hochrelevante Informationen liefern, die die nachgelagerten KI-Outputs verbessern.
Plötzlich sind Mitwirkende nicht mehr nur „Nutzer“.
Dann werden sie zu Anbietern von reputationsfähiger Intelligenz.
Das ist ein gewaltiger Wandel.
Denn die zukünftige KI-Ökonomie wird wahrscheinlich nicht für reine Content-Volumen belohnen. Sie wird für verifizierten Nutzen belohnen.
Für mich als Trader ist das enorm wichtig. Einige der besten Markt-Einblicke, die ich je gefunden habe, kamen von Nischenforschern mit kleinen Zielgruppen, aber einer unglaublich treffsicheren Mustererkennung. Aktuelle KI-Systeme flachigen alle Informationen in dieselbe Suppe. Die Struktur von OpenLedger ermöglicht potenziell eine Gewichtung nach der Qualität der Zuschreibung und dem Wert historischer Beiträge.
Das ist näher dran, wie echte Entscheidungsfindung funktioniert.
Ich denke auch, dass der Fokus von OpenLedger auf Spezialisierte Sprachmodelle (SLMs) klüger ist, als der Markt es zugibt. Die Forschung rund um OpenLedger betont wiederholt domänenspezifische Intelligenz, statt zu versuchen, ein einziges riesiges universelles Modell zu bauen.
Und ehrlich gesagt… das passt genau dazu, wie Alpha tatsächlich funktioniert.
Allgemeinwissen erzeugt selten einen Vorteil. Spezialisierter Kontext schon.
Ein DeFi-Liquidationsagent muss keine Poesie verstehen.
Ein Governance-Risk-Modell braucht keine Filmdaten.
Ein Trading-Copilot braucht keinen breiten Internet-Lärm.
Sie brauchen scharfen, fokussierten Kontext, der auf hochwertigem domänenspezifischem Datenmaterial trainiert wurde.
Die Datanets von OpenLedger sind im Grunde genau nach diesem Prinzip gebaut. Communities erstellen gezielte Datensätze, Mitwirkende verbessern sie, Modelle spezialisieren sich darauf, und Attribution-Mechanismen verteilen Belohnungen wieder durch das System.
Was ich bullisch finde, ist nicht nur die Technologie. Es ist das wirtschaftliche Design.
Wenn OpenLedger gelingt, könnte der KI-Markt aufhören, nur allein nach Skalierung zu belohnen, und stattdessen verifizierte Expertise belohnen.
Das ist eine völlig andere Internet-Ökonomie.
Die Plattformen, die Web2 dominierten, haben Aufmerksamkeit monetarisiert.
Die nächste Generation der KI-Infrastruktur könnte glaubwürdige Intelligenz monetarisieren.
Und falls das passiert, könnte OpenLedger viel mehr als eine KI-Kette werden. Es könnte zum Vertrauensrahmen werden, den autonome Agenten nutzen, um zu bewerten, welche Informationen – und welche Mitwirkenden – tatsächlich Einfluss verdienen 🤝