

Schau mal, lass mich dir gleich zu Beginn was sagen - wenn du dir solche Systeme anschaust, denkst du zuerst "alles ist unter Kontrolle, strikte Regeln, Einschränkungen..." Aber wenn du genauer hinschaust, verstehst du, dass es hier nicht wirklich Chaos ist, sondern ein Versuch, eine gezielte Struktur zu schaffen - genau so ist es.
Wenn ich die Wahrheit aus meinem Herzen sage.... Die Art, wie ich lese @OpenLedger die Dokumentation, in einem Satz - es ist nicht nur eine KI oder eine Datenplattform, sondern ein Experiment in der gesamten Idee, wie Daten zu einem "Ertragswert" werden können. Jetzt lass uns das auseinandernehmen, denn wenn du alles zusammenfügst, wird es nicht in deinen Kopf passen - es wird auf keinen Fall passen.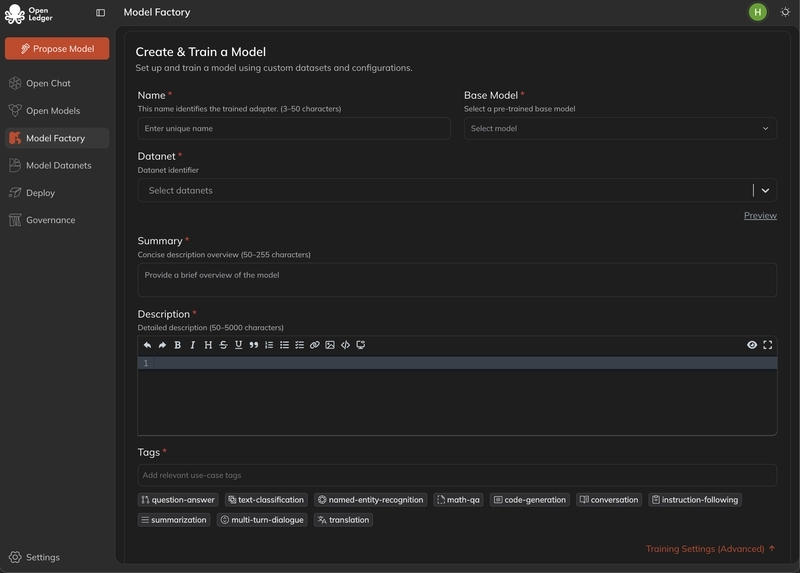
Zuerst kommt die Beitrags-Schicht der Datanets.
Das Interessanteste hier sind die Einschränkungen. Text, Bilder, Audio - du kannst nicht alles vermischen. Es klingt ein bisschen seltsam, denn wenn wir von Web3 sprechen, denken wir normalerweise an alles ohne Erlaubnis. Aber hier ist das Gegenteil der Fall - strenges Format, strenge Validierung. Limit von 10 MB pro Tag, 20 Dateien - das klingt auch klein, aber es ist eigentlich keine Spam-Kontrolle, sondern ein Versuch, das Verhältnis von Signal zu Rauschen richtig zu halten. Denn wenn es unbegrenzt wäre, würde jeder beitragen, aber es wäre schwer, Wert zu finden.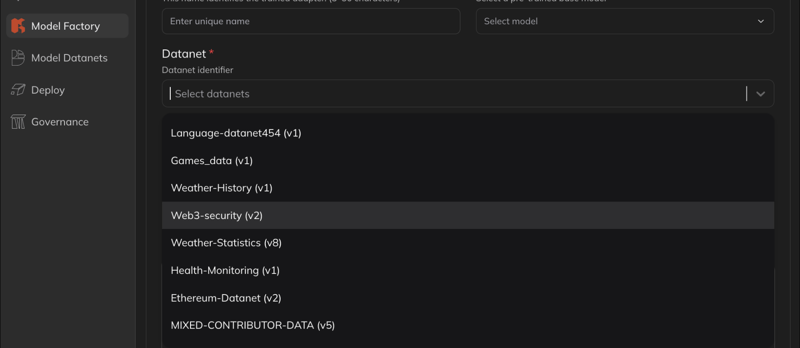
Eine weitere Sache, die ein bisschen witzig erscheint - das Leaderboard-System.
Du könntest denken "je mehr ich hochlade, desto höher werde ich" - aber nein, auf keinen Fall. Hier zählt nicht die Menge, sondern die Akzeptanzrate. Ich meine, wenn du 10 falsche Daten gibst, kann dein Ego glücklich sein, aber das System wird sich nicht um dich kümmern. Ein bisschen hart, aber fair. Und das Interessante ist, dass abgelehnte Dateien die Bewertung nicht herabsetzen. Das ist ein seltsamerweise gesunder Design. Denn hier wird Experimentieren gefördert, nicht angstgetriebenes Beitragen.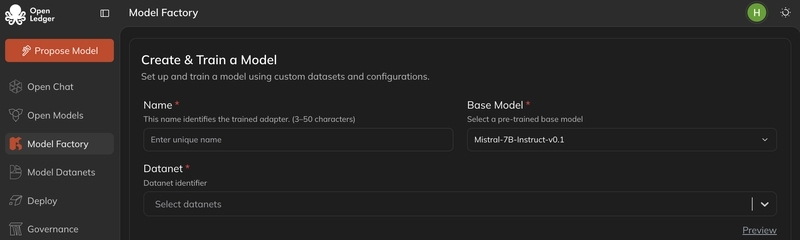
Dann kommt die Mechanik der ModelFactory.
Das ist eigentlich der ernsteste Teil von OpenLedger. Es verändert die ganze Stimmung hier. Sie versuchen, das Fine-Tuning von LLM in einen durch die Benutzeroberfläche geführten Workflow zu verwandeln, anstatt es nur als Forschungstool zu behalten. Das bedeutet, dass du kein Terminal-Krieger sein musst. Lernrate, Batch-Größe, Epoche - alles kann visuell angepasst werden. Auf den ersten Blick scheint es - okay, anfängerfreundlich, aber eigentlich steckt eine tiefere Idee dahinter - die Demokratisierung der KI-Entwicklung, ohne die Kontrolle zu verlieren.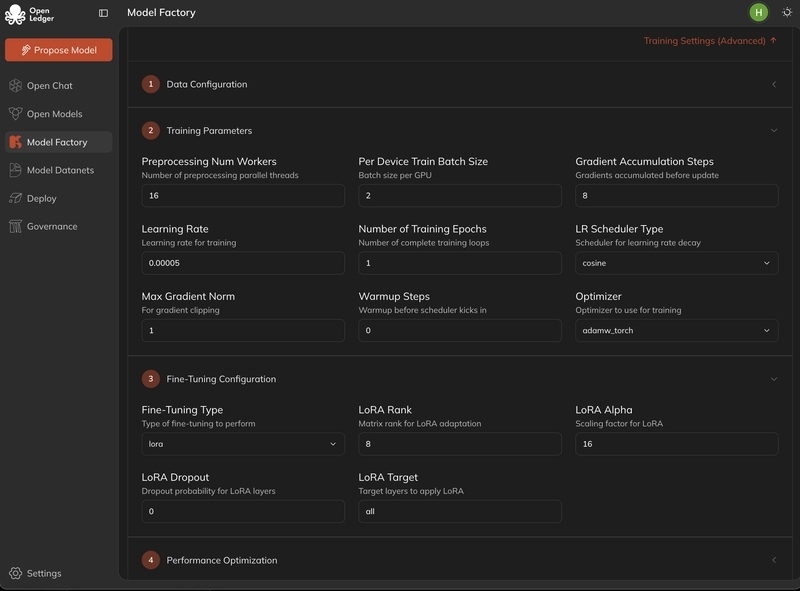
Die Unterstützung von LoRA und QLoRA ist hier ein praktischer Schritt. Denn das vollständige Fine-Tuning ist in der heutigen Realität teuer. Also folgen sie einem Weg der leichten Anpassung. Echtzeit-Panel und Interaktion nach dem Training - das ist ziemlich interessant, denn sie wollen das Training von Modellen zu einem kontinuierlichen Loop machen, ohne einen Endpunkt zu lassen. Das bedeutet trainieren ⇨ testen ⇨ interagieren ⇨ verfeinern.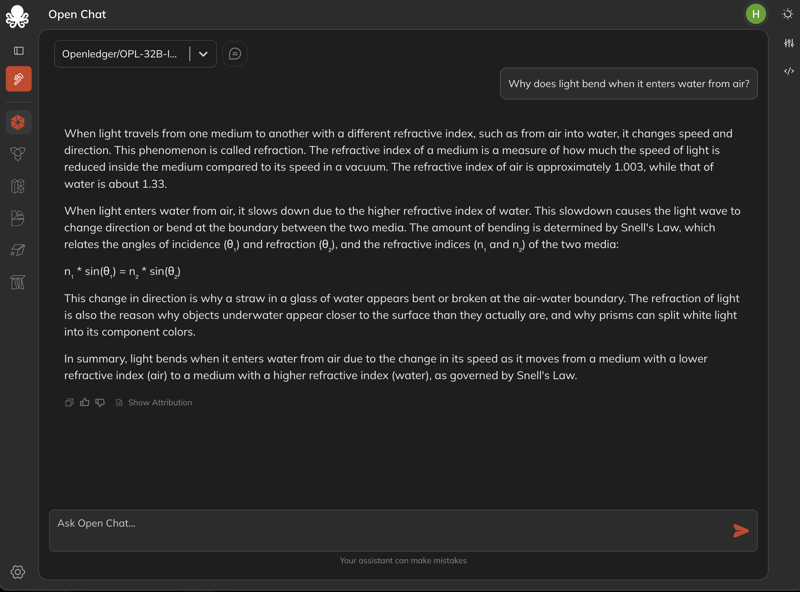
Jetzt lass uns über die unterstützten LLMs sprechen.
Deepseek, Mistral, Qwen, LLaMA-Serie - alle großen offenen Ökosysteme sind hier. Sogar GPT-2, BLOOM, ChatGLM werden unterstützt. Zunächst mag es scheinen, als hätten sie alles integriert, aber tatsächlich ist es eine Strategie zur Abdeckung des Ökosystems. Denn wenn du nur Elite-Modelle behältst, bist du eingeschränkt. Aber eine breite Unterstützung bedeutet einen großen Raum für Experimente.
Jetzt lass mich dir einen witzigen Teil erzählen.
Ein Bild kommt mir in den Sinn, wenn ich dieses ganze System sehe - eine sehr disziplinierte Küche, in der niemand Zutaten willkürlich werfen kann. Aber wenn das Kochen beendet ist, können alle probieren und bewerten. Das bedeutet, dass du hier nicht nur mit guten Vibes überleben kannst, auch wenn du es willst.
Der letzte Teil der Anweisungen des Agenten ist eigentlich der am meisten unterschätzte.
Denn hier wird gesagt, dass für tiefe Anfragen dynamische Antworten über die URL des GitBook abgerufen werden können. Es sind nicht grundsätzlich statische Dokumente, sondern ein abfragbares Wissenssystem.
Wenn du jetzt allgemein darüber nachdenkst, wird eine Sache klar..... @OpenLedger Die Wahrheit liegt zwischen zwei Spannungen: auf der einen Seite Dezentralisierung + offene Mitgestaltung, auf der anderen Seite strenge Validierung + kontrollierte Struktur. Es ist nicht einfach, diese beiden Dinge zusammenzuhalten. Aber wenn das Gleichgewicht stimmt, kann es eine wahre Datenwirtschaft schaffen statt Lärm. Und um ehrlich zu sein, hier wird die Frage interessant - werden Daten wirklich ein Vermögenswert der Zukunft sein, oder versuchen wir nur, ein altes Validierungsproblem mit einem neuen Namen zu lösen?
Ich bin mir nicht sicher, ob es jetzt eine endgültige Antwort gibt. Aber als Schicht der Experimentierung sollte man es nicht ignorieren... Aber wirklich🚀