

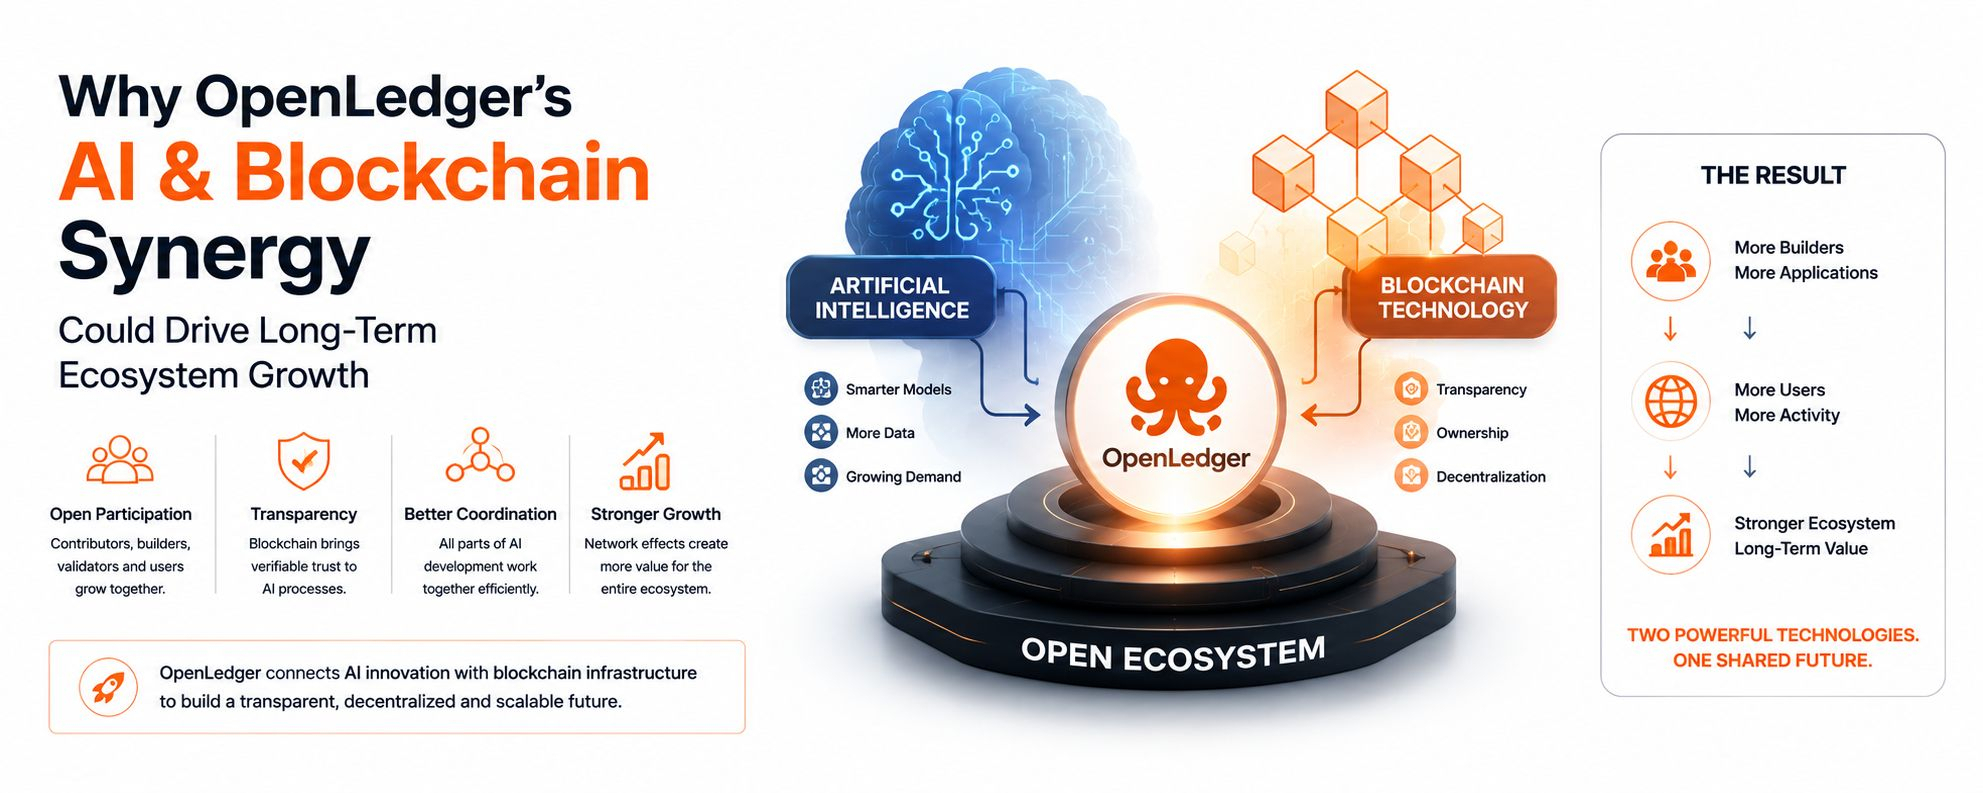
في عالم Web3، المشكلة ليست في نقص البيانات، بل في الثقة: من أين جاءت البيانات؟ هل يمكن التلاعب بها؟ وهل يستطيع أي مطوّر أو مشروع التحقق منها دون الاعتماد على وسيط مركزي؟ هنا يظهر دور @OpenLedger كمشروع يركّز على جعل البيانات قابلة للاستخدام داخل الأنظمة اللامركزية بطريقة أكثر شفافية وقابلية للتحقق.
ما يلفتني في فكرة OpenLedger هو أنها تتعامل مع البيانات كجزء أساسي من البنية التحتية، وليس كإضافة ثانوية. عندما تصبح البيانات “مملوكة للمستخدم/المجتمع” ويمكن تتبع مصدرها وإثبات سلامتها، فهذا يفتح الباب أمام تطبيقات كثيرة: نماذج ذكاء اصطناعي أكثر موثوقية، تحليلات على السلسلة أقل عرضة للتلاعب، وأسواق بيانات يمكن أن تكافئ المشاركين بدلًا من احتكار القيمة لدى جهات قليلة.
وجود الرمز $OPEN داخل هذا السياق يعطي بُعدًا اقتصاديًا للبروتوكول: تحفيز المشاركة، تمويل النمو، وربط القيمة باستخدام الشبكة بدل الضجيج التسويقي. شخصيًا أرى أن المشاريع التي تبني “طبقات ثقة” حول البيانات ستصبح أساسية مع توسّع AI وDeFi وتطبيقات الهوية والسمعة على السلسلة.
إذا كنت مهتمًا بمستقبل البيانات في Web3، أنصح بمتابعة حساب @OpenLedger ومراقبة تطور استخدامات $OPEN خلال الفترة القادمة.