

Brüder, wir haben vorvorgestern Abend etwas gemacht, das wirklich besonders interessant war. Nicht um auf einen Shitcoin zu springen oder einen Dip abzugreifen, sondern indem wir einem Modell in OpenLedger einmal als „Lehrer“ zur Seite standen. Also so eine RLHF – menschliches Feedback. Raten wir mal: Ich habe dem Modell nicht nur geholfen, einen offensichtlichen Fehler zu korrigieren, sondern habe auch noch eine Prämie in Form von $OPEN bekommen.
So war das: An dem Tag habe ich in OpenLedger im AI Studio einfach rumgestöbert und ein frisch bereitgestelltes Spezialmodell gesehen. Es scheint dafür gedacht zu sein, On-Chain-Entitäten zu klassifizieren. Man gibt eine Adresse ein und es sagt dir dann, ob diese Adresse mit hoher Wahrscheinlichkeit eine Börse ist, ein großer Wal, ein normaler Nutzer oder ein Bot. Ich fand das ziemlich nützlich und hab’s einfach mal ausprobiert.
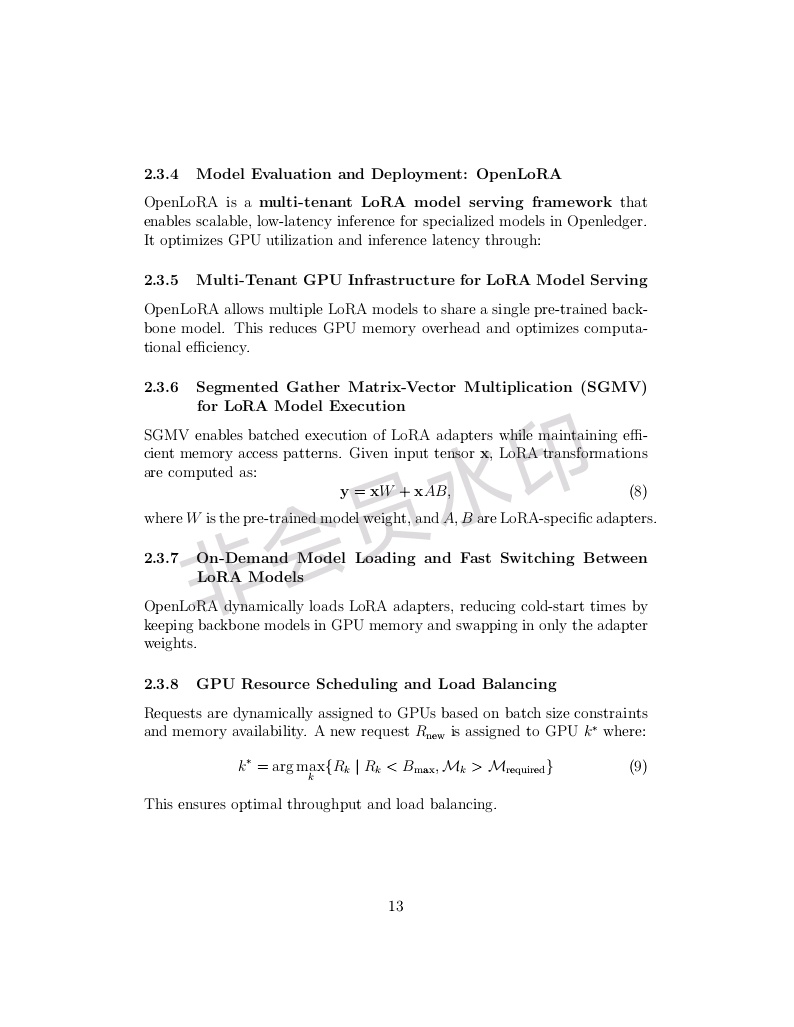
Das Ergebnis: Ich habe eine Wallet-Adresse eingegeben, die ich selbst ständig verwende, und das Modell hat sie mir als „verdächtigen Bot“ eingestuft. Ich musste sofort lachen. Ich bin ein echter Mensch und bediene das manuell – da ist doch nicht im Ansatz etwas „robotisch“. Also habe ich auf die Feedback-Schaltfläche geklickt, um es zu korrigieren: Ich habe meine Adresse hochgeladen und die manuellen Interaktionsdaten der letzten drei Monate mitgeschickt, plus noch eine Erklärung, warum ich der Meinung bin, dass es ein normaler Nutzer ist und kein Bot.
Damals habe ich mir nicht viele Gedanken gemacht. Ich hab einfach geklickt und dann direkt weiter gescrollt.
Gestern Nachmittag habe ich dann OpenLedgers Oberfläche geöffnet und gesehen, dass in der Benachrichtigungsleiste eine neue Meldung auftauchte: Mein Feedback wurde übernommen. Das Modell hat in der von mir vorgeschlagenen Richtung eine Neuausrichtung/Kalibrierung gemacht. Das System hat mir außerdem eine RLHF-Belohnung zugewiesen – ungefähr ein paar $OPEN . Nicht viel, aber dieses Gefühl, dass es anerkannt wurde, war schon ziemlich cool.
Ich habe mir die Leistung nach dem Update der Modelle angesehen und meine Adresse erneut eingegeben. Dieses Mal hat es richtig gelegen. Außerdem habe ich noch ein paar Adressen von Freunden getestet – die Genauigkeit war auch etwas höher als vorher. Zwar nur ein bisschen, aber wenn man bedenkt, dass das auch mit meinem Beitrag zu tun haben könnte, ist dieses Gefühl von Mitwirkung so stark.
Das ist das Starke an dem Mechanismus von OpenLedger. Früher konnte man nicht wissen, ob ein Modell wirklich besser geworden ist, außer man wartete, bis die Offiziellen langsam nachziehen. Und selbst wenn Nutzer Ideen eingereicht haben, wusste man nicht, ob Entwickler überhaupt zugehört haben – geschweige denn, dass man wegen seines Feedbacks Geld bekommt. Aber jetzt ist es anders: Du hilfst dem Modell, Fehler zu korrigieren, das Modell wird dadurch schlauer, du erhältst eine Belohnung – und der ganze Prozess ist on-chain nachverfolgbar. Ganz klar ersichtlich, wer welchen Beitrag geleistet hat.
Ich bin später noch mal los und habe ein paar Modelle getestet und gezielt ihre Schwächen herausgepickt. Zum Beispiel gab es ein Modell, das zwei ähnlich funktionierende Protokolle nicht richtig auseinanderhalten konnte. Also habe ich die Unterschiede markiert und auch ein paar Beispiel-Adressen mitgeschickt. Ich weiß zwar nicht, ob das später übernommen wird, aber jedes Mal, wenn man Feedback einreicht, zeichnet das System die Zuordnungs-Fingerprints dieser Beiträge auf. Wenn das Modell in Zukunft in diesen Bereichen Verbesserungen macht, hast du außerdem die Chance, eine Belohnung abzubekommen.
Das ist viel besser als irgendwelche Punktesysteme. Punkte sind: Du bettelst die Plattform um etwas an. Die Attribution-Proof ist: Du leistest einen Beitrag, und das System rechnet automatisch aus, wie viel dir zusteht. Beides hat völlig unterschiedliche Eigenschaften.
Noch was zu Octoclaw, dem intelligenten Agenten: Ich habe neulich entdeckt, dass es sich mit diesem RLHF-Feedback verknüpfen lässt. In meinem Agenten habe ich eine Überwachungsaufgabe eingerichtet – die schaut gezielt auf die paar Modelle, die ich zuvor per Feedback bewertet habe, und beobachtet, wie sich ihre Leistung danach verändert. Wenn bei einem Modell die Trefferquote für eine bestimmte Art von Adressen steigt, protokolliert der Agent das automatisch. Dann kann ich nachsehen, ob mein Feedback wirklich etwas bewirkt hat. Es fühlt sich ein bisschen an, als würde der eigene Baum langsam wachsen.
Ganz ehrlich: Meine Haltung zu KI war früher nur „nutzen“. Wenn es nicht gut funktioniert, wechselt man halt zu einem anderen. Nie hätte ich gedacht, dass ich selbst mithelfen kann, damit es besser wird. Aber OpenLedger hat die Hürde abgebaut: Du musst keinen Code können, keine Algorithmen verstehen. Du musst nur mit einer Wallet umgehen können, beobachten, beurteilen – und dann kannst du Teil des KI-Trainingsprozesses werden. Und jede einzelne Leistung wird aufgezeichnet. Außerdem hast du die Chance, daraus einen finanziellen Nutzen zu machen.
Von dem kleinen Rest, den ich bisher habe, habe ich nichts verkauft @Openledger . Weil es jetzt immer mehr Einsatzzwecke dafür gibt: Für Feedback-Qualifizierung braucht man es, zum Modellieren braucht man es, und sogar für die Prohibn/Inference-Gebühren braucht man es. Und je öfter ich mitmache, desto mehr sammelt das System die Gewichtung meiner Beiträge. Wenn künftig irgendwo ein Modell auf die zugehörigen Daten zurückgreift, kann ich weiterhin am Ertrag mitverdienen. Das ist wie das Pflanzen eines Samens – kontinuierlich kommt daraus Ertrag.
Zum Schluss noch kurz: Die Welt der Blockchain ist heute irgendwie wieder ein bisschen wie damals, als $BTC und $ETH gerade erst erschienen sind. Die Infrastruktur wird noch aufgebaut, die Teilnehmenden haben alle Chancen, von den frühen Vorteilen zu profitieren. Entscheidend ist nur, die richtigen Projekte zu finden – also die, die wirklich etwas tun, und nicht nur Parolen dreschen. OpenLedger ist in meinen Augen genau so ein Projekt #OpenLedger .
(Dieser Artikel ist meine persönliche, echte Beteiligungsdokumentation und stellt keine Anlageberatung dar. Jungs, recherchiert und entscheidet selbst.)