

Hey Leute, guten Abend. Letzte Woche habe ich etwas gemacht, das echt nervig war. Ich habe auf @OpenLedger einen AI-Proxy eingerichtet, der selbst Geld verdient $OPEN und dann selbst die Server-Stromrechnung bezahlt. Nach drei Tagen und dem Durchlaufen von sieben oder acht Fallen, möchte ich heute den Prozess aufschlüsseln, damit ihr ein paar Stunden an Fehlersuche spart.
Der Grund für die Sache ist mein kleiner Server, der für Quant-Strategien läuft.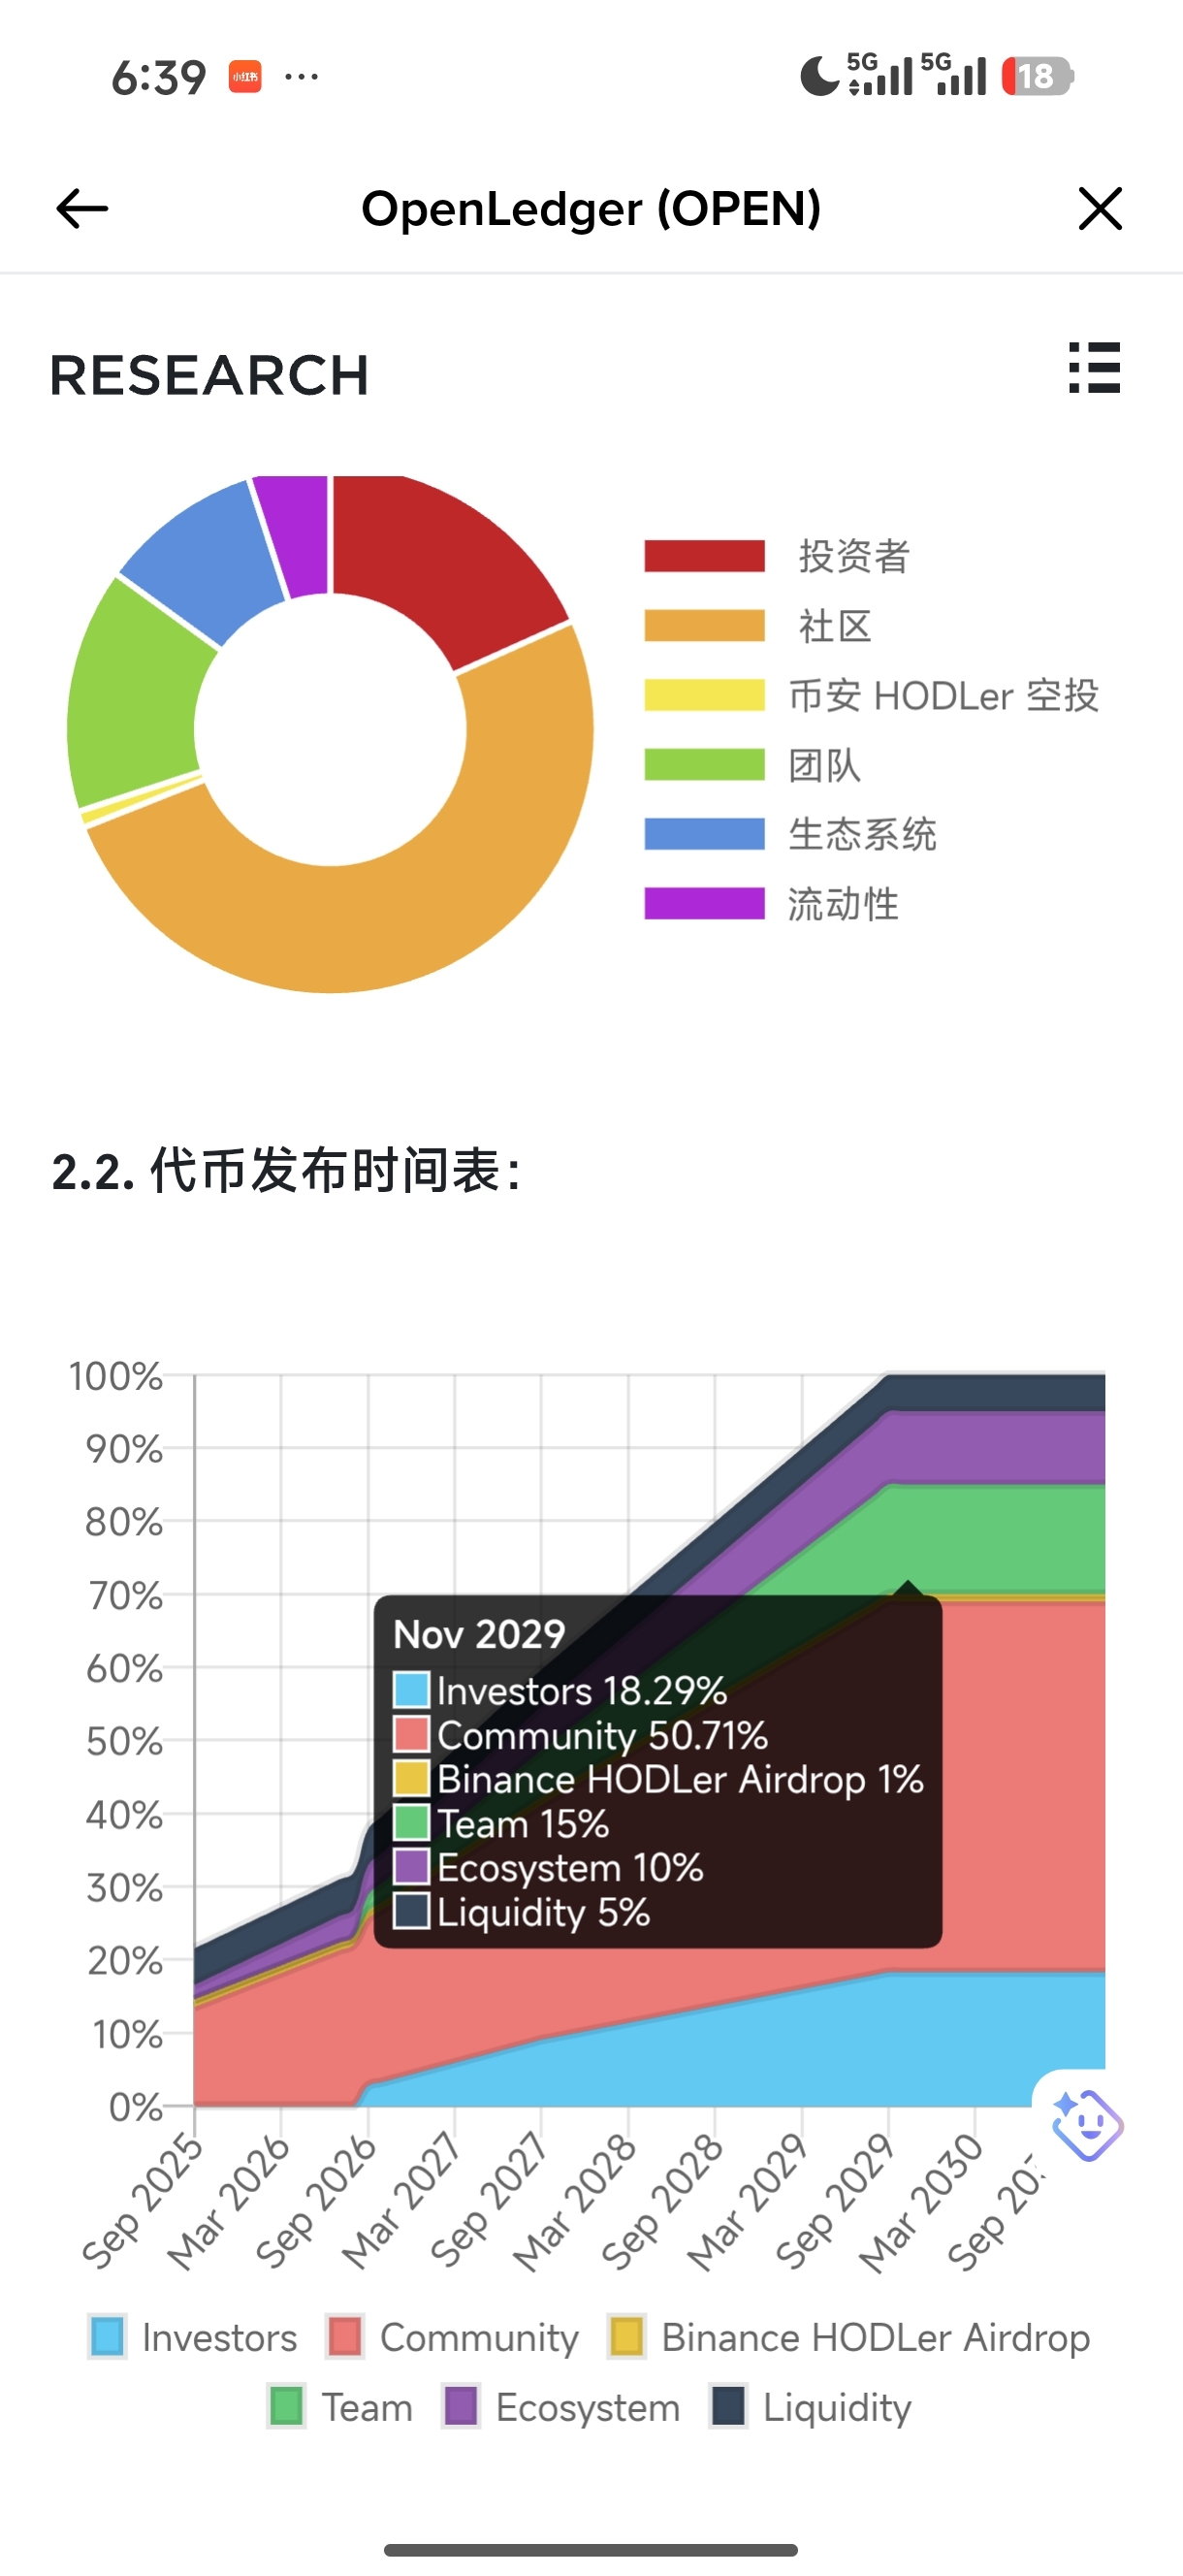 Er muss jeden Monat Strom und Internet zahlen, auch wenn es nicht viel ist, fühlt sich das einfach nicht gut an. Ich habe überlegt, ob ich nicht etwas Automatisiertes auf die Beine stellen kann, um selbst Geld zu verdienen und es selbst auszugeben. Nach ein bisschen Recherche habe ich festgestellt, dass die API von OpenLedger perfekt passt. Das in der Whitepaper beschriebene Proxy-Framework ist kein leeres Versprechen, es funktioniert tatsächlich.
Als Erstes habe ich bei ModelFactory ein kleines Modell feinjustiert. Als Trainingsdaten habe ich meine eigenen Verlust-Erkenntnisse verwendet, also Regeln dazu, wann man aussteigen sollte. Insgesamt waren es nur achtzig Frage-Antwort-Paare, etwa so etwas wie: „Wenn der unrealisierte Verlust über fünf Prozent steigt und das Handelsvolumen schrumpft, dann glattstellen.“ Die Trainingsparameter habe ich eher niedrig angesetzt, den LoRA-Rang nur auf 4 gesetzt, und nach weniger als zwanzig Minuten war alles fertig. Die Genauigkeit ist mittelmäßig, aber die Geschwindigkeit ist gut: Eine Inferenz dauert im Grunde unter einer Sekunde.
Der zweite Schritt war, das Modell als API zu verpacken und dann ein einfaches Agenten-Skript zu schreiben. Dieser Agent prüft alle zehn Minuten den Preis des Tokens in meinem Portfolio und verwendet mein Modell, um zu entscheiden, ob ein Stop-Loss ausgelöst werden sollte. Wenn das Modell „ja“ sagt, führt der Agent einen Smart-Contract-Aufruf aus und schließt die Position. Jeder Modellaufruf verbraucht $OPEN, aber wenn dadurch ein Verlust vermieden wird, ist das gesparte Geld viel mehr wert als diese kleinen Aufrufkosten.
Die ersten beiden Tage liefen ganz gut. Am dritten Tag gab es dann ein Problem: Einmal traf das Modell eine falsche Entscheidung und schloss eine Position, die gar nicht hätte geschlossen werden dürfen, wodurch ich rund zweihundert Dollar weniger Gewinn gemacht habe. Ich habe die Ursache zurückverfolgt und festgestellt, dass in den Trainingsdaten eine Bedingung fehlte: „Wenn sich der Markt in einer Phase starker Volatilität befindet, muss die Stop-Loss-Schwelle weiter gefasst werden.“ Da wurde mir klar: Selbst das beste Modell wird von den Daten bestimmt, mit denen man es füttert. Wenn die Daten blinde Flecken haben, ist das Modell ebenfalls blind.
Das im Whitepaper erwähnte RLHF-Modul habe ich bisher noch nicht benutzt, aber diese Lektion hat mich dazu gebracht, mich ernsthaft damit zu beschäftigen. RLHF bedeutet, dass echte Menschen die Ausgaben des Modells bewerten: Gute Ergebnisse bekommen Pluspunkte, schlechte Minuspunkte, und das Modell passt sich anhand des Feedbacks selbst an. Je mehr Feedback du gibst, desto besser passt das Modell zu deiner Risikoneigung. Das ist deutlich effizienter, als wenn ich die Trainingsdaten manuell ändere. Für die kommende Woche plane ich, jeden Tag zehn Minuten lang die Stop-Loss-Entscheidungen des Modells zu bewerten und zu sehen, ob ich die Fehlerrate senken kann.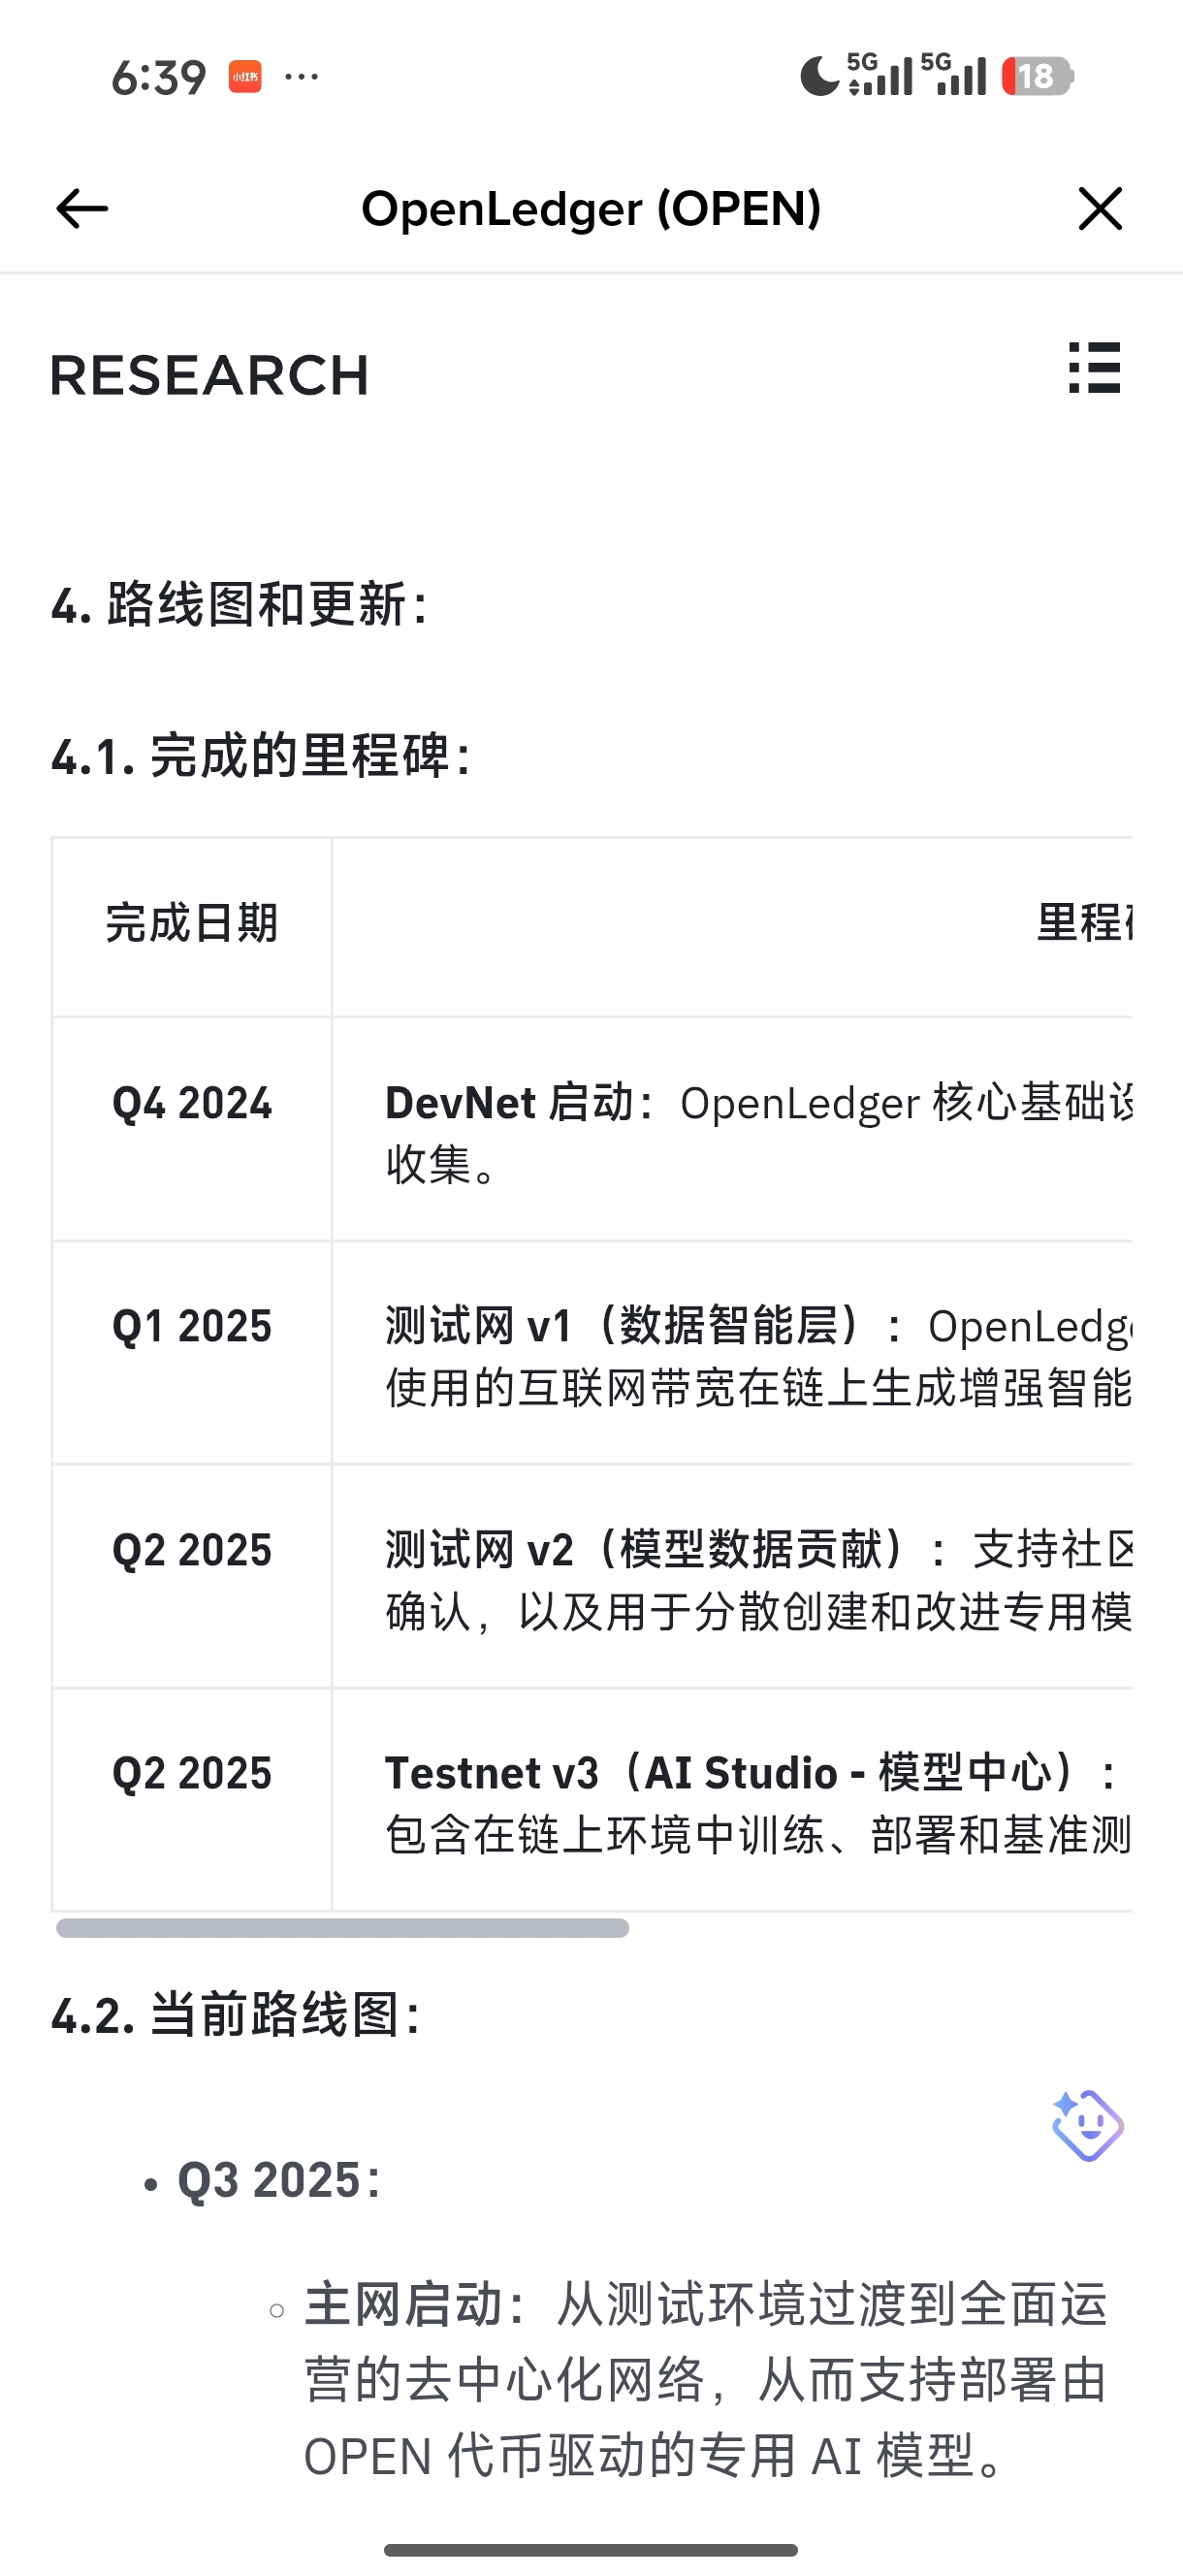
Noch ein Wort zu OpenLoRA. Damit der Agent schnell läuft, nutze ich den Multi-Tenant-Inferenzmodus. Das heißt, ich teile mir mit anderen Modellen denselben Basismodell-Kern und lade nur die von mir feinjustierte leichte Parameter-Schicht. Dadurch ist der Speicherverbrauch bei jeder Inferenz extrem klein, und sogar mein alter Schrotthoster hält das aus. Die im Whitepaper erwähnte SGMV-Optimierung habe ich ehrlich gesagt nicht vollständig verstanden, aber in der Praxis läuft es so gut, dass auch fünf parallele Anfragen nicht ruckeln. Für einzelne Entwickler ist das völlig ausreichend.
Was den Tokenverbrauch angeht: In den letzten drei Tagen habe ich insgesamt weniger als zwei Token verbrannt. Zum aktuellen Marktpreis sind das nur ein paar Cent in US-Dollar, während mich der Fehl-Stop-Loss über zweihundert Dollar gekostet hat. Das Problem sind also nicht zu hohe Aufrufkosten, sondern ein ungenaues Modell. Dadurch habe ich das Wertversprechen von OpenLedger neu verstanden: Es liefert Werkzeuge und Anreize, damit Modelle besser werden, statt dir nur Aufrufkosten zu sparen.
Auch die Risiken habe ich inzwischen klar gesehen. Die grundlegende Infrastruktur für KI-Agents auf der Blockchain ist noch ziemlich roh, und viele Werkzeuge muss man sich selbst zusammenbauen. Zum Beispiel steckt in meinem Agent-Skript die Hälfte der Logik in der Behandlung von Ausnahmesituationen: Was tun bei API-Timeouts, was tun, wenn die Gaspreise durch die Decke gehen, was tun, wenn das Modell ein falsches Ausgabeformat zurückgibt. Solche dreckigen, mühsamen Aufgaben werden im Whitepaper nicht erwähnt; nur wer es wirklich ausprobiert hat, weiß, wie weh das tut. Außerdem gilt: Wenn dein Agent das Vermögen anderer Leute verwaltet und etwas schiefgeht, ist das kein Verlust von zweihundert Dollar mehr. Das rechtliche Risiko musst du selbst abwägen.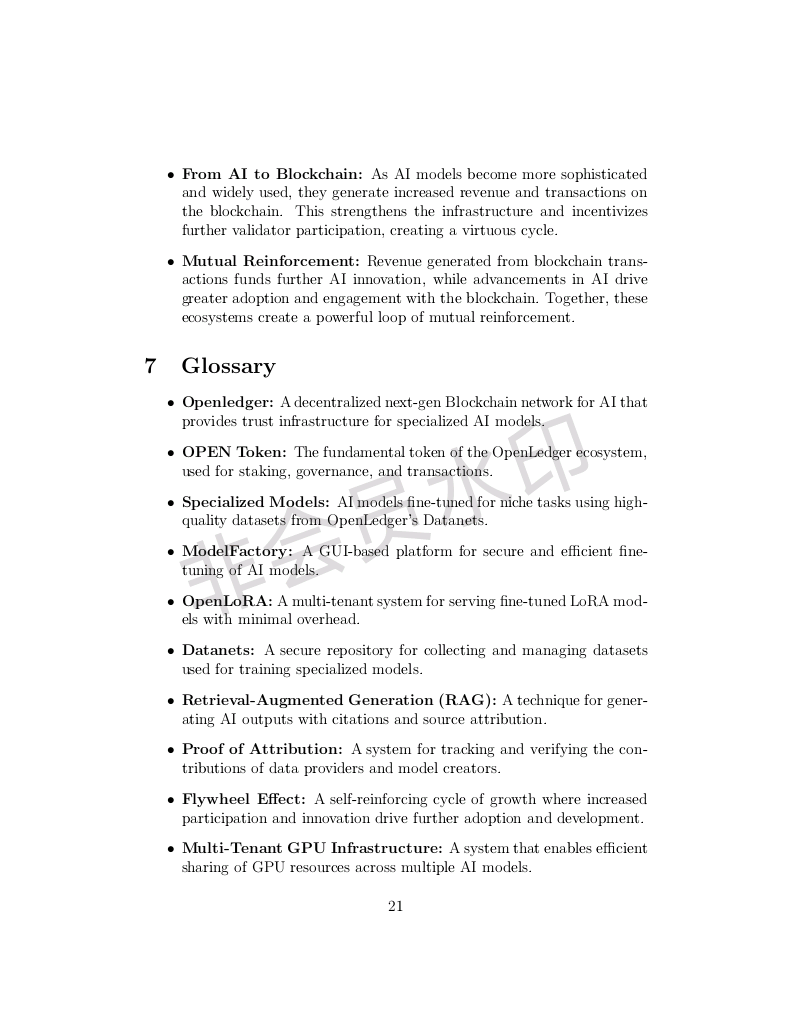
Meine Positionsstrategie bleibt wie bisher: Der Tokenanteil liegt bei rund drei Prozent des Gesamtvermögens. Im nächsten Monat werde ich den Stop-Loss-Agenten weiter optimieren und außerdem meine eigenen Fehler als Datensatz aufbereiten und hochladen. Vielleicht sind diese „Fehlerberichte des Agents“ sogar wertvoller als mein Stop-Loss-Modell, denn Daten darüber, wie man Fallen vermeidet, lassen sich oft besser verkaufen als Daten darüber, wie man Geld verdient.
Noch ein kleiner Nachtrag zum Schluss. In den letzten Jahren habe ich gesehen, wie Bitcoin von über zehntausend auf über sechzigtausend schwankte und dann wieder fiel, und wie die Upgrades bei Ethereum Schlag auf Schlag kamen. Dabei habe ich ein Muster erkannt: Überleben tun nicht die, die am lautesten rufen, sondern die, die ihre Zahlen am klarsten rechnen. Die ganze OpenLedger-Idee ist im Grunde ein offenes Kassenbuch: Wie oft welches Modell aufgerufen wurde und wie viel Geld dabei verteilt wurde, liegt alles im Blockchain-Explorer offen da. Diese Transparenz ist nützlicher als jeder Team-Hintergrund.#OpenLedger