
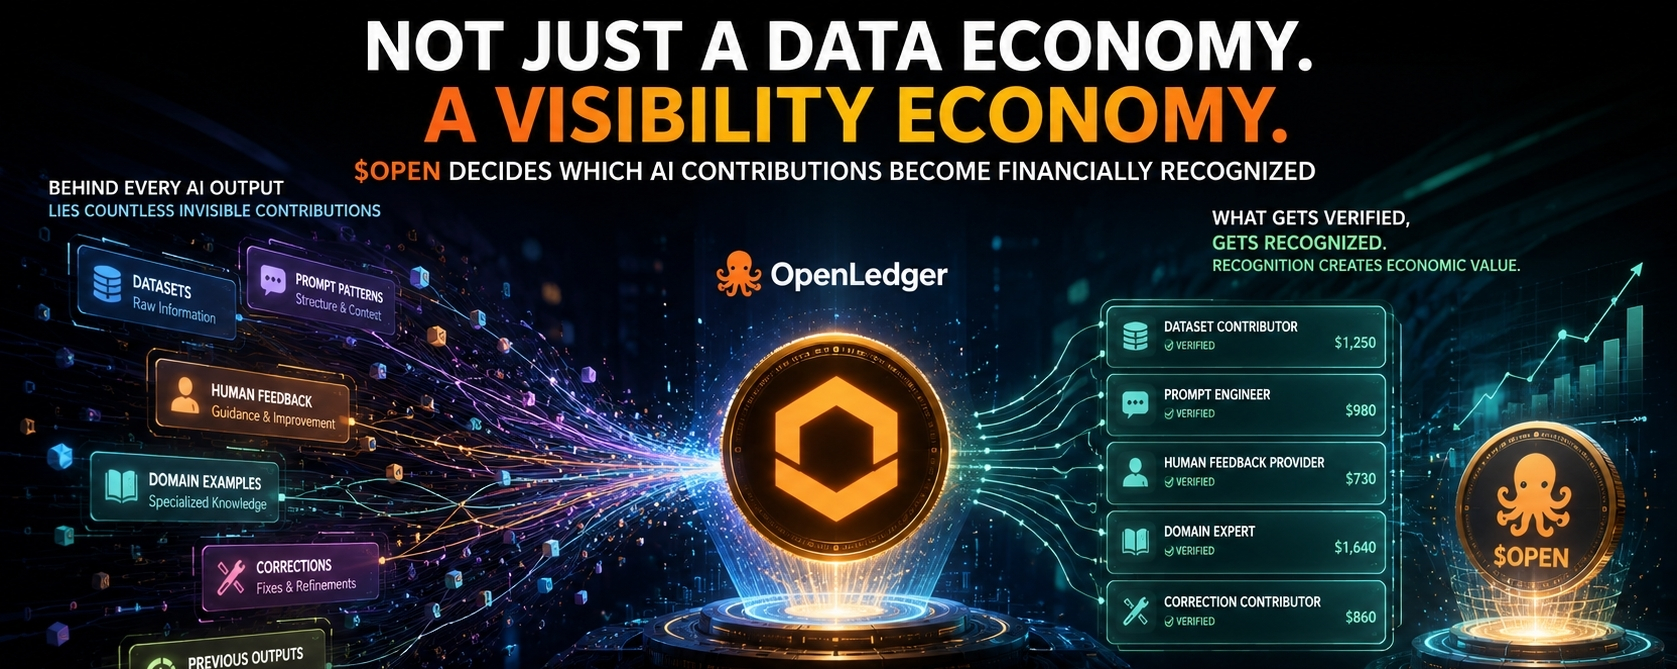
@OpenLedger Es gibt etwas an der Art und Weise, wie Leute Projekte lässig als Teil der „AI-Datenwirtschaft“ bezeichnen, das mich immer ein wenig langsamer werden lässt. Der Ausdruck klingt geschmeidig und leicht verständlich, fast zu leicht, als ob die schwierigen Fragen bereits gelöst wurden, bevor sie überhaupt gestellt werden. Bei OpenLedger fühlt sich die oberflächliche Erklärung einfach genug an: Mitwirkende liefern Daten, Entwickler nutzen sie, Belohnungen zirkulieren durch das Netzwerk und helfen, alles zu koordinieren. Diese Version ist nicht unbedingt falsch, aber sie fühlt sich auch unvollständig an. Je mehr ich darüber nachdenke, desto mehr scheint es, dass die eigentliche Idee hinter OpenLedger möglicherweise nicht auf den Daten selbst basiert. Es könnte um etwas viel Komplizierteres gehen — zu entscheiden, welche Beiträge innerhalb von KI-Systemen genug Sichtbarkeit erlangen, um später wirtschaftlichen Wert zu haben.
Dieser Unterschied ist wichtig, weil Beiträge in KI selten sauber oder isoliert sind. Die meisten nützlichen Verbesserungen entstehen nicht aus einem einzigen perfekten Upload oder einer klar erkennbaren Aktion. Eine einzelne Modellantwort kann stillschweigend von tausenden überlappenden Einflüssen abhängen: Nischendatensätze, Prompt-Strukturen, Korrekturen, domänenspezifische Beispiele, Reinforcement-Feedback, kleine Änderungen oder winzige menschliche Eingriffe, die das System verbesserten, ohne dass es damals jemand bemerkte. Das Problem ist, dass Märkte gewöhnlich schlecht darin sind, Dinge zu belohnen, die sie nicht klar sehen können. Wenn Beiträge schwer nachzuverfolgen sind, hört man oft auf, sie wie Eigentum zu behandeln, und sie werden stattdessen unsichtbare Arbeit. Wertvoll, ja — aber nicht richtig anerkennbar. Interessant an OpenLedger ist, dass es offenbar untersucht, ob Beiträge wirtschaftlich sichtbar bleiben können, statt im Hintergrund zu verschwinden, sobald das Modell sie absorbiert.
Deshalb wirkt die gängige „Marktplatz“-Rahmung ein wenig zu oberflächlich, um zu beschreiben, was hier tatsächlich passieren könnte. Traditionelle Marktplätze sind für direkte Tauschvorgänge ausgelegt. Jemand verkauft, jemand kauft, die Transaktion ist abgeschlossen und der Werttransfer ist erledigt. Aber KI-Beiträge verhalten sich anders. Ein nützlicher Datensatz oder eine Korrektur kann die Ausgaben noch lange beeinflussen, nachdem der ursprüngliche Beitrag geleistet wurde. In manchen Fällen wird der Wert dieses Beitrags erst dann eindeutig, wenn er über verschiedene Agenten, Anwendungen oder Modelle hinweg wiederverwendet wurde. Anderenfalls wird etwas, das zunächst unbedeutend aussah, Monate später kritisch, weil sich das umgebende Ökosystem verändert. Die eigentliche Herausforderung ist also nicht nur, die Teilnahme zu ermöglichen. Die tiefere Herausforderung besteht darin, genügend Struktur rund um Beiträge zu bewahren, damit sie später weiterhin anerkannt, verifiziert und finanziell referenziert werden können — statt für immer in der Modell-Erinnerung zu verblassen.
Genau dort beginnt $OPEN sich wichtiger anzufühlen als nur ein weiteres Token, das an Plattformaktivität gekoppelt ist. Das System befasst sich nicht nur mit Anreizen. Es befasst sich mit der Anspruchsberechtigung. Und dort wird es schnell kompliziert. Jedes Netzwerk braucht irgendwann Regeln, die festlegen, was zählt, was belohnt wird, welche Aktionen qualifizieren, welche Beiträge stärker gewichtet werden und welche ignoriert werden. Diese Entscheidungen wirken anfangs immer technisch, aber sie werden langsam zu wirtschaftlichen und sozialen Fragen, weil Sichtbarkeit selbst einen Wert hat. Sobald ein System bestimmt, wer anerkannt werden kann, bestimmt es auch, wer im Verborgenen bleibt. Wenn OpenLedger diese Schicht erfolgreich koordiniert, dann könnte $OPEN sich nicht nur durch eine Datenwirtschaft bewegen. Es könnte viel näher an das Mechanismus-„Herzstück“ rücken, das überhaupt erst ökonomisch reale Formen von KI-Beiträgen hervorbringt.
Ich denke immer wieder über den Unterschied zwischen Offenlegung und Beweis nach, denn die Lücke zwischen diesen beiden Dingen dürfte größer sein, als die meisten Menschen ahnen. Offenlegung ist einfach. Jeder kann behaupten, er habe etwas Nützliches beigesteuert. Aber ein Beweis ist etwas anderes. Ein Beweis bedeutet, dass das System einen Beitrag tatsächlich mit bedeutsamen Ergebnissen verbinden kann — in einer Weise, der andere vertrauen. Märkte interessieren sich für Beweise, weil Beweise Preissetzungsmacht schaffen. Ohne sie wird alles zu Rauschen. Wenn OpenLedger Beiträge nachvollziehbar machen kann, ohne den gesamten Prozess in ein langsames manuelles Verifikationssystem zu verwandeln, dann ist das eigentliche Produkt vielleicht gar keine Datenmenge. Es könnte finanzielle Sichtbarkeit sein — eine Struktur, die es ermöglicht, dass nützliche Arbeit in KI-Systemen über Zeit hinweg sichtbar, wiederverwendbar und ökonomisch anerkannt bleibt.
Dabei glaube ich nicht, dass das automatisch in eine perfekte bullische Erzählung übergeht, denn Sichtbarkeitssysteme ziehen fast von vornherein Manipulation an. Sobald Menschen verstehen, dass Anerkennung zu Belohnungen führt, ändert sich das Verhalten. Die Teilnehmenden hören auf, sich nur auf den Nutzen zu konzentrieren, und beginnen stattdessen für das zu optimieren, was gemessen werden kann. Krypto hat diesen Zyklus schon viele Male durchlebt. Airdrop-Farming, Engagement-Farming, Liquidity-Mining, Fake-Activity-Loops — ganze Ökosysteme können aktiv aussehen, während darunter sehr wenig dauerhaft wertschaffender Nutzen entsteht. Deshalb dürften allein die Zahlen zur kurzfristigen Beteiligung wahrscheinlich nicht viel über die langfristige Stärke von OpenLedger aussagen. Das Wichtigere ist, ob sich über die Zeit hinweg Builder, Anwendungen oder KI-Agenten von verifizierten Beitragsnachweisen abhängig machen. Abhängigkeit ist wichtiger als Aktivität, weil Abhängigkeit darauf hindeutet, dass das System eine Art Gedächtnis erzeugt, auf das andere tatsächlich angewiesen sind — statt auf temporäre Anreize, die die Leute verlassen, sobald die Belohnungen schrumpfen.
Genau dort könnte die Marktdynamik rund um $OPEN wirklich spannend werden. Wenn das Netzwerk nur Beitragsleistende anzieht, die Emissionen jagen, könnte das Token Schwierigkeiten haben, eine tiefere ökonomische Bedeutung zu halten. Aber wenn KI-Builder anfangen, verifizierte Beitragsverläufe zu brauchen, weil diese Datensätze Unsicherheit reduzieren, die Modellqualität verbessern, die Logik für Zahlungen vereinfachen oder Zusammenarbeit leichter vertrauenswürdig machen, dann rückt das Token näher an die zentrale Koordinationsschicht des Ökosystems. In dieser Situation würde sich OpenLedger weniger wie ein simples Daten-Marktplatz anfühlen und mehr wie Infrastruktur für finanzielle Anerkennung innerhalb von KI-Systemen. Und vielleicht ist das der wichtigere Blickwinkel, den viele noch unterschätzen: Die echte Knappheit könnte nicht die Daten selbst sein. Sie könnte die Fähigkeit sein, für das System weiterhin sichtbar zu bleiben — als jemand, dessen Beitrag etwas bedeutet hat. Nicht soziale Sichtbarkeit oder Aufmerksamkeit, sondern ökonomische Sichtbarkeit — die Möglichkeit, als nützlich, wiederverwendbar und langfristig belohnenswert anerkannt zu werden, lange nachdem der ursprüngliche Beitrag in der Maschine verschwunden ist.