
In den vergangenen Jahren lag der größte Reichtum der KI-Branche nicht eigentlich im Modell selbst, sondern in den „Daten“.
Das Problem ist: Derzeit liegt der weitaus größte Teil der weltweiten KI-Datenressourcen in den Händen weniger Tech-Giganten. Normale Nutzer tragen jeden Tag Inhalte, Verhaltensdaten und Sprachdaten bei – aber am Ende profitieren vor allem zentralisierte Plattformen.
Das ist auch der Grund, warum ich OpenLedger in letzter Zeit kontinuierlich verfolge.
OpenLedger ist im Grunde kein klassisches KI-Projekt im traditionellen Sinne. Es ist eher eine Art „KI-Daten-Ökonomie-Infrastruktur“. Es versucht, eines der wichtigsten Probleme der KI-Branche zu lösen: dass Datenbeiträge nicht verifizierbar, nicht nachverfolgbar und nicht in langfristigen Einnahmen umwandelbar sind.
Aktuell wird die gesamte Architektur von OpenLedger hauptsächlich in mehrere Teile unterteilt:
Datanets (Daten-Netzwerk)
Nutzer können professionelle Datensätze hochladen, erstellen und teilen – damit werden Daten zu einem vermögensfähigen Gut (assetisiert).ModelFactory
Es ermöglicht Entwicklern, auf Basis von Community-Daten KI-Modelle zu trainieren, und der gesamte Trainingsprozess ist nachvollziehbar und transparent auf der Blockchain.OpenLoRA
Zur kostengünstigen Bereitstellung großskalierter KI-Modelle; offiziell wurde sogar ein Ansatz vorgeschlagen, mit dem man viele Fine-Tuning-Modelle auf einer einzigen GPU ausführen kann.Proof of Attribution (Nachweis der Beitragserbringung)
Das ist der Teil, den ich für am wichtigsten halte.Welche Daten, welche Trainingsquellen und wer die Beiträge bereitgestellt hat, können verfolgt und protokolliert werden – und so eine automatisierte Gewinnaufteilung ermöglicht werden.
Viele haben vielleicht nicht erkannt, dass diese Mechanik, falls sie wirklich umgesetzt wird, die gesamte Interessenstruktur der KI-Branche verändern würde.
Das größte Problem der KI ist jetzt nicht, dass die Modellfähigkeit nicht ausreicht, sondern:
Unklare Datenbesitzverhältnisse
Datenbeiträger können keinen Gewinn erzielen
Der KI-Trainingsprozess ist vollständig eine Black Box
Für normale Nutzer ist eine Teilnahme an der KI-Ökonomie nicht möglich
Und die Ausrichtung von OpenLedger besteht darin, „Daten“ von privaten Vermögenswerten auf Internetplattformen zu handelbaren Produktionsmitteln auf der Blockchain zu machen.
Diese Frage ist im Grunde ähnlich wie die Veränderung des Finanzwesens durch frühes DeFi.
Im Zeitalter des traditionellen Finanzwesens haben Banken die Kontrolle über die Umlauffähigkeit von Vermögenswerten;
Nach dem Aufkommen von DeFi erhalten Nutzer die Kontrolle über ihre Vermögenswerte.
Gleichermaßen:
Im traditionellen KI-Zeitalter kontrollieren große Unternehmen den Wert der Daten;
und OpenLedger möchte erreichen, dass Datenbeiträger selbst ein Anspruchsrecht auf die Einnahmen haben.
Laut den derzeit offiziellen Unterlagen$OPEN Nicht nur Governance-Token, sondern übernimmt auch:
Gas-Zahlung
KI-Inferenzkosten
Kosten fürs Modelltraining
Belohnungen für Datenbeiträge
Ökosystem-Governance
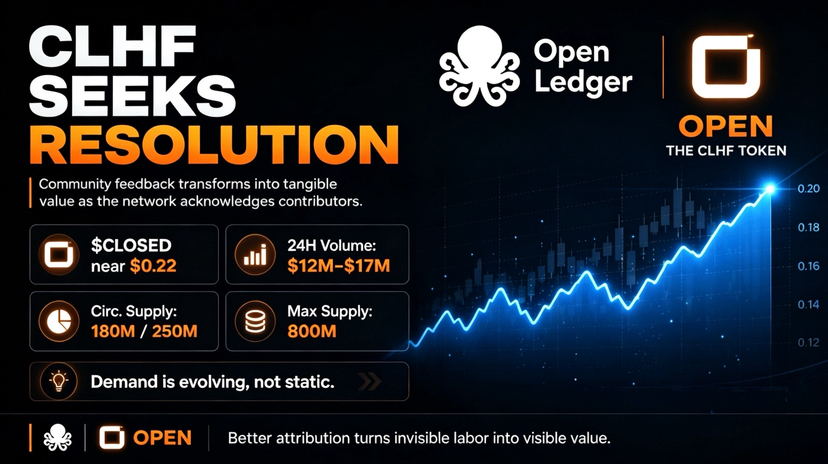
Die gesamte Gesamtversorgung beträgt 1 Milliarde Coins; davon entfallen mehr als 60 % auf Community und das Ökosystem.
Natürlich denke ich, dass OpenLedger in Zukunft mit einigen Herausforderungen konfrontiert sein wird:
Erstens: Bei KI-Projekten gibt es derzeit allgemein das Problem, dass die „Narrative größer sind als die Umsetzung“.
Viele KI+Crypto-Projekte verlassen sich weiterhin auf zentralisierte Rechenleistung und Off-Chain-Berechnungen. Auch wissenschaftliche Studien weisen darauf hin, dass viele KI-Token-Projekte aktuell noch „Scheindelezentralisierung“ zeigen.
Zweitens: Ein echtes System für Daten-Zurechenbarkeit, dessen technische Umsetzung extrem schwierig ist.
Da das Training von KI-Modellen sehr viele komplexe Parameter umfasst, ist es an sich schon eine weltklasse schwierige Aufgabe, präzise zu bestimmen, welchen Beitrag ein bestimmter Teil von Daten zur Modell-Ausgabe leistet.
Drittens: Der Wettbewerb im KI-Bereich ist sehr hart.
Projekte wie Fetch.ai, Bittensor und Ocean buhlen um den Markt für „KI-Infrastruktur“.
Doch selbst dann glaube ich, dass es sich lohnt, die Ausrichtung von OpenLedger langfristig zu beobachten.
Denn in Zukunft ist für die KI-Branche nicht unbedingt entscheidend, wer das größte Modell hat, sondern wer ein „nachhaltiges Daten-Ökonomie-System“ aufbauen kann.
Wer kann das wirklich lösen:
„Wem gehören die Daten?“
„An wen sollte der KI-Gewinn verteilt werden?“
„Wie können normale Menschen an der Wertverteilung von KI teilhaben?“
Wer könnte der Kern der nächsten Runde aus KI + Crypto werden?
Und OpenLedger versucht zumindest bereits, diese Fragen zu beantworten.
@OpenLedger $OPEN #OpenLedger