

Jeden Tag generieren Milliarden von Menschen Texte, Bilder, Verhaltenssignale, Gespräche, Vorlieben, Anmerkungen, Reaktionen, Korrekturen und kulturellen Kontext. Die meisten dieser Aktivitäten fühlen sich währenddessen casual und wegwerfbar an. Eine Suchanfrage. Eine Bildunterschrift. Ein Reddit-Post. Ein Support-Ticket. Ein GitHub-Commit. Eine Produktbewertung. Ein Meme. Ein Gespräch mit einem KI-Assistenten spät in der Nacht.
Aber unter der Oberfläche werden diese Fragmente zu Rohmaterial für maschinelle Intelligenz.
Große KI-Systeme absorbieren menschliches Wissen im planetaren Maßstab und komprimieren riesige Mengen an sozialen, sprachlichen, emotionalen und technischen Informationen in Modelle, die schließlich Produkte wert werden, die Milliarden von Dollar wert sind. Der Prozess fühlt sich sowohl wundersam als auch seltsam asymmetrisch an. Die Menschheit speist kontinuierlich die Maschine, aber das Eigentum an der resultierenden Intelligenz konsolidiert sich oft in einer bemerkenswert kleinen Anzahl von Institutionen.
Dieses Ungleichgewicht ist der Punkt, an dem Projekte wie OpenLedger beginnen, wichtig zu werden.
Nicht, weil sie das Problem bereits gelöst haben. Das haben sie nicht. Und ehrlich gesagt könnten die schwierigeren Fragen gerade erst anfangen.
Aber OpenLedger stellt einen ernsthaften Versuch dar, die Infrastruktur-Ebene unter den KI-Wirtschaften selbst neu zu denken – insbesondere das Problem der Attribution, Teilnahme und wirtschaftlichen Koordination in einer Welt, die zunehmend von autonomen Systemen geprägt wird.
Die meisten Menschen unterschätzen diesen Wandel noch.
Das Gespräch über KI wird immer noch von Modellleistung, GPUs, Benchmarks und Verbraucheranwendungen dominiert. Doch unter dem sichtbaren Wettbewerb zwischen Chatbots und Modellanbietern liegt ein tiefer ungelöster Konflikt: Wer besitzt die Intelligenzproduktion in einem KI-nativen Internet?
Diese Frage wird sehr schnell wirtschaftlich explosiv.
Moderne KI-Systeme werden auf Ozeanen von menschlich generiertem Material trainiert, aber die Mechanismen zur Nachverfolgung von Beiträgen sind schwach, undurchsichtig oder nicht existent. Künstler wissen selten, wann ihre Stile die Ausgaben beeinflussen. Gemeinschaften können oft nicht leicht messen, wie viel Wert ihr kollektives Wissen geschaffen hat. Forscher tragen Entdeckungen bei, die in breitere Systeme integriert werden, ohne direkt an der nachgelagerten Wirtschaft teilzunehmen. Selbst Open-Source-Entwickler beobachten oft, wie milliardenschwere Ökosysteme um Arbeiten entstehen, die sie kostenlos veröffentlicht haben.
Die aktuelle Struktur ähnelt mehr der Extraktion als der Teilnahme.
Und das ist der Punkt, an dem die These von OpenLedger interessant wird.
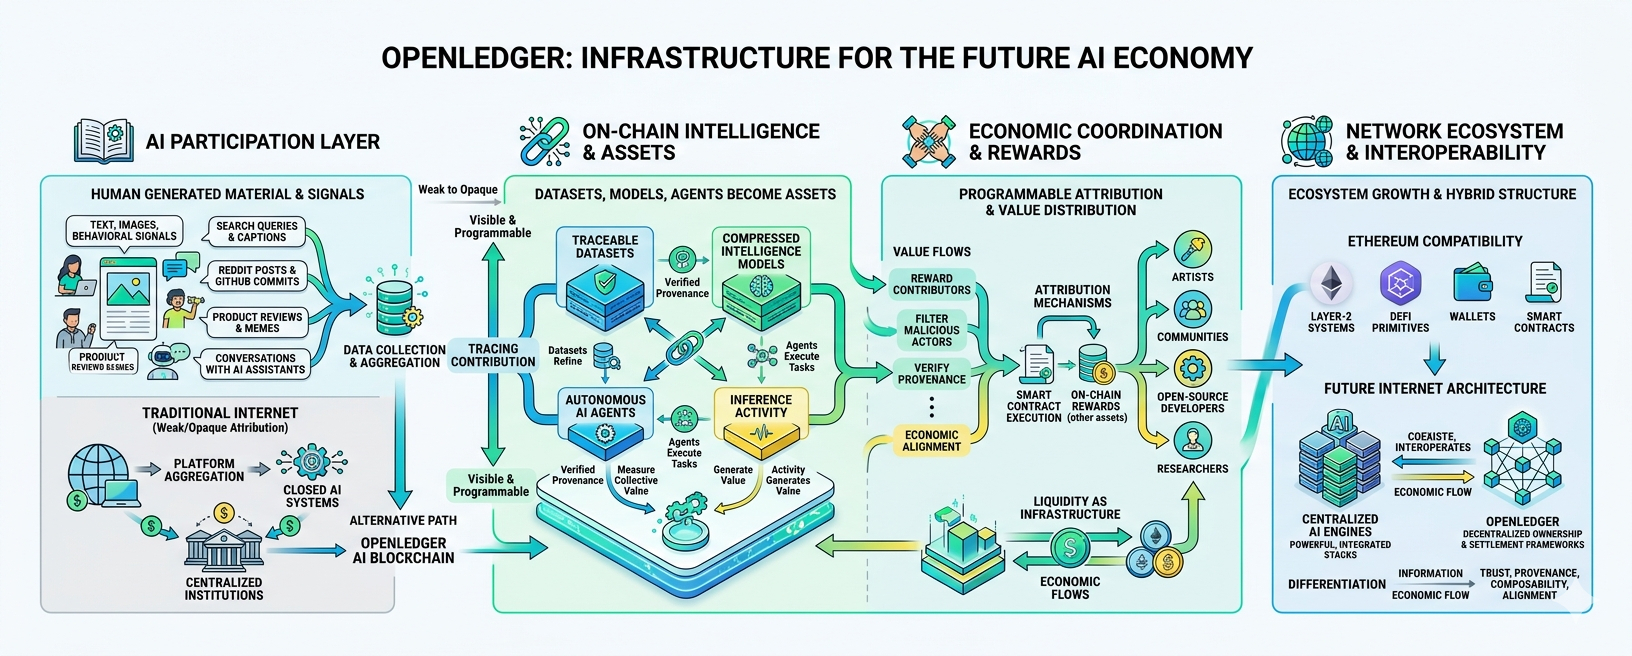
Das Projekt positioniert sich nicht einfach als eine weitere Blockchain, sondern als eine „KI-Blockchain“ – Infrastruktur, die speziell für die Teilnahme an KI entwickelt wurde. Diese Formulierung ist wichtig, weil sie eine andere Annahme über den Zweck von Blockchains impliziert. Traditionelle Layer-1-Erzählungen drehen sich oft um Zahlungen, dezentrale Finanzen oder allgemeine Ausführung von Smart Contracts. OpenLedger behandelt stattdessen die KI selbst als den primären wirtschaftlichen Akteur.
Datensätze werden zu Vermögenswerten.
Modelle werden zu Vermögenswerten.
Agenten werden zu Vermögenswerten.
Inference-Aktivitäten werden zu wirtschaftlichen Aktivitäten.
Koordination wird programmierbar.
Die Infrastrukturebene ist normalerweise wichtiger, als die Leute realisieren.
Historisch gesehen haben die Systeme, die leise Eigentum und Abrechnung standardisierten, oft ganze Volkswirtschaften umgeformt. Das Internet selbst war nicht wertvoll, nur weil Websites existierten. Es wurde transformativ, weil Protokolle den Informationsaustausch im globalen Maßstab ermöglichten. Finanzmärkte erweiterten sich, weil Abrechnungssysteme standardisiert und interoperabel wurden. Rahmenbedingungen für geistiges Eigentum veränderten industrielle Anreize, weil Attribution formalisiert und monetarisiert werden konnte.
KI scheint in eine ähnliche Phase einzutreten.
Im Moment bleibt die Beziehung zwischen KI-Systemen und der Wertschöpfung unklar. Unternehmen scrapen, trainieren, setzen ein, monetarisieren und optimieren innerhalb weitgehend geschlossener Ökosysteme. Die Attribution ist schwach, weil es schwierig ist, nachzuvollziehen, wie einzelne Datenpunkte die Ergebnisse beeinflussen. Menschliche Beiträge lösen sich in statistischer Abstraktion auf.
OpenLedger versucht, eine Infrastruktur aufzubauen, in der diese Beziehungen wirtschaftlich sichtbar werden.
Zumindest theoretisch.
Die Idee ist trügerisch einfach: Wenn Daten, Modelle und autonome Agenten an der wirtschaftlichen Produktion teilnehmen, dann sollten sie vielleicht als nachverfolgbare On-Chain-Entitäten existieren, die in der Lage sind, Wert zu erzeugen, zu empfangen und zu verteilen.
Das klingt fast offensichtlich, wenn man es klar ausspricht.
Doch die moderne Internetarchitektur wurde nie wirklich dafür entworfen. Bestehende Websysteme glänzen in der Inhaltsverteilung und Plattforaggregierung, aber sie kämpfen mit der granularen Eigentumsabrechnung im KI-Maßstab. Traditionelle Datenbanken können Transaktionen verfolgen, schaffen jedoch nicht von sich aus offene wirtschaftliche Koordinationsschichten. Geschlossene KI-Systeme können die Leistung optimieren, zeigen jedoch selten transparente Belohnungsmechanismen für Beitragende auf.
Der Versuch von OpenLedger, die Teilnahme von KI direkt on-chain zu platzieren, spiegelt den Glauben wider, dass zukünftige Intelligenzökonomien native wirtschaftliche Infrastruktur benötigen, nicht nur APIs, die an zentralisierte Plattformen angeschlossen sind.
Diese Unterscheidung könnte zunehmend wichtig werden.
Berücksichtigen Sie, was passiert, wenn autonome KI-Agenten in den nächsten zehn Jahren leistungsfähiger werden. Keine Science-Fiction-Roboter – einfach Software-Entitäten, die kontinuierlich wirtschaftliche Aufgaben online ausführen. Agenten, die Liquidität verwalten. Agenten, die Forschung analysieren. Agenten, die Dienstleistungen aushandeln. Agenten, die Medien generieren. Agenten, die Logistik koordinieren. Agenten, die kleinere Modelle trainieren, die auf Nischenbereiche spezialisiert sind.
Wenn diese Systeme beginnen, kontinuierlich über digitale Märkte zu interagieren, werden Fragen nach Identität, Eigentum, Vergütung und Verifizierung unvermeidlich.
Wer besitzt die Ausgaben eines autonomen Agenten?
Wer wird bezahlt, wenn ein Modell von Gemeinschaftsdaten profitiert?
Wie werden Beitragende belohnt?
Wie werden böswillige Akteure herausgefiltert?
Wie transagieren Agenten miteinander?
Wie verifizieren Systeme die Herkunft?
Wie entsteht Vertrauen in maschinen-native Ökonomien?
Das sind nicht mehr nur technische Fragen. Es sind institutionelle Fragen.
Und ehrlich gesagt könnte das die wirkliche wirtschaftliche Schlacht werden.
Die Betonung von OpenLedger auf der Monetarisierung von Datensätzen, Modellen und Agenten spiegelt die Erkenntnis wider, dass zukünftige KI-Wirtschaften weniger um statisches Software-Eigentum und mehr um kontinuierlich operierende Intelligenzsysteme kreisen könnten. In diesem Umfeld wird Liquidität selbst zur Infrastruktur. Vermögenswerte sind nicht mehr passive Dateien, die auf Servern sitzen. Sie werden zu produktiven Entitäten, die Ausgaben generieren, mit Netzwerken interagieren und potenziell fortlaufende wirtschaftliche Flüsse verdienen.
Das ändert die Bedeutung des digitalen Eigentums.
Heute ist Online-Eigentum oft oberflächlich. Nutzer „besitzen“ technisch gesehen Konten, Tokens oder Inhalte, aber der meiste Wert fällt an Plattformen, die Aufmerksamkeit und Berechnung koordinieren. Die breitere philosophische Richtung von OpenLedger deutet auf ein anderes Modell hin, in dem Beitragende direkter an der Intelligenzproduktion selbst teilnehmen.
Ob diese Vision erfolgreich ist, ist eine ganz andere Frage.
Denn die Schwierigkeiten hier sind enorm.
Die Attribution innerhalb von KI-Systemen ist eines der schwierigsten Koordinationsprobleme in der modernen Informatik. Neuronale Netzwerke zeigen nicht von Natur aus saubere kausale Karten zwischen spezifischen Datenbeiträgen und endgültigen Ausgaben. Menschliche Kreativität selbst ist zutiefst derivative und miteinander verbunden. Die Grenzen zwischen Inspiration, Beitrag, Transformation und Replikation sind oft mehrdeutig, selbst bevor Maschinen ins Spiel kommen.
Zu versuchen, die Attribution im großen Maßstab zu formalisieren, könnte sich als rechenintensiv, sozial umstritten und manipulationsanfällig herausstellen.
Da beginnt es, unangenehm zu werden.
Offene Systeme ziehen Spam an.
Wirtschaftliche Anreize verzerren das Verhalten.
Niedrigwertige Datenfarmen könnten bedeutende Beiträge überwältigen. Spekulanten könnten Token-Belohnungen nachjagen, ohne echte Nützlichkeit zu schaffen. Beitragende könnten sich auf messbare Attributionsmetriken optimieren, anstatt auf die tatsächliche Qualität des Wissens. Governance-Strukturen könnten politisiert werden. Wirtschaftliche Extraktion könnte einfach in neuen Formen unter dezentraler Markenbildung wieder auftauchen.
Die Blockchain-Geschichte bietet hier viele Warnungen.
Erzählungen über Dezentralisierung kollidieren oft mit der Realität von Konzentration, schlechten Anreizen, schwacher Teilnahme an der Governance und spekulativem Übermaß. Infrastruktur allein garantiert keine gerechten Ergebnisse. Manchmal ändert es nur, wer den Wert erfasst.
OpenLedger steht daher vor einer Herausforderung, die größer ist als die Technologie selbst: den Aufbau glaubwürdiger Koordinationsmechanismen, die echte langfristige Nützlichkeit erzeugen, anstatt temporäre finanzielle Aktivitäten.
Die Ausführung ist wichtiger als die Erzählung.
Und Infrastrukturprojekte sind notorisch schwierig, weil ihr Erfolg davon abhängt, dass Ökosysteme um sie herum entstehen. Der Markt belohnt Infrastruktur selten sofort. Frühe Internetprotokolle sahen im Vergleich zu Verbraucheranwendungen langweilig aus. Cloud-Infrastruktur schien anfangs weniger aufregend als soziale Plattformen. Zahlungsschienen waren von grundlegender Bedeutung, obwohl sie für die Nutzer weitgehend unsichtbar waren.
Wenn OpenLedger in irgendeinem sinnvollen Sinne erfolgreich ist, wird es wahrscheinlich zu Beginn leise geschehen.
Entwickler, die Attributionssysteme integrieren.
KI-Agenten nutzen standardisierte wirtschaftliche Rahmenbedingungen.
Datenanbieter, die an Belohnungsstrukturen teilnehmen.
Modelle, die über Ökosysteme hinweg interoperieren.
Gemeinschaften, die mit gemeinsamen Eigentumsstrukturen experimentieren.
Das sind langsame Koordinationsprozesse, keine viralen Momente.
Die Ethereum-Kompatibilität des Projekts ist ebenfalls strategisch bedeutsam. Anstatt sich als völlig separates Ökosystem zu isolieren, scheint OpenLedger zu erkennen, dass zukünftige KI-Wirtschaften wahrscheinlich Interoperabilität mit bestehenden Krypto-Infrastrukturen erfordern werden. Wallets, Smart Contracts, Layer-2-Systeme und dezentrale Finanzprimitive bilden bereits eine aufkommende Koordinationsschicht für programmierbare Vermögenswerte.
Reibungsreduktion ist wichtig, weil die Einführung von Infrastruktur oft weniger von theoretischer Überlegenheit abhängt und mehr von der Einfachheit der Integration.
Systeme überleben, wenn sie in bestehende Verhaltensmuster integriert werden.
Das mag im Vergleich zu großen Visionen über dezentrale KI banal erscheinen, aber historisch gesehen ist es genau die Art und Weise, wie grundlegende Technologien verbreitet werden.
Dennoch bleibt Skepsis notwendig.
Eine der unangenehmen Realitäten der KI-Entwicklung ist, dass zentrale Systeme derzeit enorme strukturelle Vorteile besitzen. Das Training von Frontier-Modellen erfordert gewaltige Rechenressourcen, erstklassige Forschungstalente, proprietäre Optimierungstechniken und massive Investitionen. Offene Ökosysteme könnten Schwierigkeiten haben, direkt mit eng integrierten Unternehmens-KI-Stacks zu konkurrieren, die auf industriellen Maßstab optimiert sind.
Dezentrale KI-Infrastruktur könnte daher nicht zentrale KI ersetzen, sondern sie eher ergänzen oder einschränken.
Diese Unterscheidung ist wichtig.
OpenLedger könnte letztlich wertvoll werden, nicht weil es zentralisierte Anbieter in der Rohintelligenz-Generierung übertrifft, sondern weil es alternative Eigentums- und Koordinationsmechanismen rund um die KI-Aktivität selbst bietet. Mit anderen Worten, die Eigentumsschicht könnte im Laufe der Zeit wichtiger werden als die Rechenschicht.
Diese Möglichkeit wird häufig übersehen.
Wenn die KI-Fähigkeiten commodifiziert werden, könnte sich die Differenzierung zunehmend auf Vertrauen, Herkunft, wirtschaftliche Teilnahme und Interoperabilität verschieben. Nutzer könnten weniger an marginalen Benchmark-Verbesserungen interessiert sein und mehr daran, ob Systeme transparent, komposierbar und wirtschaftlich mit den Beitragenden ausgerichtet sind.
Das zukünftige Internet könnte sich in eine hybride Struktur entwickeln, in der zentralisierte Intelligenz-Motoren mit dezentralisierten Eigentums- und Abrechnungsrahmen koexistieren.
OpenLedger scheint um diese Möglichkeit herum positioniert zu sein.
Und darunter gibt es eine tiefere philosophische Dimension.
Seit Jahrzehnten monetarisiert das Internet hauptsächlich Aufmerksamkeit. Plattformen konkurrierten darum, Engagement zu erfassen, Nutzerverhalten zu aggregieren und gezielten Zugang zu verkaufen. KI verändert die Gleichung, weil menschliche Aktivitäten selbst zum Trainingssubstrat für maschinelles Denken werden. Die Wirtschaft erntet nicht mehr nur Klicks. Sie erntet Intelligenzsignale.
Diese Transformation verändert die Beziehung zwischen Menschen und digitalen Systemen.
Menschliche Ausdrucksformen werden auf neue Weise wirtschaftlich produktiv.
Gemeinschaften werden zu Trainingsumgebungen.
Verhalten wird zur Modellverfeinerung.
Wissen wird zur Infrastruktur.
Irgendwann könnten Gesellschaften Systeme fordern, die diese Beiträge transparenter erfassen.
Nicht unbedingt aus Idealismus, sondern weil der Umfang der KI-gesteuerten Wertentnahme politisch und wirtschaftlich schwer zu ignorieren werden könnte.
OpenLedger existiert in diesem aufkommenden Spannungsfeld.
Es versucht, eine Infrastruktur zu schaffen, in der die Intelligenzproduktion wirtschaftlich lesbar wird – wo Teilnahme, Attribution und Eigentum programmierbar und nicht unsichtbar sind. Ob die Blockchain-Technologie letztendlich das richtige Substrat dafür ist, bleibt ungewiss. Ob dezentrale Governance solche Systeme effektiv koordinieren kann, bleibt ungewiss. Ob Beitragende tatsächlich gerechtere Ergebnisse erhalten, bleibt ungewiss.
Es gibt viele Möglichkeiten, wie dies scheitern könnte.
Aber die Fragen, die gestellt werden, sind zunehmend unvermeidlich.
Wer besitzt maschinell generierten Wert?
Wer nimmt an KI-Wirtschaften teil?
Wie sollte Attribution funktionieren?
Was bedeutet digitale Arbeit, wenn Menschen und Maschinen kontinuierlich zusammenarbeiten?
Was wird aus dem Eigentum, wenn Intelligenz selbst modular, programmierbar und autonom wird?
Das sind keine Randfragen mehr im Krypto-Bereich. Sie sind aufkommende wirtschaftliche Fragen für das Internet selbst.
Und vielleicht ist das der wichtigste Weg, OpenLedger zu verstehen.
Nicht als Token.
Nicht als ein weiterer spekulativer Layer-1.
Nicht einmal primär als KI-Produkt.
Aber als Teil eines breiteren Versuchs, die unsichtbaren Abrechnungssysteme unter zukünftigen Intelligenzökonomien neu zu gestalten.
Denn irgendwann wird KI nicht nur Inhalte generieren oder Arbeitsabläufe automatisieren. Sie wird kontinuierlich an Märkten, Governance-Systemen, finanzieller Koordination, Forschung, Medienproduktion und Online-Arbeitsstrukturen teilnehmen. Das Internet könnte sich langsam von einem Netzwerk von Websites in ein Netzwerk interagierender Intelligenzen verwandeln.
Wenn das passiert, könnte die Infrastruktur, die die Attribution und das Eigentum regelt, äußerst wichtig werden.
Die jetzt gebauten Systeme könnten leise bestimmen, wer später Wert erfasst.
Die meisten Menschen unterschätzen diesen Wandel noch.
Und ehrlich gesagt weiß niemand genau, wohin es führt.
