
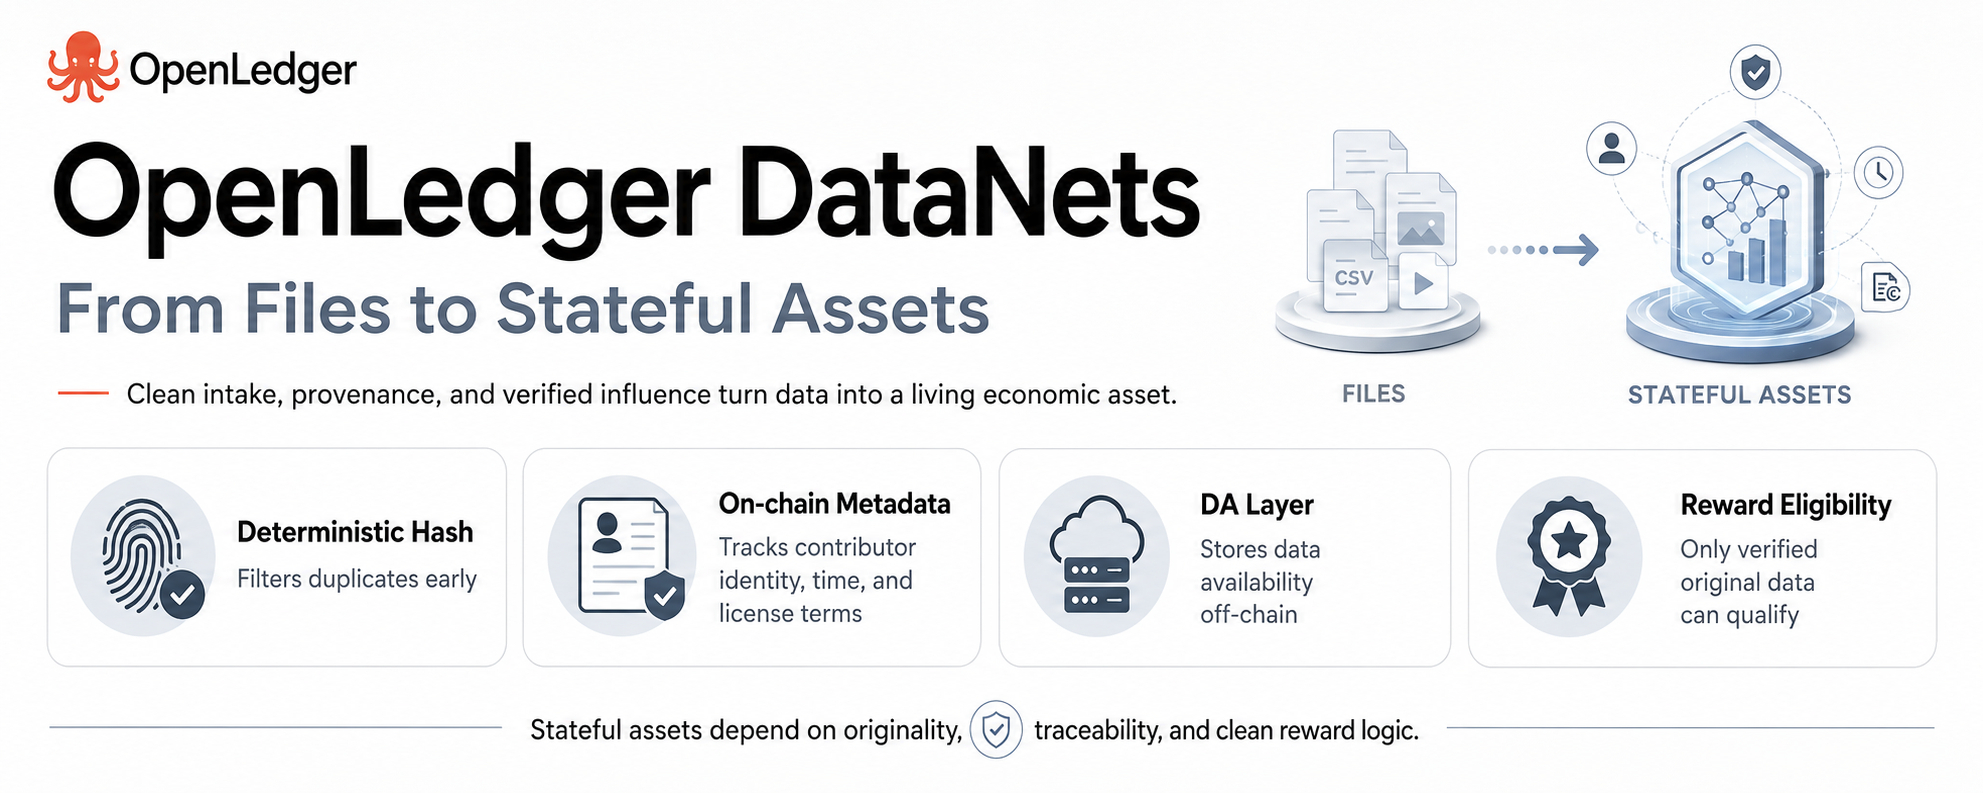
Ich habe eines gelernt, nachdem ich die Märkte zu lange beobachtet habe: schwache Systeme scheitern nicht auf der Überschriftenebene. Sie scheitern am Zulauf. Das Gleiche gilt für Datenökonomien.
Jeder spricht gerne über große Datensätze, Community-Beiträge, offene Teilnahme und all die glänzenden Worte, die jeder verwendet, wenn er versucht, chaotische Koordination sauber erscheinen zu lassen. Aber der echte Test ist langweilig. Fast beleidigend, wirklich. Was passiert, wenn zehntausend Leute versuchen, dasselbe mit einer leicht anderen Hülle einzureichen? Aber DataNets werden für mich interessant.
Nicht weil es klingt, als würden Datensätze onchain gehen. Das tut es nicht. Es klingt nach einer weiteren Konferenzfolie, die versucht, sich aus echter Arbeit herauszuschwindeln. Der eigentliche Punkt ist: DataNets behandeln Daten weniger wie eine tote Datei und mehr wie ein lebendiges ökonomisches Objekt. Ein beigetragener Gegenstand kommt mit Metadaten: wer ihn hinzugefügt hat, wann er eingetroffen ist, welche Lizenzbedingungen daran hängen und wie er mit dem breiteren Datensatz verbunden ist. Das verändert die ganze Gestalt.
In alten Datenmärkten ist ein Datensatz oft ein Paket. Jemand baut ihn, verkauft den Zugang, vielleicht aktualisiert er ihn später, vielleicht auch nicht. Sehr ordentlich. Sehr fragil. Sehr leicht, still und leise in der Ecke zu verrotten, während alle so tun, als spiegelte das Spreadsheet noch immer die Realität. DataNets rücken näher an eine laufende Maschine. Jeder Beitrag wird Teil eines gemeinsamen Zustands.
Das bedeutet: Das System kümmert sich nicht nur darum, dass Daten existieren. Es kümmert sich darum, wo sie herkommen, ob sie bereits im Netzwerk enthalten sind, ob sie nützlich sind und ob sie über die Zeit weiterhin messbaren Einfluss erzeugen. Wie ein Warehouse, in dem jede Kiste einen Pass, einen Zeitstempel und einen Fingerprint hat. Nervig? Klar. Notwendig? Ebenfalls klar.
Was ich immer wieder aufgreife, ist der deterministische Hash. Dieser kleine Fingerprint erledigt schwere Sicherheitsarbeit, bevor die Daten überhaupt in die Off-Chain-Speicherung gelangen. Taucht derselbe Beitrag noch einmal auf, macht der Hash das sichtbar. Duplikat abgelehnt. Kein cleveres Farmen-Trickchen. Keine Copy-Paste-Karnevalsshow. Kein „Ich habe das Internet gefunden und es Beitrag genannt“ – was leider an schlechten Tagen etwa 80% der Produktivität ausmacht.
Das ist wichtig, weil Belohnungspools zerbrechen, wenn Schrott still hineinkommt. Wenn doppelte Daten als gültige Arbeit gezählt werden, wird die ganze Anreiz-Landkarte schmutzig. Echte Beitragsleistende verlieren Signalgewicht. Kuratoren verlieren Vertrauen. Die DataNet wird zu einer Deponie mit Buchhaltungssoftware, die am Eingangstor festgekellt ist. Und wenn das einmal passiert ist, viel Glück dabei, ernsthafte Builder davon zu überzeugen, dass der Datensatz sauberen ökonomischen Wert hat.
Also wird die Registrierungsphase zur ersten Schlacht. Nicht Speicher. Nicht Design des Marktplatzes. Nicht das hübsche Dashboard. Registrierung. Dort entscheidet das System, ob eine neue Einreichung überhaupt existieren darf – innerhalb des Asset-Zustands.
Das ist ein Filter vor dem Warehouse – nicht ein Aufräumer, der den Schlamassel nach dem Brand beseitigt. Ich mag dieses Design, weil es praktisch ist. Daten brauchen Knappheit an Originalität, nicht Knappheit an Zugriff. Jeder kann eine Datei kopieren… Aber das ist kein Beitrag. Beitrag heißt: etwas hinzufügen, das die Form, Tiefe, Frische oder Nützlichkeit der DataNet verändert.
Der deterministische Hash erzwingt genau diese Frage: Ist das neue Material, oder recycelte Ware in billiger Verkleidung? Aber hier besteht trotzdem ein Risiko. Wenn die Hashing-Logik zu starr ist, könnten winzige Formatänderungen durchrutschen. Unterschiedliche Abstände. Neu angeordnete Felder. Leichte Edits. Gleicher Inhalt im Kern, anderer Fingerprint.
Das schafft einen Umgehungsweg, durch den doppelter Inhalt als vermeintliche Neuheit hineingelangt. Nicht von sich aus katastrophal, aber genug, um den Wert über die Zeit nach und nach auslaufen zu lassen. Tröpfchen, tröpfchen, tröpfchen… Dann fängt die Ausschüttung der Belohnungen an, auf dem Dashboard sauber auszusehen, während sie darunter still verunreinigt wird.
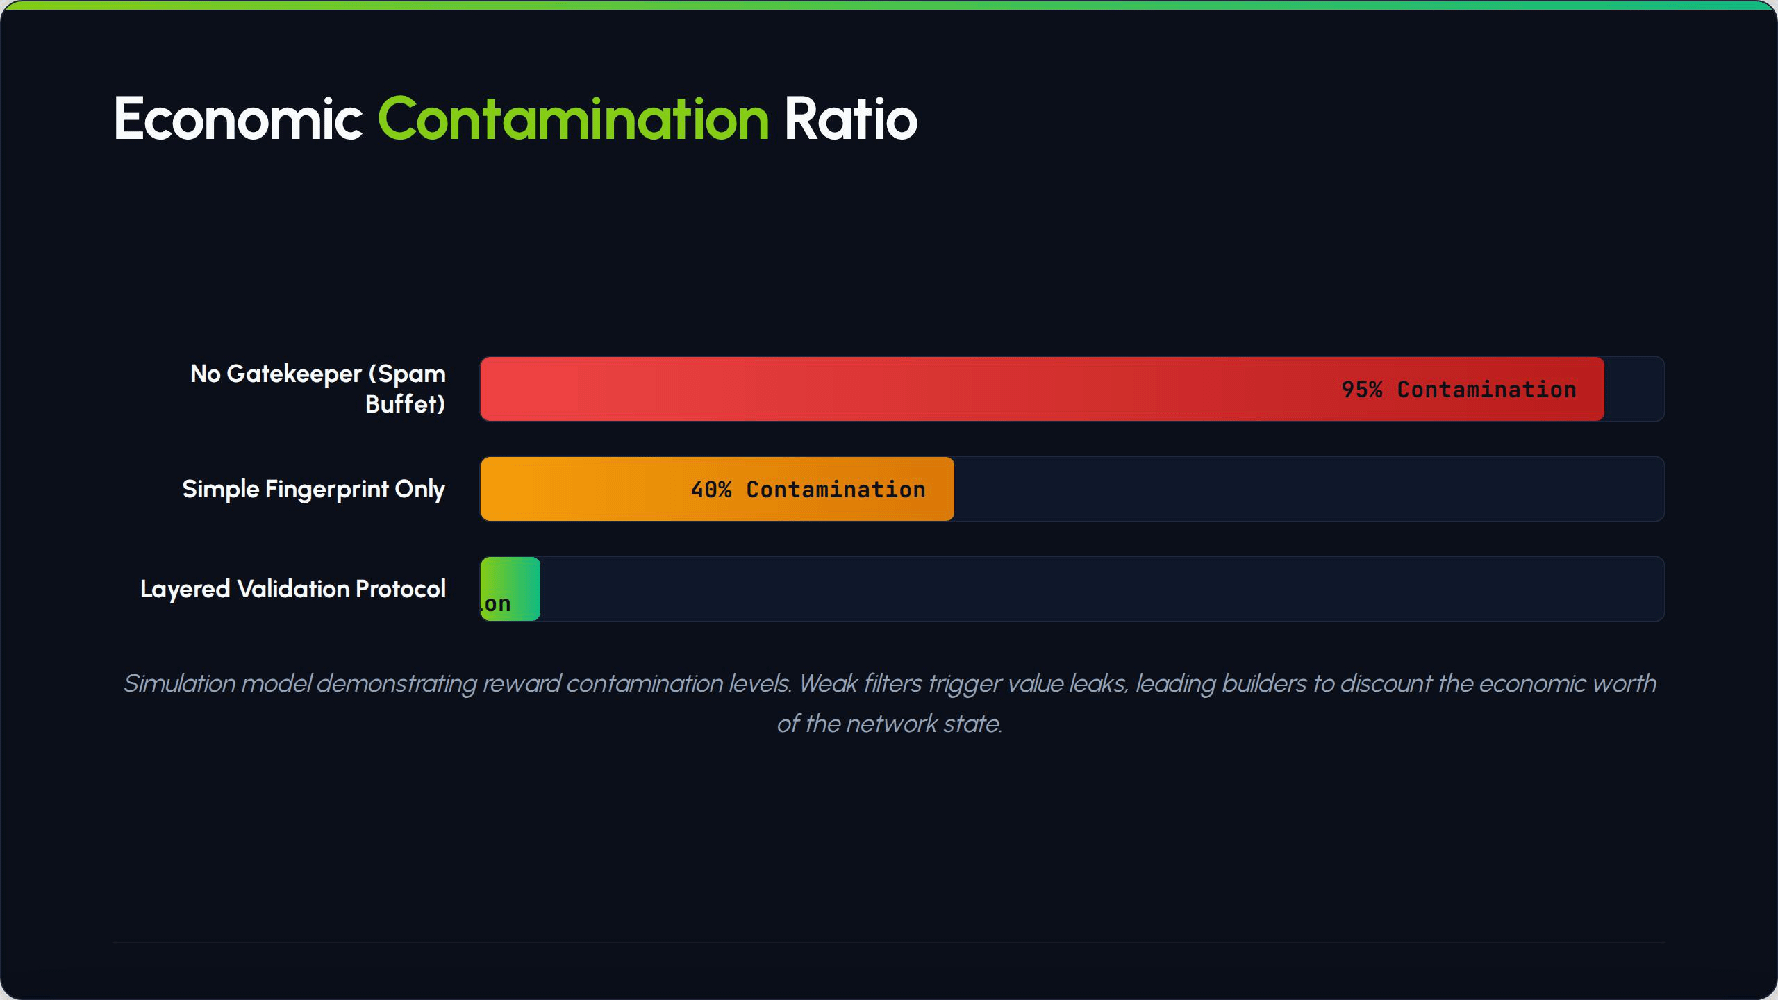
Hier zählt die technische Reife. Eine gute DataNet kann sich nicht ewig nur auf exaktes Hashing verlassen. Sie braucht mehrschichtige Prüfungen. Deterministische Fingerprints für offensichtliche Duplikate. Semantische Ähnlichkeitschecks für nahezu identische Kopien. Kurator-Review für Sonderfälle.
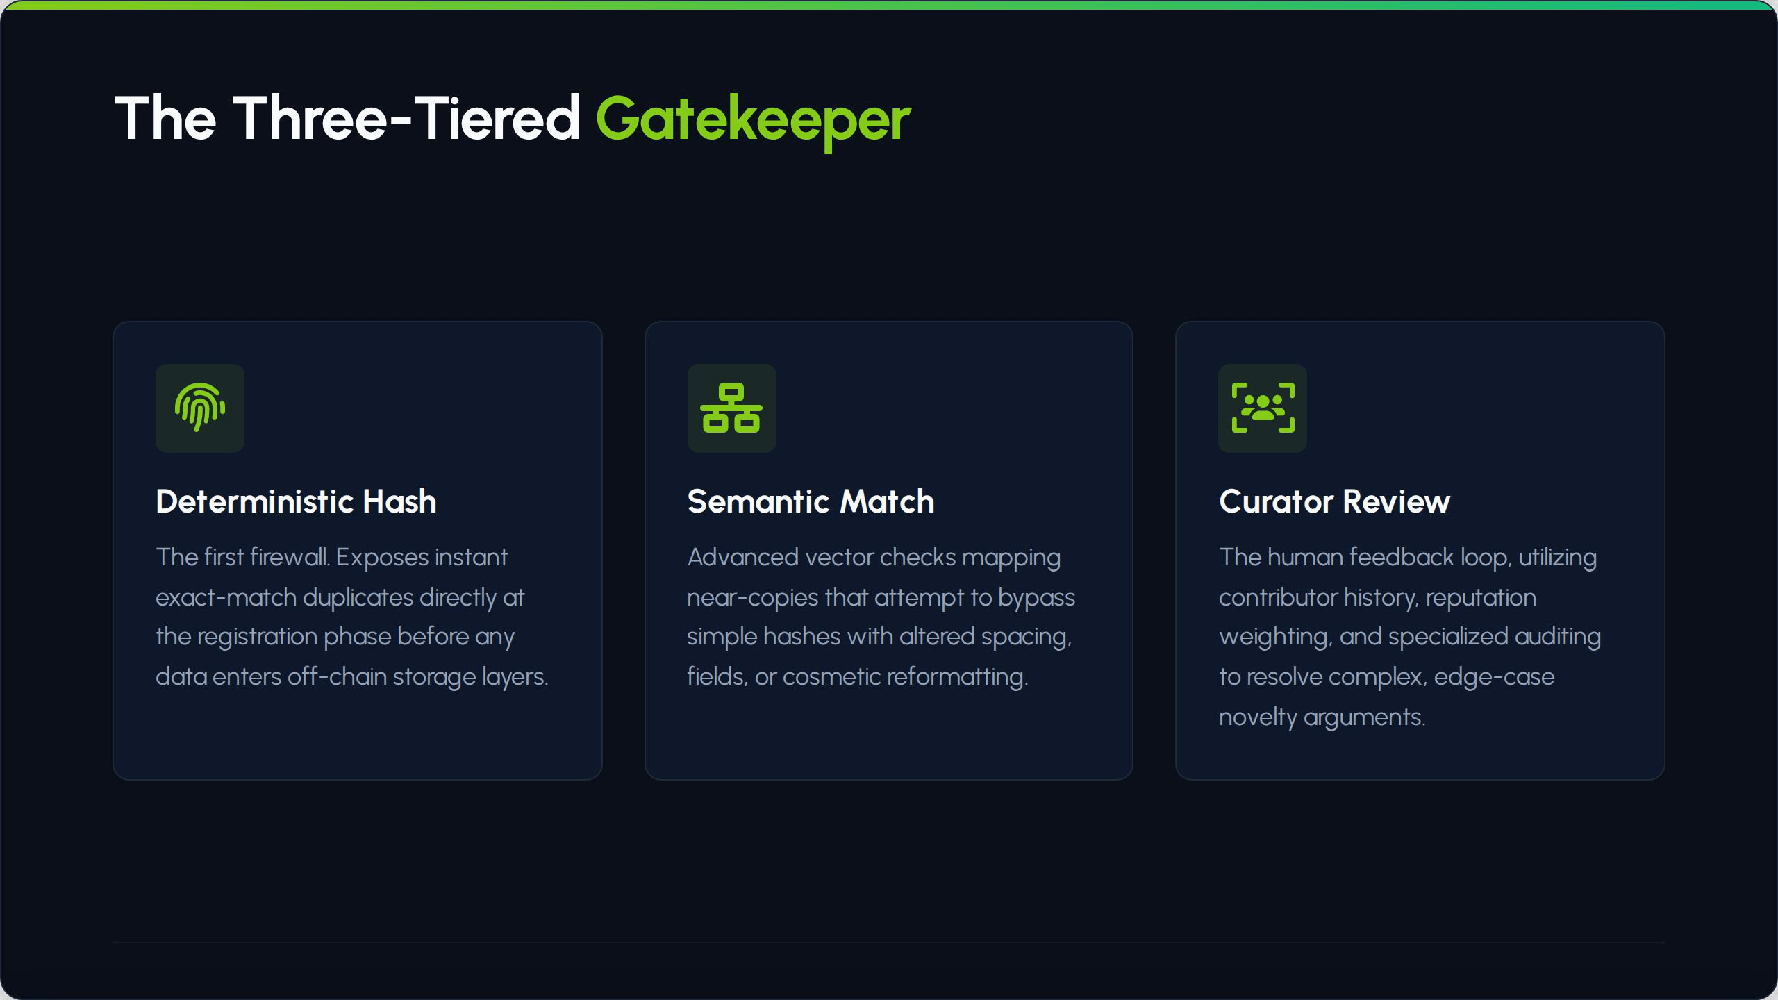
Lizenzvalidierung. Beitragshistorie. Vielleicht sogar Akzeptanz mit Reputation-Gewichtung. Denn echte Daten sind chaotisch – und sie sind sehr talentiert darin, jedes offene System in ein Schlupfloch-Wettbewerb zu verwandeln. Die größere Verschiebung ist jedoch ökonomisch. Statische Datensätze sind wie Flaschenwasser. Nützlich einmal, dann verbraucht, kopiert oder vergessen. DataNets sind näher an Bewässerungssystemen. Sie halten den Wert in Bewegung, solange die Leitungen sauber bleiben und die Quelle weiter besser wird.
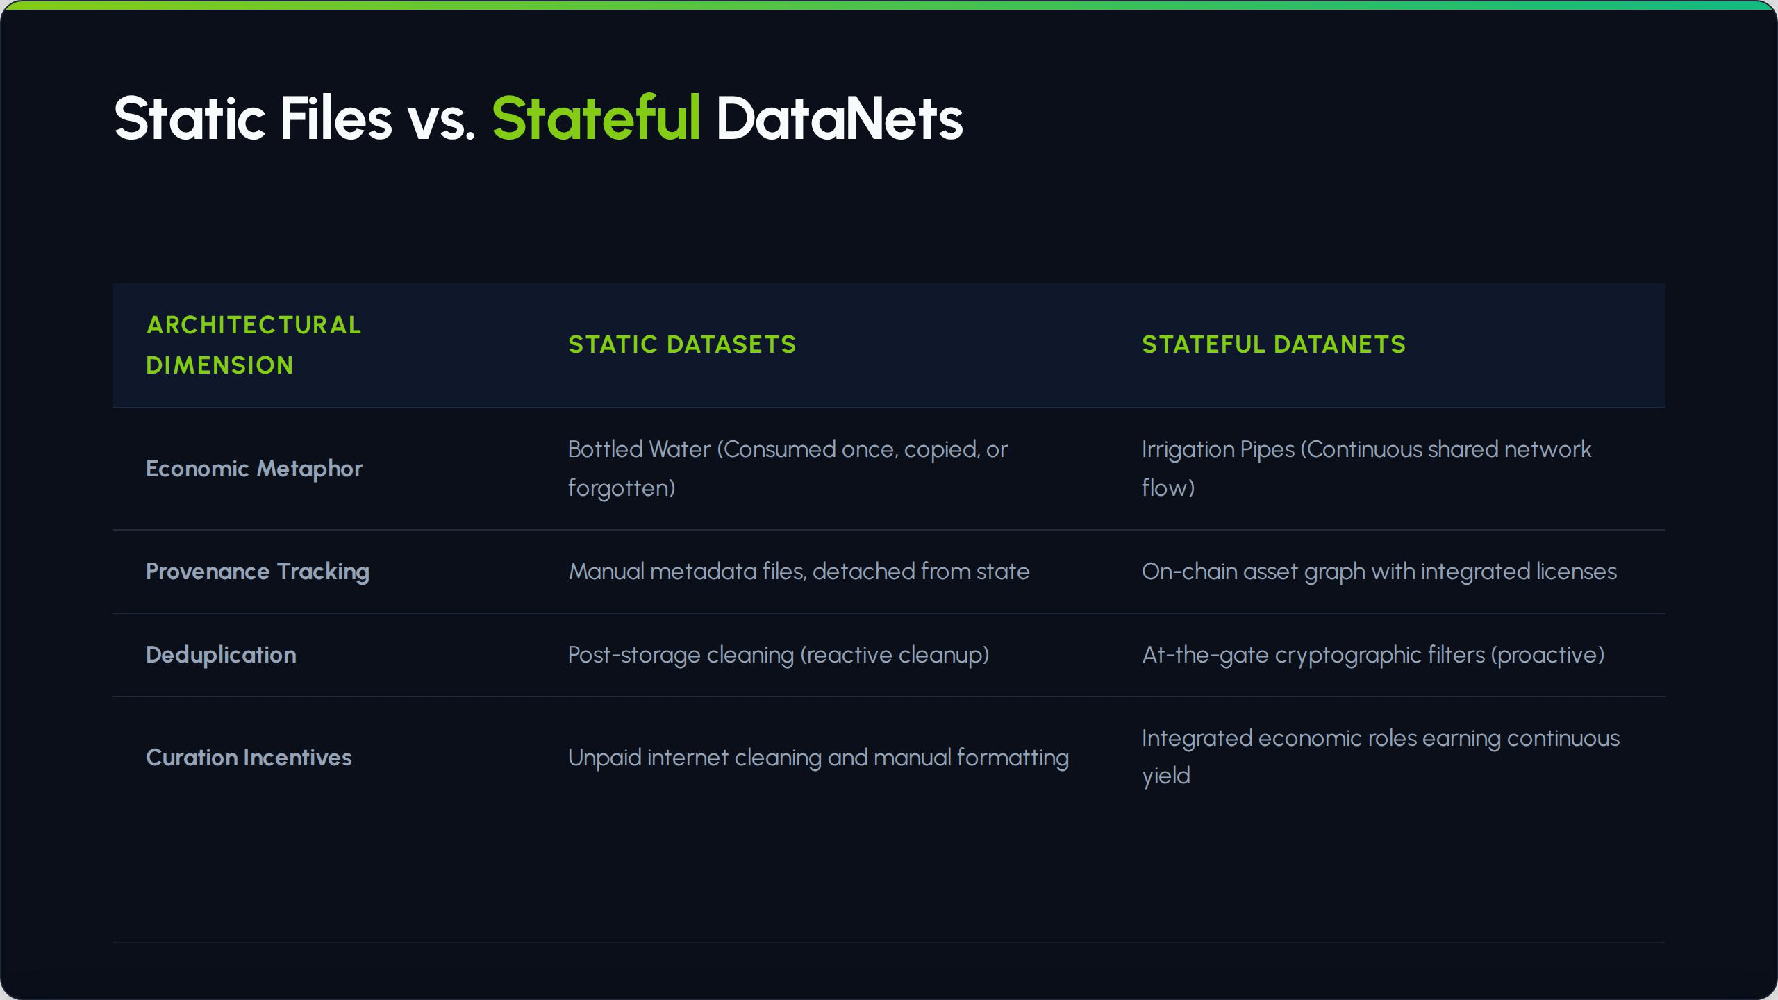
Das Asset ist nicht nur die Datei. Das Asset ist der verifizierte Beitragspfad um sie herum. Genau das wird von vielen übersehen. Der Wert liegt nicht nur in mehr Daten. Mehr Daten können mit Menge auch nur Müll sein. Der Wert sind strukturierte, deduplizierte, lizenzierte und nachverfolgbare Daten, die relevant bleiben können, wenn Modelle, Agenten und Anwendungen sie nutzen. Einfluss wird messbar.
Der Beitrag wird persistent. Kuratieren wird zu einer ökonomischen Rolle – statt einer unbezahlten Pflicht zur Internetreinigung. Für Dateningenieure ist das keine Marketing-Schicht. Es ist ein Qualitätssicherungs-Stack. Wenn die Intake-Logik schwach ist, erbt die ganze DataNet schlechte Annahmen. Wenn die Intake-Logik diszipliniert ist, wird die DataNet mehr als eine Ansammlung. Sie wird ein zustandsbehaftetes Asset mit Gedächtnis, Provenienz und wiederkehrendem Nutzen. Langweilige Worte. Großer Unterschied.
Für dezentrale Daten-Kuratoren wird die Frage noch schärfer: Fügst du neues Signal hinzu, oder schiebst du nur altes Rauschen in einen neuen Container? Der deterministische Hash kümmert sich nicht um deine Story. Er prüft den Fingerprint. Diese Kälte ist nützlich. Systeme brauchen etwas Härte am Eingang – sonst ist das Eingangstor nur Deko.
DataNets werden erst dann wirklich ernst, wenn sie Originalität schützen – vor dem Speichern – und ökonomische Fairness verteidigen – vor der Verteilung.
Der deterministische Hash ist nicht die gesamte Architektur, aber er ist die erste harte Mauer gegen gefälschte Beiträge. Ohne diese Mauer wird Community-Daten zu einem Spam-Buffet mit schickerem Branding. Mit ihr sehen DataNets nach etwas Dauerhafterem aus: nicht nach Dateien, die man einmal verkauft, sondern nach lebenden Assets, die ihren Wert weiter beweisen können – über verifizierten Einfluss.
Also lautet die Frage: Wenn Daten zu einem zustandsbehafteten Asset werden, wem gebührt dann das meiste Gewicht – der Person, die am meisten hochlädt, oder der Person, deren Beitrag das System weiter verbessert, nachdem alle anderen vergessen haben, dass es existiert?
Ich würde das als technische Arbeit behandeln, die man untersucht, nicht als Abkürzung zur Überzeugung, denn jedes Design braucht immer noch realen Stresstest, bevor es Vertrauen verdient…
@OpenLedger #OpenLedger $OPEN #DataNets
