

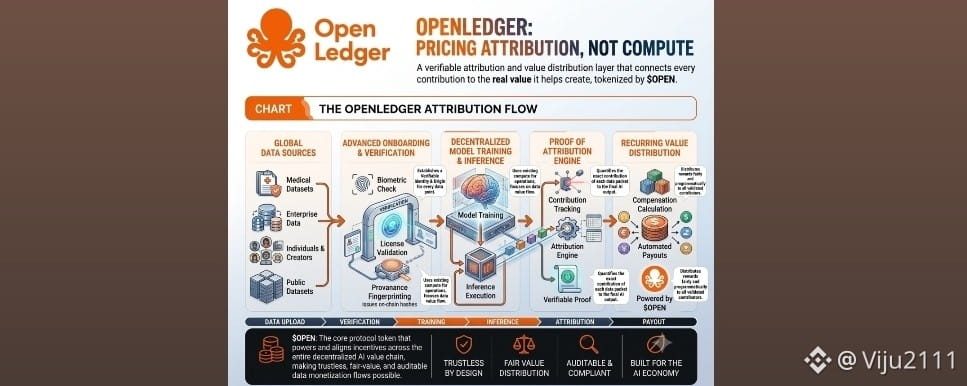
Wenn du dir die dezentrale AI (DeAI) Landschaft genau ansiehst, sehen 90 % der Projekte identisch aus. Sie rennen darum, Rechenleistung zu commodifizieren – im Grunde genommen bauen sie dezentrale Serverfarmen, um GPUs zu vermieten. Aber OpenLedger ($OPEN) verfolgt leise ein grundlegend anderes Spielbuch.
Während es aussieht, atmet und sich verhält wie eine standardmäßige Hochleistungs-AI-Blockchain, liegt der wahre wirtschaftliche Motor nicht in der Preisgestaltung von Rechenzyklen. Es geht um die Preisgestaltung von AI-Datenattribution.
Hier ist, warum diese Unterscheidung für den zukünftigen Wert von $OPEN wichtig ist.
Die Compute-Falle vs. Der Datenengpass
Das Vermieten von GPUs (dezentralisierte Berechnungen) ist ein Wettlauf nach unten. Große Tech-Unternehmen bauen massive zentralisierte Rechenzentren, und Web3-Compute-Protokolle unterbieten sich ständig gegenseitig beim Preis. Berechnungen sind eine Ware.
Daten hingegen sind es nicht. Der größte Engpass in der KI heute ist nicht das Finden einer Grafikkarte; es ist das Erwerben von qualitativ hochwertigen, spezialisierten, nachweislich sauberen Daten zum Trainieren von Modellen. Die Architektur von OpenLedger – als EVM-kompatible Infrastruktur aufgebaut – konzentriert sich vollständig auf diese Datenpipeline. Durch das, was sie Datanets nennen, können Gemeinschaften spezialisierte Datensätze gemeinsam erstellen, hosten und kuratieren.
Betritt den Proof of Attribution (PoA)
Hier wird die Physik des $OPEN-Tokens interessant. Anstatt einen Standard-Mechanismus wie Proof of Work oder Proof of Stake zu verwenden, um lediglich Transaktionen zu sichern, implementiert OpenLedger Proof of Attribution (PoA) über seine Live-Mainnet-Infrastruktur.
💡 Proof of Attribution ist ein Protokoll-Mechanismus, der genau verfolgt, wie ein bestimmter Datensatz, LoRA oder Basis-Modell die Ausgabe eines endgültigen KI-Agenten beeinflusst.
Wenn ein KI-Modell bereitgestellt wird oder ein KI-Agent eine Anfrage beantwortet, verfolgt OpenLedger die Herkunft der verwendeten Daten zurück auf die Blockchain. Wenn deine beigetragenen Daten dazu beigetragen haben, dieses Modell zu verfeinern, verifiziert das Protokoll dies und stellt sicher, dass du anerkannt wirst.
Daher ist das $OPEN-Token nicht nur Gas, um einen Validator für Strom zu bezahlen; es fungiert als die primäre Abrechnungwährung für geistige Eigentumsrechte und Monetarisierung innerhalb des "Payable AI"-Ökosystems.
Was zu beobachten ist: Angebotsdynamik & Datenmonetarisierung
Während OpenLedger tiefer in den Mainnet-Lebenszyklus eindringt, basiert die Investitionsthese für $OPEN auf realen Metriken zur Protokolladoption:
Token-Nutzen: $OPEN wird verwendet, um Datanets zu starten, Model-Fabriken zu verwalten und automatisierte Anerkennungsbelohnungen an Datenkuratoren zu verteilen.
Der Rückkauf-Katalysator: Die OpenLedger-Infrastruktur nutzt die Einnahmen aus Netzwerkgebühren, um automatisierte Token-Mechanismen auszuführen. Wenn die Nutzung des Modells skaliert, skaliert der Kaufdruck auf dem Markt mechanisch mit.
Der Verdünnungstest: Behalte den makroökonomischen Horizont genau im Auge. Da die Zuteilungen an Team und Investoren einer linearen Freischaltungssequenz nach den anfänglichen Klippen unterliegen, muss das Datenvolumen des Netzwerks schnell genug wachsen, um die sich ändernde zirkulierende Versorgung aufzunehmen.
Die Quintessenz
Wenn du $OPEN nur als einen weiteren "dezentralen AWS-Kopierer" bewertest, siehst du den Wald vor lauter Bäumen nicht. OpenLedger versucht, das grundlegende Eigentumsbuch für KI-Assets zu schaffen. Wenn sie erfolgreich sind, wird $OPEN nicht nur ein KI-Token sein – es wird ein Index für den Wert der zugrunde liegenden Daten, die die Modelle antreiben.
Wettest du auf DeAI-Infrastruktur, die rohe Berechnungen skaliert, oder auf Protokolle, die die Datenschicht besitzen? Lass uns in den Kommentaren darüber sprechen! 👇
#OpenLedger #ArtificialIntelligence #Web3Tech h #CryptoAnalysis #DeAI