



Organisiert und zusammengestellt von: Sunny, Shechao TechFlow
Das Blockchain-KI-Computing-Protokoll Gensyn gab am 12. Juni bekannt, dass es eine von a16z angeführte Serie-A-Finanzierung in Höhe von 43 Millionen US-Dollar abgeschlossen hat.
Die Mission von Gensyn besteht darin, den Nutzern Zugang zu einer Rechenleistung zu verschaffen, die dem Besitz eines privaten Rechenclusters entspricht, und vor allem einen fairen Zugang zu erreichen, der die Kontrolle oder Abschaltung durch eine zentrale Instanz vermeidet. Mittlerweile ist Gensyn ein dezentrales Computerprotokoll, das sich auf das Training von Modellen für maschinelles Lernen konzentriert.
Wenn Sie auf den Podcast der Gensyn-Gründer Harry und Ben mit Epicenter Ende letzten Jahres zurückblicken, können Sie feststellen, dass sie ausführlich über die Untersuchung von Computerressourcen, einschließlich AWS, lokaler Infrastruktur und Cloud-Infrastruktur, diskutiert haben, um zu verstehen, wie diese Ressourcen optimiert und genutzt werden können unterstützen die Entwicklung von KI-Anwendungen.
Gleichzeitig diskutierten sie ausführlich die Designphilosophie, Ziele und Marktpositionierung von Gensyn sowie die verschiedenen Einschränkungen, Annahmen und Ausführungsstrategien, mit denen während des Designprozesses konfrontiert wurde.
Der Podcast stellt die vier Hauptrollen im Off-Chain-Netzwerk von Gensyn vor, untersucht die Merkmale des On-Chain-Netzwerks von Gensyn und die Bedeutung von Gensyn-Token und -Governance.
Darüber hinaus teilten Ben und Harry einige interessante KI-Wissenschaften, um allen ein tieferes Verständnis der Grundprinzipien und Anwendungen der künstlichen Intelligenz zu vermitteln.
Moderatorin: Dr. Friederike Ernst, Epicenter Podcast
Redner: Ben Fielding und Harry Grieve, Mitbegründer von Gensyn
Titel: „Ben Fielding und Harry Grieve: Gensyn – Das Deep Learning Compute Protocol“
Sendetermin: 24. November 2022
Blockchain als Vertrauensschicht für dezentrale KI-Infrastruktur
Der Moderator fragte Ben und Harry, warum sie ihre reiche Erfahrung in KI und Deep Learning mit Blockchain kombinierten?
Ben sagte, dass ihre Entscheidung nicht über Nacht, sondern nach relativ langer Zeit gefallen sei. Gensyns Ziel ist es, eine groß angelegte KI-Infrastruktur aufzubauen, und als sie nach Möglichkeiten suchten, maximale Skalierbarkeit zu erreichen, erkannten sie, dass eine vertrauenswürdige Schicht erforderlich war.
Sie müssen in der Lage sein, Rechenkapazitäten zu konsolidieren, ohne sich auf die zentrale Einbindung neuer Anbieter verlassen zu müssen oder auf administrative Erweiterungsbeschränkungen zu stoßen. Um dieses Problem zu lösen, begannen sie mit der Erforschung überprüfbarer Berechnungsforschung, stellten jedoch fest, dass hierfür immer ein vertrauenswürdiger Dritter oder Richter erforderlich war, um die Berechnung zu überprüfen.
Diese Einschränkung führte sie zur Blockchain. Blockchain bietet eine Möglichkeit, die Notwendigkeit eines einzelnen Entscheidungsträgers oder Schiedsrichters zu beseitigen, da es einen Konsens zwischen großen Gruppen ermöglicht.
Harry teilte auch seine Philosophie mit, dass er und Ben die freie Meinungsäußerung nachdrücklich unterstützen und sich Sorgen über Zensur machen.
Bevor sie zur Blockchain übergingen, befassten sie sich mit föderiertem Lernen, einem Bereich des Deep Learning, bei dem man mehrere Modelle auf verteilten Datenquellen trainiert und sie dann zusammenfügt, um ein Metamodell zu erstellen, das aus allen Datenquellen lernen kann. Sie arbeiten bei diesem Ansatz mit Banken zusammen. Sie erkannten jedoch bald, dass das größere Problem darin bestand, die Rechenressourcen oder Prozessoren zu beschaffen, mit denen diese Modelle trainiert werden konnten.
Um die Integration von Rechenressourcen zu maximieren, benötigen sie eine dezentrale Koordinationsmethode, und hier kommt die Blockchain ins Spiel.
Umfrage zu Market Computing Resources: AWS, On-Premise-Infrastruktur und Cloud-Infrastruktur
Harry erläuterte die unterschiedlichen Rechenressourcenoptionen für die Ausführung von KI-Modellen, abhängig von der Modellgröße.
Studenten können AWS oder lokale Maschinen nutzen, Start-ups können sich für AWS auf Abruf oder günstigere Optionen nach Zeitplan entscheiden.
Bei umfangreichen GPU-Anforderungen sind AWS jedoch möglicherweise durch Kosten und Skalierbarkeit eingeschränkt und entscheiden sich häufig für den Aufbau einer internen Infrastruktur.
Untersuchungen zeigen, dass viele Unternehmen Probleme mit der Skalierung haben und sich sogar dafür entscheiden, GPUs selbst zu kaufen und zu verwalten. Insgesamt ist der Kauf einer GPU auf lange Sicht kostengünstiger als der Betrieb auf AWS.
Zu den Optionen für Rechenressourcen für maschinelles Lernen gehören Cloud Computing, die lokale Ausführung von KI-Modellen oder der Aufbau eines eigenen Rechenclusters. Das Ziel von Gensyn besteht darin, den Zugriff auf die gleiche Rechenleistung wie bei einem eigenen Cluster zu ermöglichen, und der Schlüssel liegt darin, einen fairen Zugriff zu erreichen, der von keiner zentralen Stelle kontrolliert oder ausgeschaltet werden kann.
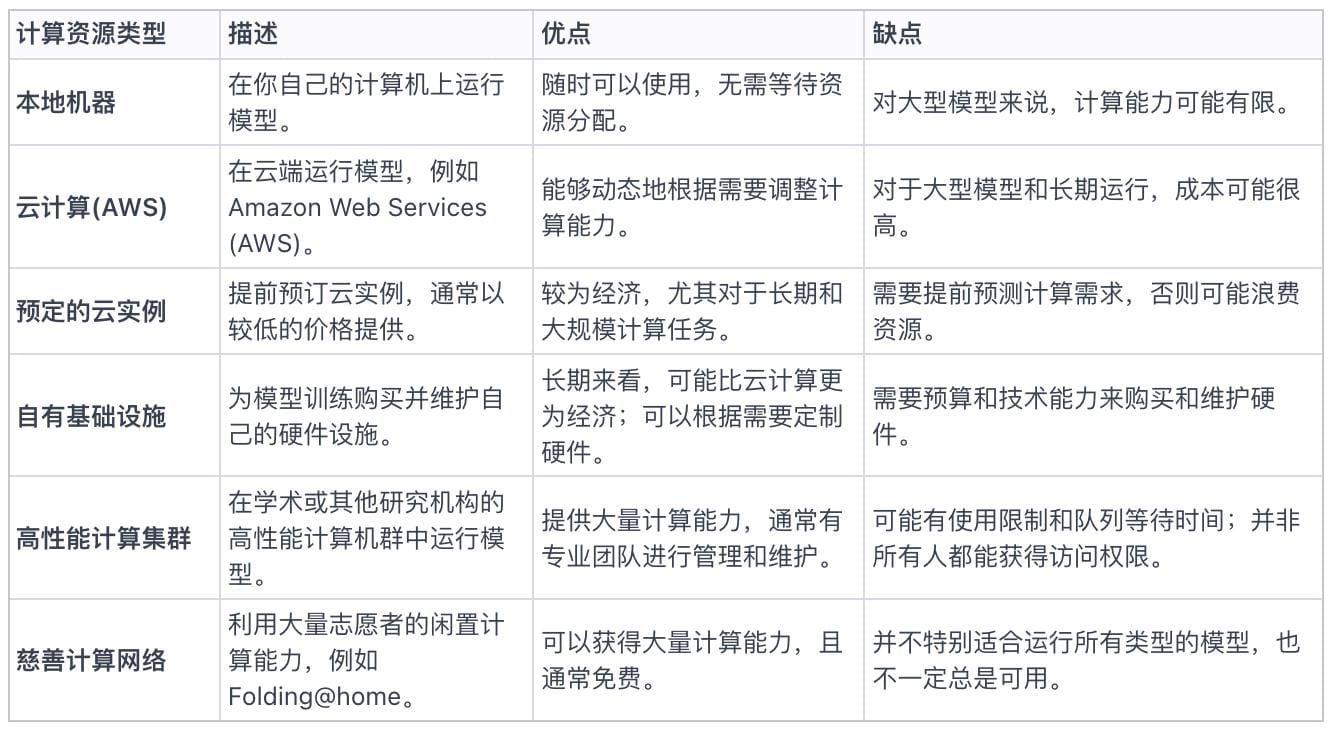
Tabelle 1: Alle derzeit auf dem Markt erhältlichen Rechenressourcenoptionen
Diskussion über Gensyns Designphilosophie, Ziele und Marktpositionierung
Der Moderator fragte, wie sich Gensyn von früheren Blockchain-Computing-Projekten wie Golem Network unterscheidet.
Harry erklärt, dass die Designphilosophie von Gensyn hauptsächlich entlang zweier Achsen betrachtet wird:
Die Granularität des Protokolls: Im Gegensatz zu allgemeinen Computerprotokollen wie Golem ist Gensyn ein granulares Protokoll, das sich auf das Training von Modellen für maschinelles Lernen konzentriert.
Verifizierte Skalierbarkeit: Frühe Projekte stützten sich oft auf Reputations- oder Replikationsmethoden, die weniger tolerant gegenüber byzantinischen Fehlern waren, was kein ausreichendes Vertrauen in die Ergebnisse des maschinellen Lernens bot. Das Ziel von Gensyn besteht darin, Erkenntnisse aus Rechenprotokollen in der Kryptowelt zu nutzen und sie speziell auf maschinelles Lernen anzuwenden, um Geschwindigkeit und Kosten zu optimieren und gleichzeitig ein zufriedenstellendes Verifizierungsniveau sicherzustellen.
Harry fügte hinzu, dass bei der Überlegung, welche Aufgaben das Netzwerk erfüllen muss, es auf Ingenieure und Forscher des maschinellen Lernens ausgerichtet sein muss. Es muss über eine Verifizierungskomponente verfügen, aber der Schlüssel liegt darin, dass es sowohl zensurresistent als auch hardwareneutral sein muss, um jedem die Teilnahme zu ermöglichen.
Einschränkungen, Annahmen und Ausführung während des Entwurfsprozesses
Während des Plattformdesignprozesses von Gensyn betonte Ben die Bedeutung von Systembeschränkungen und -annahmen. Ihr Ziel ist es, ein Netzwerk zu schaffen, das die ganze Welt in einen KI-Supercomputer verwandeln kann. Dazu müssen sie ein Gleichgewicht zwischen Produktannahmen, Forschungsannahmen und Technologieannahmen finden.
Ihre Begründung, warum sie Gensyn als ihre eigene First-Layer-Blockchain entwickelt haben, war die Aufrechterhaltung größerer Flexibilität und Entscheidungsfreiheit in wichtigen technischen Bereichen wie Konsensmechanismen. Sie möchten ihr Protokoll zukunftssicher machen und in den frühen Phasen des Projekts keine unnötigen Einschränkungen auferlegen. Darüber hinaus glauben sie, dass Ketten in Zukunft über ein weithin akzeptiertes Messaging-Protokoll interagieren können, sodass ihre Entscheidung im Einklang mit dieser Vision steht.
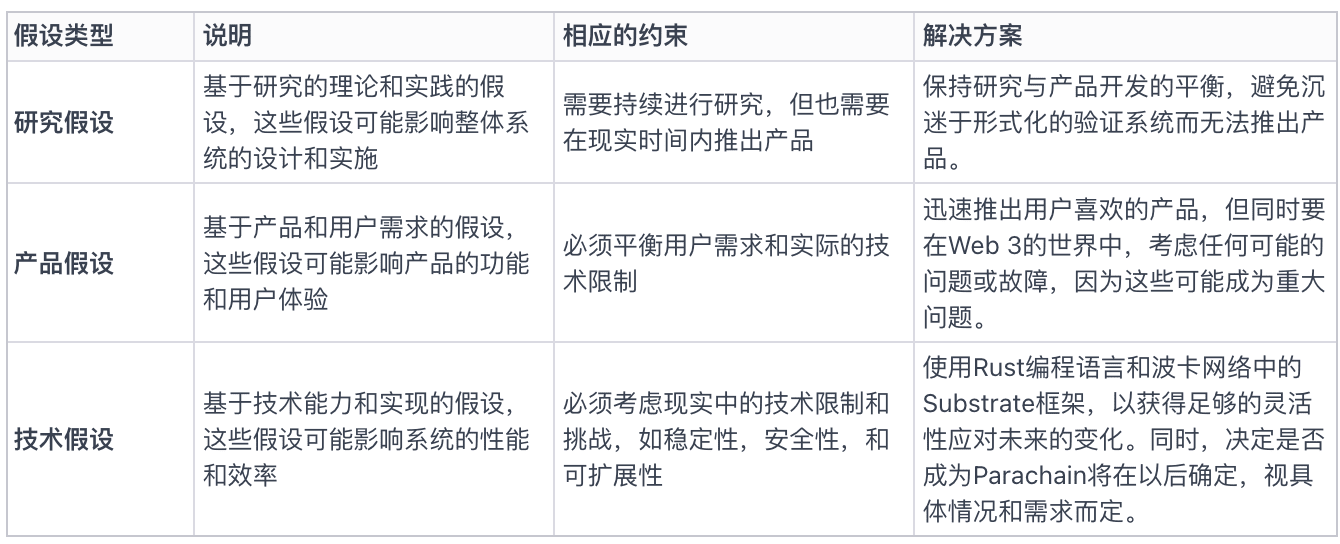
Abbildung 2: Produktannahmen, Forschungsannahmen und Technologieannahmen, Einschränkungen und Ausführung
Die vier Hauptakteure im Off-Chain-Netzwerk Gensyn
In dieser Diskussion der Gensyn-Wirtschaft werden vier Hauptrollen vorgestellt: Committer, Arbeiter, Validatoren und Whistleblower. Einreicher können eine Vielzahl von Problemen an das Gensyn-Netzwerk senden, darunter die Erstellung spezifischer Bilder oder die Entwicklung von KI-Modellen, die Autos fahren können.
Der Einreicher übermittelt die Aufgabe
Harry erklärt, wie man Gensyn zum Trainieren von Modellen verwendet. Der Benutzer definiert zunächst das gewünschte Ergebnis, beispielsweise die Generierung eines Bildes basierend auf einer Textaufforderung, und erstellt dann ein Modell, das die Textaufforderung als Eingabe verwendet und das entsprechende Bild generiert. Trainingsdaten sind für das Lernen und Verbessern von Modellen von entscheidender Bedeutung. Nach der Vorbereitung der Modellarchitektur und der Trainingsdaten übermitteln Benutzer diese zusammen mit Hyperparametern wie dem Lernratenplan und der Trainingsdauer an das Gensyn-Netzwerk. Das Ergebnis dieses Trainingsprozesses ist ein trainiertes Modell, das Benutzer hosten und verwenden können.
Auf die Frage, wie man ein untrainiertes Modell auswählt, schlug Harry zwei Methoden vor.
Das erste basiert auf dem derzeit beliebten Basismodellkonzept, bei dem große Unternehmen wie OpenAI oder Midjourney ein Basismodell erstellen und Benutzer das Basismodell dann anhand spezifischer Daten trainieren können.
Die zweite Möglichkeit besteht im Gegensatz zum Basismodellansatz darin, das Modell von Grund auf neu zu erstellen.
In Gensyn können Entwickler mithilfe von Methoden, die der evolutionären Optimierung ähneln, verschiedene Architekturen zum Training und Testen einreichen und kontinuierlich optimieren, um das gewünschte Modell zu erstellen.
Ben bietet einen detaillierten Einblick in das zugrunde liegende Modell aus ihrer Sicht, von dem sie glauben, dass es die Zukunft des Fachgebiets darstellt.
Wir hoffen, dass Gensyn als Protokoll von DApps verwendet werden kann, die evolutionäre Optimierungstechniken oder ähnliche Methoden implementieren. Diese DApps können einzelne Architekturen zum Training und Testen an das Gensyn-Protokoll senden und durch iterative Verfeinerung das ideale Modell erstellen.
Das Ziel von Gensyn besteht darin, eine rein maschinelle Lern-Computing-Grundlage bereitzustellen und die Entwicklung eines darauf aufbauenden Ökosystems zu fördern.
Während vorab trainierte Modelle zu Verzerrungen führen können, weil Unternehmen möglicherweise proprietäre Datensätze verwenden oder Informationen über den Trainingsprozess zurückhalten, besteht die Lösung von Gensyn darin, den Trainingsprozess zu öffnen, anstatt Black Boxes zu eliminieren oder sich auf vollständigen Determinismus zu verlassen. Durch das gemeinsame Entwerfen und Trainieren von Basismodellen können wir globale Modelle erstellen, ohne durch den Datensatz eines bestimmten Unternehmens beeinflusst zu werden.
Löser
Bei der Aufgabenverteilung entspricht eine Aufgabe einem Server. Ein Modell kann jedoch in mehrere Aufgaben aufgeteilt sein.
Große Sprachmodelle sind darauf ausgelegt, die jeweils maximal verfügbare Hardwarekapazität auszunutzen. Dieses Konzept kann auf Netzwerke erweitert werden, um die Geräteheterogenität zu berücksichtigen.
Für bestimmte Aufgaben, etwa Validatoren oder Worker, besteht die Möglichkeit, diese von Mempool zu übernehmen. Unter denjenigen, die sich bereit erklären, die Aufgabe zu übernehmen, wird nach dem Zufallsprinzip ein Mitarbeiter ausgewählt. Wenn das Modell und die Daten nicht an ein bestimmtes Gerät angepasst werden können, der Besitzer des Geräts dies aber behauptet, kann es zu Bußgeldern aufgrund von Systemüberlastungen kommen.
Ob eine Aufgabe auf einer Maschine ausgeführt werden kann, wird durch eine überprüfbare Zufallsfunktion bestimmt, die einen Worker aus einer Teilmenge der verfügbaren Worker auswählt.
Was die Frage der Überprüfung der Fähigkeiten von Arbeitnehmern anbelangt, so können Arbeitnehmer, die nicht über die angegebenen Rechenfähigkeiten verfügen, die Rechenaufgaben nicht ausführen, was bei der Einreichung des Nachweises festgestellt wird.
Allerdings ist die Größe der Aufgabe ein Problem. Wenn Aufgaben zu umfangreich festgelegt werden, kann dies zu Systemproblemen wie Denial-of-Service-Angriffen (DoS) führen, bei denen Mitarbeiter behaupten, die Aufgabe erledigt zu haben, diese aber nie erledigen, was Zeit und Ressourcen verschwendet.
Daher ist die Entscheidung über die Aufgabengröße von entscheidender Bedeutung und muss Faktoren wie Parallelisierung und optimierte Aufgabenstruktur berücksichtigen. Forscher untersuchen und erforschen aktiv die besten Methoden basierend auf verschiedenen Einschränkungen.
Sobald das Testnetz gestartet ist, werden auch praktische Bedingungen berücksichtigt, um zu beobachten, wie das System in der realen Welt funktioniert.
Die Definition der perfekten Aufgabengröße kann eine Herausforderung sein, und Gensyn ist bereit, basierend auf Feedback und Erfahrungen aus der Praxis Anpassungen und Verbesserungen vorzunehmen.
Verifizierungsmechanismus und Kontrollpunkte für umfangreiche Berechnungen in der Kette
Harry und Ben zeigen, dass die Überprüfung der Korrektheit einer Berechnung eine große Herausforderung darstellt, da sie nicht wie eine Hash-Funktion deterministisch ist und es daher nicht möglich ist, einfach durch Hashing zu überprüfen, ob eine Berechnung durchgeführt wurde. Um dieses Problem zu lösen, besteht die ideale Lösung darin, den gesamten Berechnungsprozess wissensfrei nachzuweisen. Derzeit arbeitet Gensyn noch an der Implementierung dieser Funktion.
Derzeit führt Gensyn einen Hybridansatz ein, der Checkpointing verwendet, um Berechnungen des maschinellen Lernens durch probabilistische Mechanismen und Checkpointing zu überprüfen. Durch die Kombination eines stochastischen Prüfschemas mit Gradientenraumpfaden kann eine relativ robuste Prüfung erstellt werden. Darüber hinaus werden wissensfreie Beweise eingeführt, um den Verifizierungsprozess zu verbessern und auf den globalen Verlust des Modells angewendet.
Gutachter und Whistleblower
Der Moderator und Harry besprachen die beiden zusätzlichen Rollen im Verifizierungsprozess: Verifizierer und Whistleblower. Sie beschreiben detailliert die spezifischen Verantwortlichkeiten und Rollen dieser beiden Rollen.
Die Aufgabe des Validators besteht darin, die Korrektheit der Kontrollpunkte sicherzustellen, während die Aufgabe des Whistleblowers darin besteht, die Genauigkeit sicherzustellen, mit der der Validator seine Aufgaben erfüllt. Whistleblower lösen das Dilemma des Prüfers und stellen sicher, dass die Arbeit des Prüfers korrekt und vertrauenswürdig ist. Prüfer führen absichtlich Fehler in ihre Arbeit ein, und die Rolle des Hinweisgebers besteht darin, diese Fehler zu identifizieren und aufzudecken und so die Integrität des Überprüfungsprozesses sicherzustellen.
Prüfer führen absichtlich Fehler ein, um die Aufmerksamkeit von Hinweisgebern zu testen und die Wirksamkeit des Systems sicherzustellen. Wenn bei der Arbeit ein Fehler vorliegt, erkennt der Validator den Fehler und benachrichtigt den Reporter. Der Fehler wird dann in der Blockchain aufgezeichnet und in der Kette überprüft. In regelmäßigen Abständen und in einem für die Sicherheit des Systems relevanten Tempo führen Prüfer absichtlich Fehler ein, um Whistleblower zu beschäftigen. Wenn Whistleblower ein Problem finden, nehmen sie an einem Spiel namens „Pinpoint-Protokoll“ teil, mit dem sie die Berechnung auf einen bestimmten Punkt im Merkle-Baum einer bestimmten Region des neuronalen Netzwerks eingrenzen können. Diese Informationen werden dann einem On-Chain-Schiedsverfahren vorgelegt. Dies ist eine vereinfachte Version des Prozesses für Validatoren und Whistleblower, die nach der Seed-Runde weitere Entwicklungen und Forschungen durchführen.
Gensyn-On-Chain-Netzwerk
Ben und Harry besprachen ausführlich, wie das Gensyn-Koordinierungsprotokoll in der Kette funktioniert und welche Implementierungsdetails es gibt. Sie erwähnten zunächst den Prozess des Aufbaus von Netzwerkblöcken, der das Abstecken von Token als Teil dieses Abstecknetzwerks beinhaltet. Anschließend erklären sie, wie diese Komponenten mit dem Gensyn-Protokoll zusammenhängen.
Ben erklärte, dass das Gensyn-Protokoll größtenteils ein Polkadot-Netzwerkprotokoll mit Vanilla-Substrat ist. Sie wenden den Grandpa Babe-Konsensmechanismus an, der auf dem Nachweis des Einsatzes basiert, und die Validatoren arbeiten auf die übliche Weise. Allerdings finden alle zuvor eingeführten maschinellen Lernkomponenten außerhalb der Kette statt, wobei verschiedene Akteure außerhalb der Kette ihre jeweiligen Aufgaben ausführen.
Diese Teilnehmer erhalten Anreize durch Abstecken, entweder über den Absteckabschnitt in Substrate oder durch die Übermittlung einer bestimmten Anzahl von Token in einem Smart Contract. Wenn ihre Arbeit endgültig überprüft wird, werden sie belohnt.
Die von Ben und Harry erwähnte Herausforderung besteht darin, ein Gleichgewicht zwischen Einsatzbeträgen, möglichen Einsatzreduzierungsbeträgen und Belohnungsbeträgen sicherzustellen, um die Schaffung von Anreizen für faules oder böswilliges Verhalten zu verhindern.
Darüber hinaus erörterten sie die Komplexität, die mit der Hinzufügung von Hinweisgebern einhergeht, deren Anwesenheit jedoch aufgrund der Anforderungen der Skalierungsberechnung von entscheidender Bedeutung ist, um die Ehrlichkeit der Prüfer zu gewährleisten. Während sie weiterhin nach Möglichkeiten suchen, Whistleblower durch wissensfreie Technologie zu eliminieren. Sie gaben an, dass das aktuelle System mit der Beschreibung im Lite-Paper übereinstimmt, sie arbeiten jedoch aktiv daran, jeden Aspekt zu vereinfachen.
Der Moderator fragte, ob sie eine Art Datenverfügbarkeitslösung hätten, und Henry erklärte, dass sie auf dem Substrat eine Schicht namens Proof of Availability (POA) eingeführt hätten. Diese Schicht nutzt Technologien wie Erasure Coding, um die Einschränkungen zu überwinden, denen sie auf dem breiten Markt für Speicherebenen begegnen. Sie sagten, dass sie großes Interesse an Entwicklern hätten, die eine solche Lösung bereits implementiert haben.
Ben fügte hinzu, dass ihre Anforderungen nicht nur die Speicherung von Trainingsdaten umfassen, sondern auch Zwischennachweisdaten, die keine Langzeitspeicherung erfordern. Beispielsweise müssen sie möglicherweise nur etwa 20 Sekunden warten, wenn sie mit der Veröffentlichung einer bestimmten Anzahl von Blöcken fertig sind. Allerdings decken die derzeit auf Arweave gezahlten Speichergebühren Hunderte von Jahren ab und sind für diesen kurzfristigen Bedarf nicht erforderlich. Sie suchten nach einer Lösung, die die Garantien und Funktionen von Arweave bietet und gleichzeitig ihren kurzfristigen Speicherbedarf zu geringeren Kosten erfüllt.
Gensyn-Token und Governance
Ben erklärte die Bedeutung des Gensyn-Tokens im Ökosystem, da er eine Schlüsselrolle beim Abstecken, Bestrafen, Bereitstellen von Belohnungen und der Aufrechterhaltung des Konsenses spielt. Sein Hauptzweck besteht darin, die finanzielle Solidität und Integrität des Systems sicherzustellen. Ben erwähnte auch den sorgfältigen Einsatz von Inflationsraten zur Bezahlung von Validatoren und die Nutzung spieltheoretischer Mechanismen.
Er betonte die rein technische Verwendung des Gensyn-Tokens und sagte, dass man den Zeitpunkt und die Notwendigkeit der Einführung des Gensyn-Tokens technisch sicherstellen werde.
Harry sagte, sie seien innerhalb der Deep-Learning-Community in der Minderheit, insbesondere angesichts der weit verbreiteten Skepsis unter KI-Wissenschaftlern gegenüber Kryptowährungen. Dennoch erkennen sie den Wert sowohl der technischen als auch der ideologischen Aspekte von Kryptowährungen.
Beim Start des Netzwerks gehen sie jedoch davon aus, dass die meisten Deep-Learning-Benutzer Transaktionen hauptsächlich mit Fiat-Währungen abwickeln werden und die Umwandlung in Token nahtlos hinter den Kulissen erfolgen wird.
Auf der Angebotsseite werden Arbeiter und Committer aktiv am Handel mit Token beteiligt sein und erhalten bereits Interesse von Ethereum-Minern, die über erhebliche GPU-Ressourcen verfügen und nach neuen Möglichkeiten suchen.
Hier ist es wichtig sicherzustellen, dass die Furcht der Deep-Learning- und Machine-Learning-Praktiker vor der Kryptowährungsterminologie (z. B. Token) beseitigt und diese von der Schnittstelle des Benutzererlebnisses entkoppelt wird. Gensyn sagt, dass dies ein spannender Anwendungsfall ist, der die Welten von Web 2 und Web 3 verbindet, weil er wirtschaftlich sinnvoll ist und die Technologie zur Unterstützung seiner Existenz erforderlich ist.
Populärwissenschaftliche künstliche Intelligenz
KI, Deep Learning und maschinelles Lernen
Ben teilte seine Ansichten zur Entwicklung des KI-Bereichs in den letzten Jahren. Er glaubt, dass der Bereich KI und maschinelles Lernen zwar in den letzten sieben Jahren eine Reihe kleinerer Explosionen erlebt hat, die aktuellen Fortschritte jedoch offenbar echte Auswirkungen und wertvolle Anwendungen haben, die bei einem breiteren Publikum Anklang finden. Deep Learning ist ein grundlegender Treiber dieser Veränderungen. Tiefe neuronale Netze haben ihre Fähigkeit unter Beweis gestellt, die von herkömmlichen Computer-Vision-Methoden gesetzten Maßstäbe zu übertreffen. Darüber hinaus haben Modelle wie GPT-3 diesen Fortschritt beschleunigt.
Harry erklärte außerdem die Unterschiede zwischen KI, maschinellem Lernen und Deep Learning. Er glaubt, dass diese drei Begriffe oft synonym verwendet werden, es jedoch erhebliche Unterschiede gibt. Er sagte metaphorisch, dass KI, maschinelles Lernen und Deep Learning wie russische Matroschka-Puppen seien, wobei KI die äußerste Schicht sei.
Im Großen und Ganzen bezieht sich KI auf die Programmierung von Maschinen zur Ausführung von Aufgaben.
Maschinelles Lernen, das in den 1990er und frühen 2000er Jahren populär wurde, nutzt Daten, um die Wahrscheinlichkeit von Entscheidungen zu bestimmen, anstatt sich auf Expertensysteme mit Wenn-Dann-Regeln zu verlassen.
Deep Learning baut auf maschinellem Lernen auf, ermöglicht jedoch komplexere Modelle.
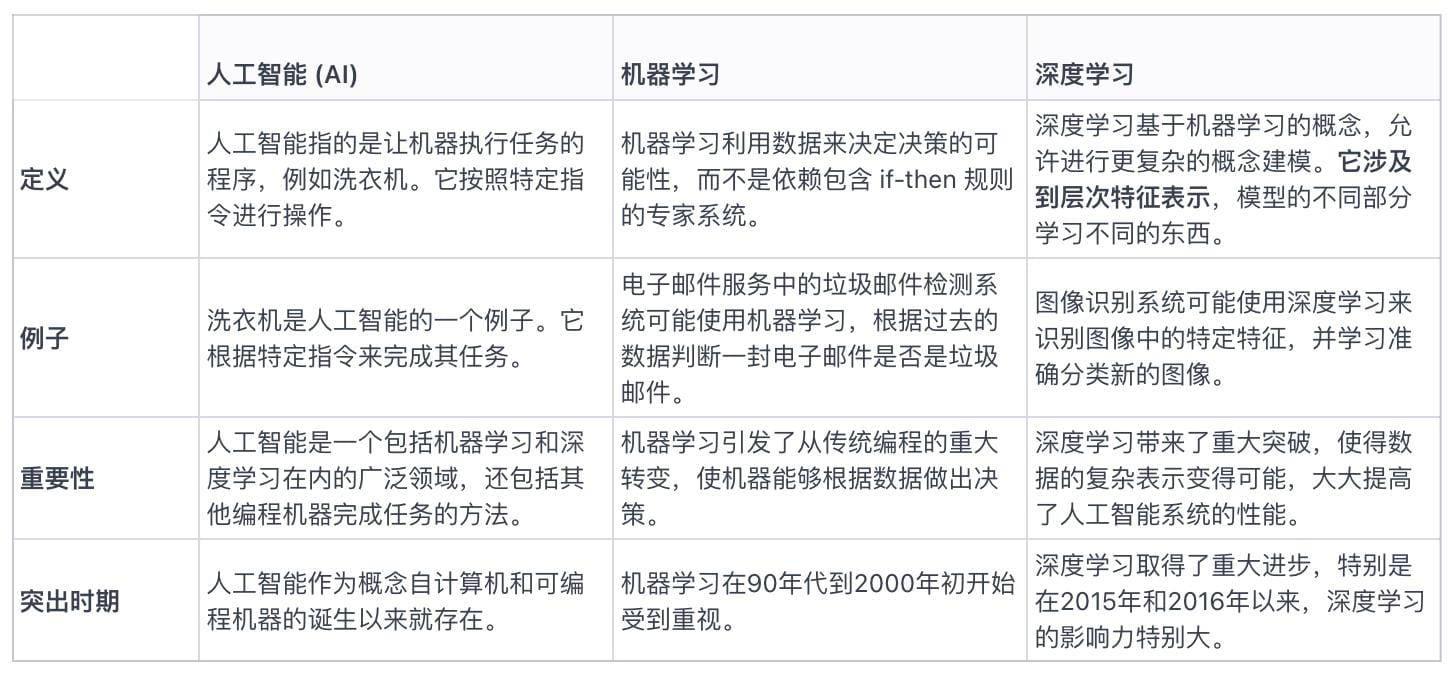
Abbildung 3: Der Unterschied zwischen künstlicher Intelligenz, maschinellem Lernen und Deep Learning
Künstliche enge Intelligenz, künstliche allgemeine Intelligenz, künstliche Superintelligenz
In diesem Segment bieten Gastgeber und Gäste einen detaillierten Einblick in drei Schlüsselbereiche der künstlichen Intelligenz: künstliche Narrow Intelligence (ANI), künstliche allgemeine Intelligenz (AGI) und künstliche Superintelligenz (ASI).
Künstliche Narrow Intelligence (ANI): Die aktuelle KI befindet sich hauptsächlich in diesem Stadium, in dem Maschinen sehr gut darin sind, bestimmte Aufgaben auszuführen, beispielsweise die Erkennung bestimmter Krebsarten anhand medizinischer Scans durch Mustererkennung.
Künstliche Allgemeine Intelligenz (AGI): AGI bezieht sich auf die Fähigkeit von Maschinen, Aufgaben auszuführen, die für Menschen relativ einfach sind, in Computersystemen jedoch sehr anspruchsvoll sind. Ein Beispiel für AGI ist es, einer Maschine zu ermöglichen, reibungslos durch eine überfüllte Umgebung zu navigieren und dabei diskrete Annahmen über alle umgebenden Eingaben zu treffen. AGI bezieht sich auf die Fähigkeit eines Modells oder Systems, alltägliche Aufgaben wie ein Mensch auszuführen.
Künstliche Superintelligenz (ASI): Nach Erreichen der künstlichen allgemeinen Intelligenz können sich Maschinen zu künstlicher Superintelligenz weiterentwickeln. Damit ist die Fähigkeit von Maschinen gemeint, menschliche Fähigkeiten aufgrund der Komplexität ihrer Modelle, erhöhter Rechenleistung, unbegrenzter Lebensdauer und perfektem Gedächtnis zu übertreffen. Dieses Konzept wird häufig in Science-Fiction- und Horrorfilmen untersucht.
Darüber hinaus erwähnten die Gäste auch, dass die Integration des menschlichen Gehirns und der Maschinen, beispielsweise durch Gehirn-Computer-Schnittstellen, ein Weg zur Erreichung von AGI sein könnte, dies jedoch auch eine Reihe moralischer und ethischer Fragen aufwirft.
Die Blackbox des Deep Learning erschließen: deterministisch versus probabilistisch
Ben erklärt, dass der Black-Box-Charakter von Deep-Learning-Modellen auf ihre schiere Größe zurückzuführen ist. Sie verfolgen immer noch einen Weg durch eine Reihe von Entscheidungspunkten im Netzwerk. Dieser Pfad ist jedoch sehr lang und es ist schwierig, die Gewichte oder Parameter innerhalb des Modells mit ihren spezifischen Werten zu verknüpfen, da diese Werte nach der Eingabe von Millionen von Stichproben abgeleitet werden. Sie können dies zwar tun und jede Aktualisierung verfolgen, aber die Datenmenge, die Sie am Ende generieren, wird sehr groß sein.
Er sah zwei Dinge geschehen:
Je mehr wir über die von uns erstellten Modelle verstehen, desto mehr verschwindet der Black-Box-Charakter. Deep Learning ist ein Forschungsgebiet, das eine interessante und rasante Phase mit vielen Experimenten durchlaufen hat, die nicht auf den Grundlagen der Forschung beruhten. Es geht vielmehr darum, zu sehen, was wir daraus machen können. Also werfen wir mehr Daten hinein, probieren neue Architekturen aus und sehen einfach, was passiert, anstatt bei den ersten Prinzipien zu beginnen, das Ding zu entwerfen und genau zu wissen, wie es funktioniert. Es gab also diese aufregende Zeit, in der alles eine Black Box war. Aber er glaubt, dass sich dieses schnelle Wachstum langsam verlangsamt, und wir sehen, wie Menschen diese Architekturen erneut betrachten und sagen: „Warum funktioniert das so gut? Lassen Sie uns tiefer in die Materie eintauchen und es beweisen.“ wird aufgehoben.
Eine andere, vielleicht kontroversere Sache ist ein Meinungswandel darüber, ob Computersysteme vollständig deterministisch sein müssen oder ob wir in einer probabilistischen Welt leben können. Wir als Menschen leben in einer probabilistischen Welt. Das Beispiel des selbstfahrenden Autos ist vielleicht am deutlichsten. Wenn wir fahren, akzeptieren wir, dass zufällige Ereignisse passieren, es zu kleineren Unfällen kommen kann und dass es Probleme mit dem selbstfahrenden Autosystem geben kann. Aber wir können dies überhaupt nicht akzeptieren und sagen, dass dies ein völlig deterministischer Prozess sein muss. Eine der Herausforderungen in der Branche der selbstfahrenden Autos besteht darin, dass sie davon ausgehen, dass die Menschen die probabilistischen Mechanismen akzeptieren, die für selbstfahrende Autos gelten, dies jedoch in Wirklichkeit nicht der Fall ist. Er glaubt, dass sich dies ändern wird, und es könnte umstritten sein, ob wir als Gesellschaft zulassen werden, dass probabilistische Computersysteme mit uns koexistieren? Er ist sich nicht sicher, ob der Weg glatt sein wird, aber er glaubt, dass es passieren wird.
Gradientenoptimierungsmethode: die Kernoptimierungsmethode des Deep Learning
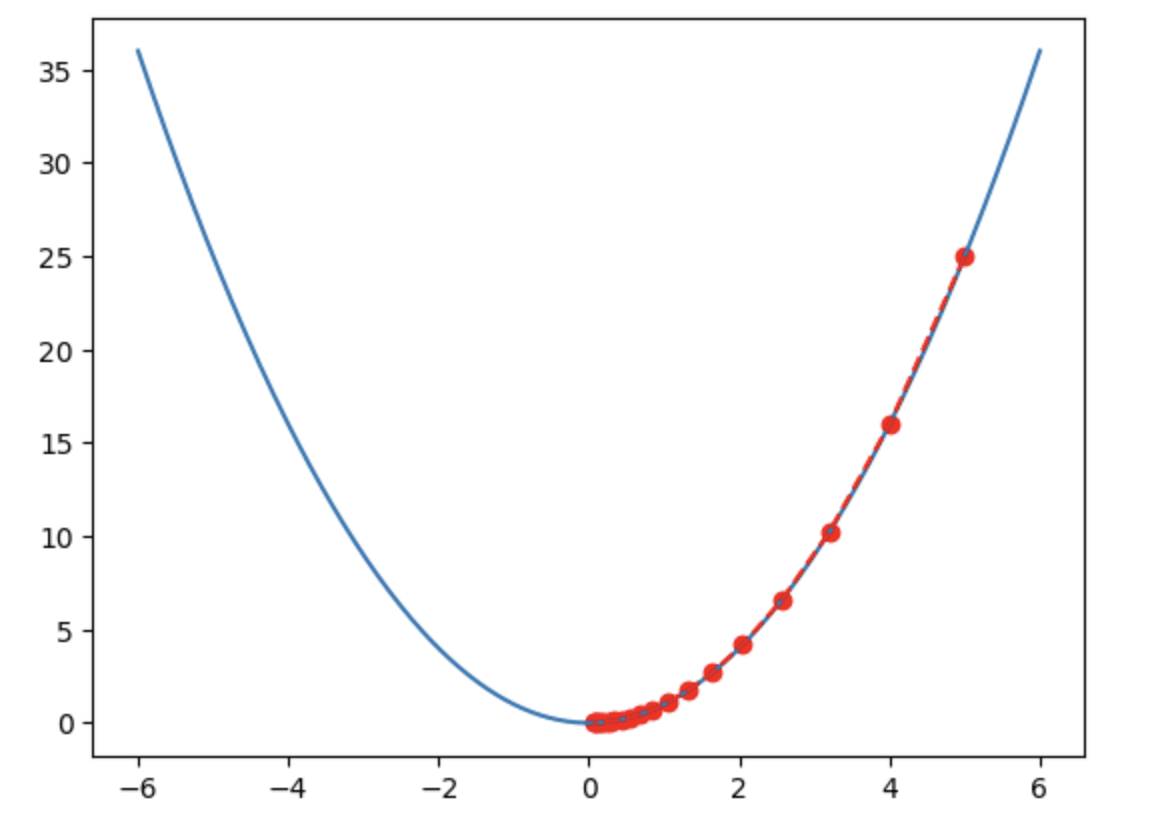
Die Gradientenoptimierung ist eine der Kernmethoden des Deep Learning und spielt eine Schlüsselrolle beim Training neuronaler Netze. In neuronalen Netzen sind eine Reihe von Schichtparametern im Wesentlichen reelle Zahlen. Beim Netzwerktraining werden diese Parameter auf realistische Werte eingestellt, die eine korrekte Weitergabe der Daten ermöglichen und die gewünschte Ausgabe in den Endphasen des Netzwerks auslösen.
Gradientenbasierte Optimierungsmethoden haben enorme Veränderungen in den Bereichen neuronale Netze und Deep Learning mit sich gebracht. Diese Methode verwendet Gradienten, die die Differenzierung der Parameter jeder Schicht im Netzwerk in Bezug auf den Fehler darstellen. Durch die Anwendung der Kettenregel können Gradienten im gesamten hierarchischen Netzwerk rückwärts propagiert werden. In diesem Prozess können Sie feststellen, wo Sie sich auf der Fehleroberfläche befinden. Fehler können als Fläche im euklidischen Raum modelliert werden, die als Region voller Höhen und Tiefen erscheint. Das Ziel der Optimierung besteht darin, den Bereich zu finden, der den Fehler minimiert.
Der Verlauf zeigt für jede Ebene an, wo Sie sich auf der Oberfläche befinden und in welche Richtung Sie die Parameter aktualisieren sollten. Sie können Steigungen verwenden, um auf dieser welligen Oberfläche zu navigieren und Richtungen zu finden, die Fehler reduzieren. Die Größe der Stufe hängt von der Neigung der Oberfläche ab. Wenn es steil ist, springen Sie weiter; wenn es nicht steil ist, springen Sie kleiner. Im Wesentlichen navigieren Sie lediglich über die Oberfläche und suchen nach einer Rille. Der Verlauf hilft Ihnen dabei, Position und Richtung zu bestimmen.
Diese Methode war ein großer Durchbruch, da Steigungen ein klares Signal und eine nützliche Richtung liefern, die Ihnen viel effektiver zeigen, wo Sie sich an der Oberfläche befinden und wo Sie sich befinden, als zufällige Sprünge im Parameterraum auf dem Gipfel des Berges durchzuführen immer noch in Schluchten oder in flachen Gebieten.
Obwohl es im Deep Learning viele Techniken gibt, um das Problem der optimalen Lösung zu lösen, ist die Situation in der realen Welt oft komplexer. Es gibt viele Regularisierungstechniken, die im Deep-Learning-Training eingesetzt werden, was es eher zu einer Kunst als zu einer Wissenschaft macht. Und deshalb ist die Gradientenoptimierung im wirklichen Leben eher eine Kunst als eine exakte Wissenschaft.
Zusammenfassen
Das Ziel von Gensyn besteht darin, das weltweit größte Computerressourcensystem für maschinelles Lernen aufzubauen, das ungenutzte oder nicht ausreichend genutzte Computerressourcen wie persönliche Smartphones, Computer und andere Geräte vollständig nutzen kann.
Im Zusammenhang mit maschinellem Lernen und Blockchain sind die im Ledger gespeicherten Aufzeichnungen normalerweise Ergebnisse von Berechnungen, also der Zustand der Daten, die wir durch maschinelles Lernen verarbeitet haben. Dieser Status kann lauten: „Ich habe diese Datenwelle maschinell gelernt, sie ist gültig und sie ist in X Jahr und X Monat aufgetreten.“ Das Hauptziel dieses Datensatzes besteht darin, den resultierenden Status auszudrücken und nicht den Berechnungsprozess detailliert darzustellen.
In diesem Rahmen spielt Blockchain eine wichtige Rolle:
Blockchain bietet eine Möglichkeit, die Ergebnisse des Datenstatus aufzuzeichnen. Es soll die Authentizität der Daten sicherstellen und Manipulation und Ablehnung verhindern.
Innerhalb der Blockchain gibt es einen wirtschaftlichen Anreizmechanismus, durch den das Verhalten verschiedener Rollen im Computernetzwerk koordiniert werden kann, beispielsweise der vier genannten Rollen: Einreicher, Arbeiter, Prüfer und Hinweisgeber.
Durch eine Untersuchung des aktuellen Cloud-Computing-Marktes haben wir herausgefunden, dass Cloud Computing nicht völlig unerwünscht ist, sondern dass verschiedene Computing-Methoden ihre eigenen spezifischen Probleme haben. Die dezentrale Rechenmethode Blockchain kann in einigen Szenarien eine Rolle spielen, aber sie kann das traditionelle Cloud Computing nicht vollständig ersetzen. Mit anderen Worten: Blockchain ist keine Allheilmittellösung.
Schließlich kann KI als eine Art Produktivität betrachtet werden. Wie man KI jedoch effektiv organisiert und trainiert, gehört zur Kategorie der Produktionsbeziehungen. Dazu gehören Faktoren wie Zusammenarbeit, Crowdsourcing und Anreize. Das Web 3.0 bietet diesbezüglich eine Vielzahl möglicher Lösungsansätze und Szenarien.
Daher können wir verstehen, dass die Kombination von Blockchain und KI, insbesondere im Hinblick auf die gemeinsame Nutzung von Daten und Modellen, die Koordination von Computerressourcen und die Überprüfung von Ergebnissen, neue Lösungen für einige Probleme bei der Schulung und Nutzung von KI bietet.
Zitat
1. https://docs.gensyn.ai/litepaper/
2. https://a16zcrypto.com/posts/announcement/investing-in-gensyn/