

#dataprovenance
dataprovenance
640 Aufrufe
9 Kommentare
Hot
Zuletzt
·
--
Was @Openledger für mich interessant macht, ist, dass es sich der KI aus einer Richtung nähert, die die meisten Projekte meiden: Entropie.
Während KI-Systeme skalieren, wird das Internet mit synthetischen Inhalten, duplizierten Datensätzen und rekursiv generiertem Rauschen gesättigt. Das Problem ist nicht mehr der Zugang zu Informationen. Das Problem ist, zu verifizieren, ob die Informationen noch ein Signal tragen.
Das verändert die Wirtschaftlichkeit von KI komplett.
Jahrelang ging die Branche davon aus, dass größere Modelle automatisch bessere Ergebnisse erzielen. Aber die Skalierung der Modelle stößt bereits an Effizienzgrenzen. Die Trainingskosten steigen exponentiell, während die Gewinne zunehmend inkrementell werden. Gleichzeitig wird qualitativ hochwertiger, menschlich generierter Daten immer seltener, gerade weil KI-Systeme die gleichen Informationsschleifen immer wieder konsumieren und reproduzieren.
Hier wird die Attributionsschicht hinter #OpenLedger wichtiger, als die Leute realisieren.
Wenn Mitwirkende, Datensätze und Wissensquellen wirtschaftlich nachverfolgbar innerhalb von KI-Pipelines werden, könnte sogar die vertrauenswürdige Datenherkunft ein Wettbewerbsvorteil werden. Nicht das größte Modell. Nicht das lauteste Narrativ. Das sauberste Signal.
Historisch gesehen hat jede große Informationsökonomie letztendlich eine Verifizierungsinfrastruktur aufgebaut:
Finanzmärkte haben Audits aufgebaut,
das Internet hat Suchrankings aufgebaut,
Blockchains haben Konsens aufgebaut.
KI könnte sich nun ihrer eigenen Verifizierungsära nähern.
Deshalb fühlt sich $OPEN weniger wie ein standardmäßiges KI-Token-Narrativ an und mehr wie ein Versuch, die bevorstehende Vertrauenskrise zwischen Modellen, Daten und menschlichem Beitrag zu lösen.
#OpenLedger #AIInfrastructure #DataProvenance #SyntheticData #AIAlignmen
Was @OpenLedger für mich interessant macht, ist, dass es sich der KI aus einer Richtung nähert, die die meisten Projekte meiden: Entropie.
Während KI-Systeme skalieren, wird das Internet mit synthetischen Inhalten, duplizierten Datensätzen und rekursiv generiertem Rauschen gesättigt. Das Problem ist nicht mehr der Zugang zu Informationen. Das Problem ist, zu verifizieren, ob die Informationen noch ein Signal tragen.
Das verändert die Wirtschaftlichkeit von KI komplett.
Jahrelang ging die Branche davon aus, dass größere Modelle automatisch bessere Ergebnisse erzielen. Aber die Skalierung der Modelle stößt bereits an Effizienzgrenzen. Die Trainingskosten steigen exponentiell, während die Gewinne zunehmend inkrementell werden. Gleichzeitig wird qualitativ hochwertiger, menschlich generierter Daten immer seltener, gerade weil KI-Systeme die gleichen Informationsschleifen immer wieder konsumieren und reproduzieren.
Hier wird die Attributionsschicht hinter #OpenLedger wichtiger, als die Leute realisieren.
Wenn Mitwirkende, Datensätze und Wissensquellen wirtschaftlich nachverfolgbar innerhalb von KI-Pipelines werden, könnte sogar die vertrauenswürdige Datenherkunft ein Wettbewerbsvorteil werden. Nicht das größte Modell. Nicht das lauteste Narrativ. Das sauberste Signal.
Historisch gesehen hat jede große Informationsökonomie letztendlich eine Verifizierungsinfrastruktur aufgebaut:
Finanzmärkte haben Audits aufgebaut,
das Internet hat Suchrankings aufgebaut,
Blockchains haben Konsens aufgebaut.
KI könnte sich nun ihrer eigenen Verifizierungsära nähern.
Deshalb fühlt sich $OPEN weniger wie ein standardmäßiges KI-Token-Narrativ an und mehr wie ein Versuch, die bevorstehende Vertrauenskrise zwischen Modellen, Daten und menschlichem Beitrag zu lösen.
#OpenLedger #AIInfrastructure #DataProvenance #SyntheticData #AIAlignmen
1
53

·
--
Verifiziert
#openledger $OPEN
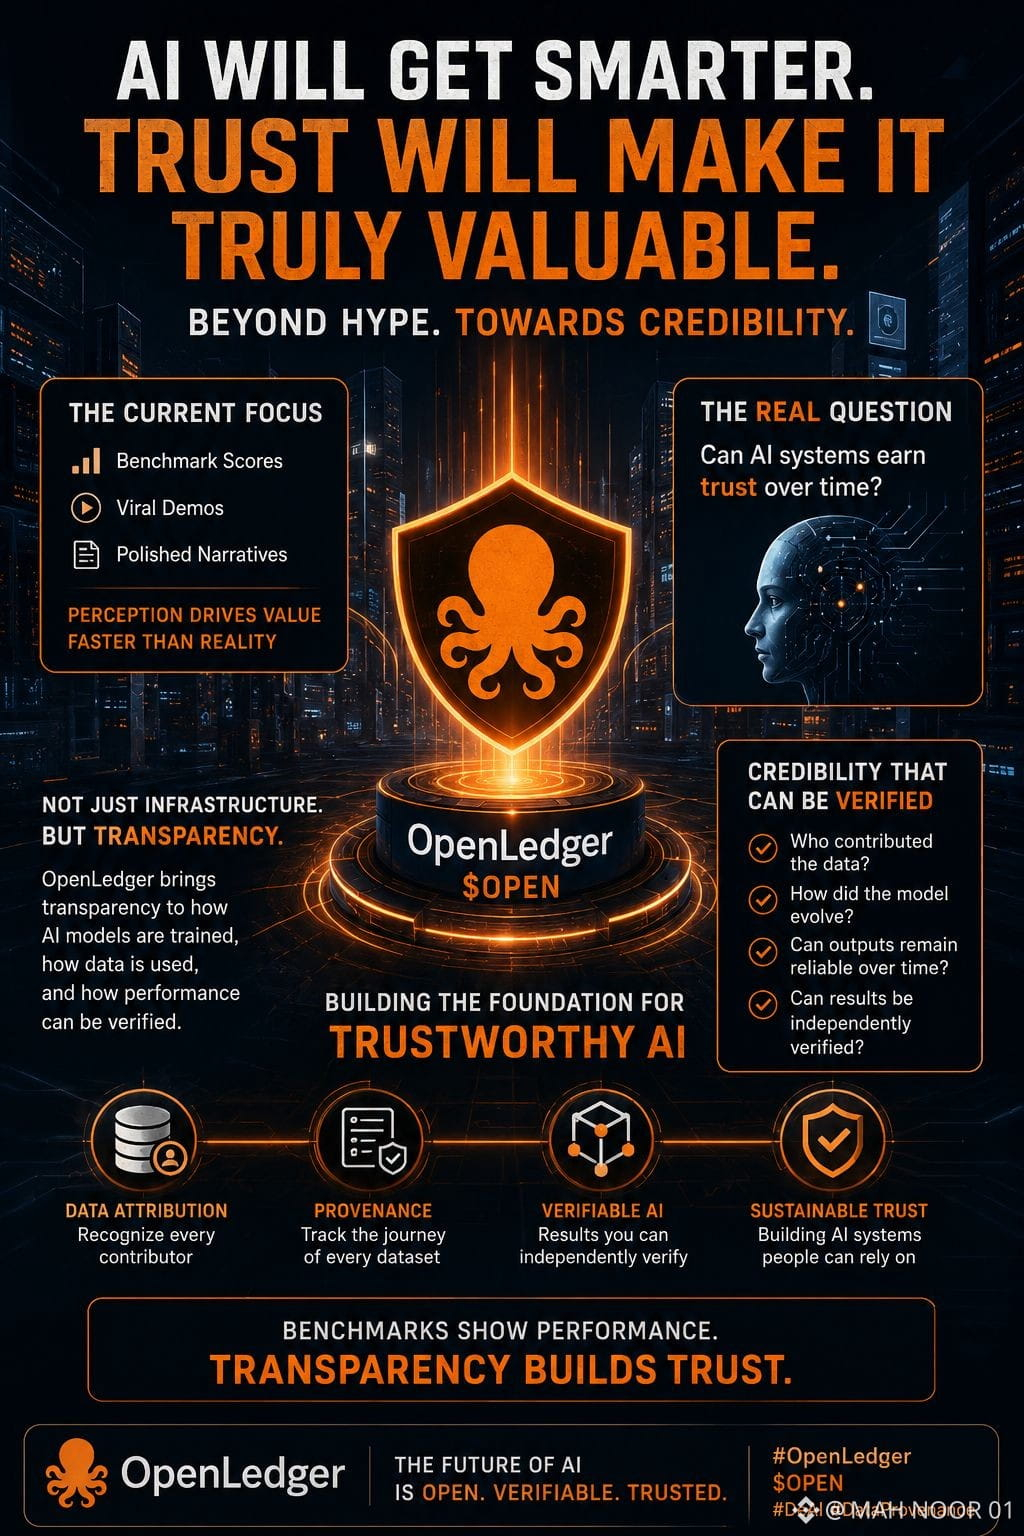
Die meisten Leute konzentrieren sich darauf, wie mächtig KI wird.
Ich denke, die größere Frage ist, ob KI-Systeme tatsächlich im Laufe der Zeit Vertrauen verdienen können.
Im Moment geht die Aufmerksamkeit normalerweise auf Benchmark-Werte, virale Demos und polierte Erzählungen. Ein Modell schneidet auf dem Papier gut ab, der Markt reagiert sofort, und die Wahrnehmung beginnt, den Wert schneller zu treiben als die reale Zuverlässigkeit.
Aber letztendlich schaffen Systeme, die um Hype herum aufgebaut sind, Anreize, um für Sichtbarkeit statt für Konsistenz zu optimieren.
Deshalb finde ich Projekte wie OpenLedger ($OPEN) interessant.
Die Idee geht nicht nur darum, die KI-Infrastruktur zu unterstützen. Es geht darum, Transparenz darüber zu schaffen, wie Modelle trainiert werden, woher die Daten kommen und ob Leistungsbehauptungen über das Marketing hinaus verifiziert werden können.
Wenn Attribution und Herkunft in das Ökosystem selbst eingebettet werden, wird Glaubwürdigkeit messbar statt angenommen.
Wer hat die Daten beigetragen?
Wie hat sich das Modell entwickelt?
Können Ausgaben über die Zeit hinweg zuverlässig bleiben?
Können Ergebnisse unabhängig verifiziert werden?
Diese Fragen könnten wichtiger werden als Benchmark-Screenshots.
KI wird weiterhin intelligenter, aber die Plattformen, die helfen, KI vertrauenswürdig zu machen, könnten langfristig noch wertvoller werden.
#OpenLedger $OPEN #DeAI #DataProvenance
#BinanceSquare
{future}(OPENUSDT)
#openledger $OPEN
Die meisten Leute konzentrieren sich darauf, wie mächtig KI wird.
Ich denke, die größere Frage ist, ob KI-Systeme tatsächlich im Laufe der Zeit Vertrauen verdienen können.
Im Moment geht die Aufmerksamkeit normalerweise auf Benchmark-Werte, virale Demos und polierte Erzählungen. Ein Modell schneidet auf dem Papier gut ab, der Markt reagiert sofort, und die Wahrnehmung beginnt, den Wert schneller zu treiben als die reale Zuverlässigkeit.
Aber letztendlich schaffen Systeme, die um Hype herum aufgebaut sind, Anreize, um für Sichtbarkeit statt für Konsistenz zu optimieren.
Deshalb finde ich Projekte wie OpenLedger ($OPEN ) interessant.
Die Idee geht nicht nur darum, die KI-Infrastruktur zu unterstützen. Es geht darum, Transparenz darüber zu schaffen, wie Modelle trainiert werden, woher die Daten kommen und ob Leistungsbehauptungen über das Marketing hinaus verifiziert werden können.
Wenn Attribution und Herkunft in das Ökosystem selbst eingebettet werden, wird Glaubwürdigkeit messbar statt angenommen.
Wer hat die Daten beigetragen?
Wie hat sich das Modell entwickelt?
Können Ausgaben über die Zeit hinweg zuverlässig bleiben?
Können Ergebnisse unabhängig verifiziert werden?
Diese Fragen könnten wichtiger werden als Benchmark-Screenshots.
KI wird weiterhin intelligenter, aber die Plattformen, die helfen, KI vertrauenswürdig zu machen, könnten langfristig noch wertvoller werden.
#OpenLedger $OPEN #DeAI #DataProvenance
#BinanceSquare
32
14
1.1k

·
--
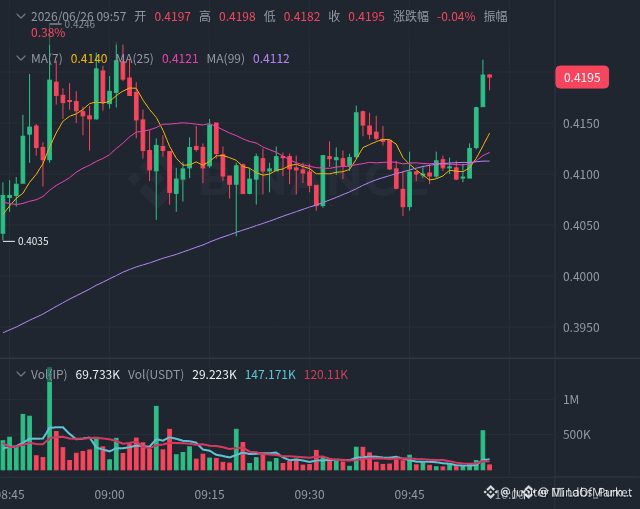
$IP SURGES 25%+ AUF REBRAND ZU DATA FOUNDATION – WAL-AKTIVITÄT ERKANNT 🔥
Dieser Move wird von einem grundlegenden Katalysator angetrieben: der Übergang zum DATA Network als Vertrauensebene für Trainingsdaten von KI, mit der Erfassung von über 1B Datensätzen. Das Volumen ist nach der Ankündigung scharf angestiegen, mit Berichten über einen 25-30% Pump und einer aktiven Breakout-Struktur, die sich formiert.
Die entscheidende Frage ist jetzt, ob es sich um einen einmaligen Liquiditätsgriff handelt oder den Beginn eines nachhaltigen Trends. Angesichts der Wal-Bewegungen und der beobachteten FOMO muss das aktuelle Niveau als Unterstützung für die Fortsetzung gehalten werden.
Keine finanzielle Beratung. Manage immer dein Risiko.
#IP #Rebrand #AI #DataProvenance #Breakout
🔥
190

Artikel
OpenLedger denkt, Intelligenz ohne Geschichte ist einfaches RatenHier ist die professionelle, ansprechende und prägnante Version deines Entwurfs auf Englisch, optimiert mit Überschriften und Emojis, die perfekt für Binance Square geeignet sind:
## 🧠 Intelligenz ohne Geschichte ist einfaches Raten!
Hast du dich jemals gefragt, wo deine KI tatsächlich ihre Antworten herbekommt? 🤔 Während die gesamte Branche besessen davon ist, smartere Modelle und schnellere Inferenz zu entwickeln, übersehen sie das wichtigste Element: **Vertrauen und Herkunft**.
Ein KI-Ausgang mag hochgradig raffiniert erscheinen, aber wenn wir die Quelle dieses Wissens nicht verifizieren können, ist es letztendlich nur ein sehr genaues Rate-Spiel. 🎯
OpenLedger denkt, Intelligenz ohne Geschichte ist einfaches Raten
Hier ist die professionelle, ansprechende und prägnante Version deines Entwurfs auf Englisch, optimiert mit Überschriften und Emojis, die perfekt für Binance Square geeignet sind:
## 🧠 Intelligenz ohne Geschichte ist einfaches Raten!
Hast du dich jemals gefragt, wo deine KI tatsächlich ihre Antworten herbekommt? 🤔 Während die gesamte Branche besessen davon ist, smartere Modelle und schnellere Inferenz zu entwickeln, übersehen sie das wichtigste Element: **Vertrauen und Herkunft**.
Ein KI-Ausgang mag hochgradig raffiniert erscheinen, aber wenn wir die Quelle dieses Wissens nicht verifizieren können, ist es letztendlich nur ein sehr genaues Rate-Spiel. 🎯
37
7
138
·
--
Artikel
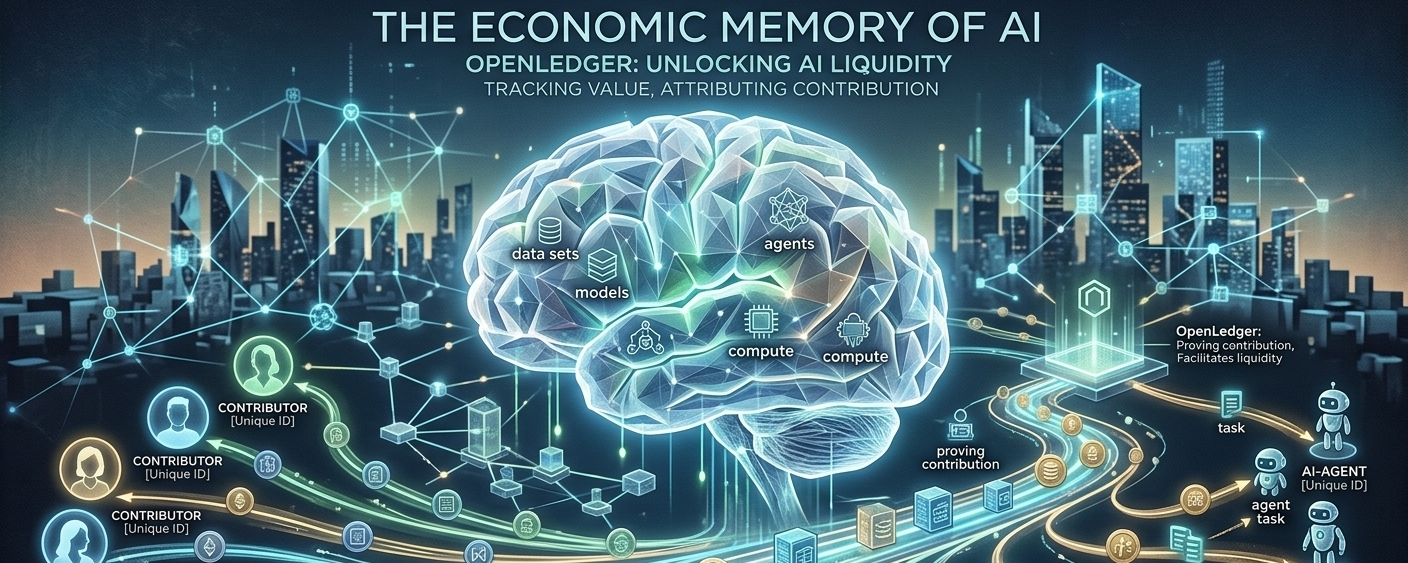
Die wirtschaftliche Erinnerung der KI: Warum das Datenattributionsmodell von OpenLedger wichtig istSchau dich im Web3-Bereich um, und du wirst ein sich wiederholendes, fast ermüdendes Muster bemerken: Krypto behandelt menschliche Verhaltensprobleme gerne als einfache Ingenieuraufgaben.
Ein neues Projekt taucht auf, wirft ein schweres Whitepaper voller architektonischem Fachjargon ab, und plötzlich tun alle so, als könnte sauberen Code die kaputten menschlichen Anreize magisch reparieren. Das hat es nie, und es wird es nie.
Die harte, hässliche Wahrheit über digitale Ökonomien ist viel einfacher, aber viel schwieriger zu lösen: Menschen schaffen ständig Wert, aber Systeme scheitern konstant daran, zu verfolgen, wer tatsächlich die Anerkennung verdient.
Die wirtschaftliche Erinnerung der KI: Warum das Datenattributionsmodell von OpenLedger wichtig ist
Schau dich im Web3-Bereich um, und du wirst ein sich wiederholendes, fast ermüdendes Muster bemerken: Krypto behandelt menschliche Verhaltensprobleme gerne als einfache Ingenieuraufgaben.
Ein neues Projekt taucht auf, wirft ein schweres Whitepaper voller architektonischem Fachjargon ab, und plötzlich tun alle so, als könnte sauberen Code die kaputten menschlichen Anreize magisch reparieren. Das hat es nie, und es wird es nie.
Die harte, hässliche Wahrheit über digitale Ökonomien ist viel einfacher, aber viel schwieriger zu lösen: Menschen schaffen ständig Wert, aber Systeme scheitern konstant daran, zu verfolgen, wer tatsächlich die Anerkennung verdient.
11
82
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
1
#UKFCAWinsCourtOrderToRecover851400Pounds
3,951 Aufrufe
300 Kommentare
2
#ChainlinkLaunchesCCIP2WithEnterpriseVerification
15,444 Aufrufe
584 Kommentare
3
#GoldFallsTo$4144
6,872 Aufrufe
107 Kommentare
4
#QNTFallsOver40%FromMorningHigh
46,626 Aufrufe
985 Kommentare
5
#USDTAdds845900HoldersInPast7Days
4,284 Aufrufe
231 Kommentare
6
#KospiFalls2.7%SamsungSKHynixDropOver5%
11,465 Aufrufe
437 Kommentare
7
#BitgetCEOConfirms$388MStolenInHack
3,701 Aufrufe
38 Kommentare
8
#BTCFallsBelow$83000
21,025 Aufrufe
146 Kommentare
9
#BitgetDetailsSecurityIncidentTimeline
26,699 Aufrufe
596 Kommentare
10
#BitcoinSpotETFs$2.39BWeeklyNetInflow
8,624 Aufrufe
38 Kommentare