هل منح الاحتياطي الفيدرالي المدخلات للذكاء الاصطناعي بيانات أكثر موثوقية؟
يمكن للذكاء الاصطناعي رسم مخطط جميل بسرعة، لكن من أين جاءت الأرقام داخل الرسم غالبًا أهم من أن يكون التفسير مكتوبًا بطريقة أكثر سلاسة.
في مداخلته في مؤتمر FRED بتاريخ 1 أكتوبر، شرح عضو مجلس الاحتياطي الفيدرالي وولر أن FRED أطلق موصلات بيانات تربط أنظمة الذكاء الاصطناعي، ما يجعل الوكلاء أكثر سهولة في استرجاع البيانات الاقتصادية. وفي الوقت نفسه، حذّر من أن الذكاء الاصطناعي قد يخطئ في تحديد المصدر، أو يخفي الافتراضات، أو يحوّل العلاقات المرتبطة إلى علاقات سببية.
هنا طبقة يسهل إغفالها: تجمع FRED البيانات وتوزعها، لكن كثيرًا من المنتجين الأصليين لهذه البيانات ليسوا هم أنفسهم. إن كان الذكاء الاصطناعي قد قرأ بيانات FRED، فهذا لا يعني أن هذه الأرقام كلها من إعداد الاحتياطي الفيدرالي، ولا يعني كذلك أن الاحتياطي الفيدرالي يوافق على استنتاجات التداول التي يقدمها النموذج.
تقييمي هو: كلما صار الوصول إلى البيانات أسهل، كان ينبغي أن تبقى عملية البحث محافظة على ذكر المصدر. قراءة تحليل ماكرو تولّده AI لِـ BTC وETH وSOL على الأقل يجب أن تتيح طرح أسئلة مثل: من هي الجهة الأصلية؟ وما تاريخ انتهاء البيانات؟ وما الوحدة؟ ولماذا يمكن مقارنة خطّين في الرسم معًا.
على سبيل المثال، إذا ارتفع مؤشرين معًا، فهذا لا يكفي إلا لقول إنهما يشتركان في التغيّر. ولكي نقول إن أحدهما دفع سعر العملة، يلزم شرح مسار انتقال التأثير، واستبعاد العوامل المشتركة وعدم التطابق الزمني.
التحسين الذي توفره الموصلات يختص بخطوة العثور على البيانات. أما مدى صمود الاستنتاج، فلا يزال يعتمد على الاستدلال والاختبار اللاحقين.
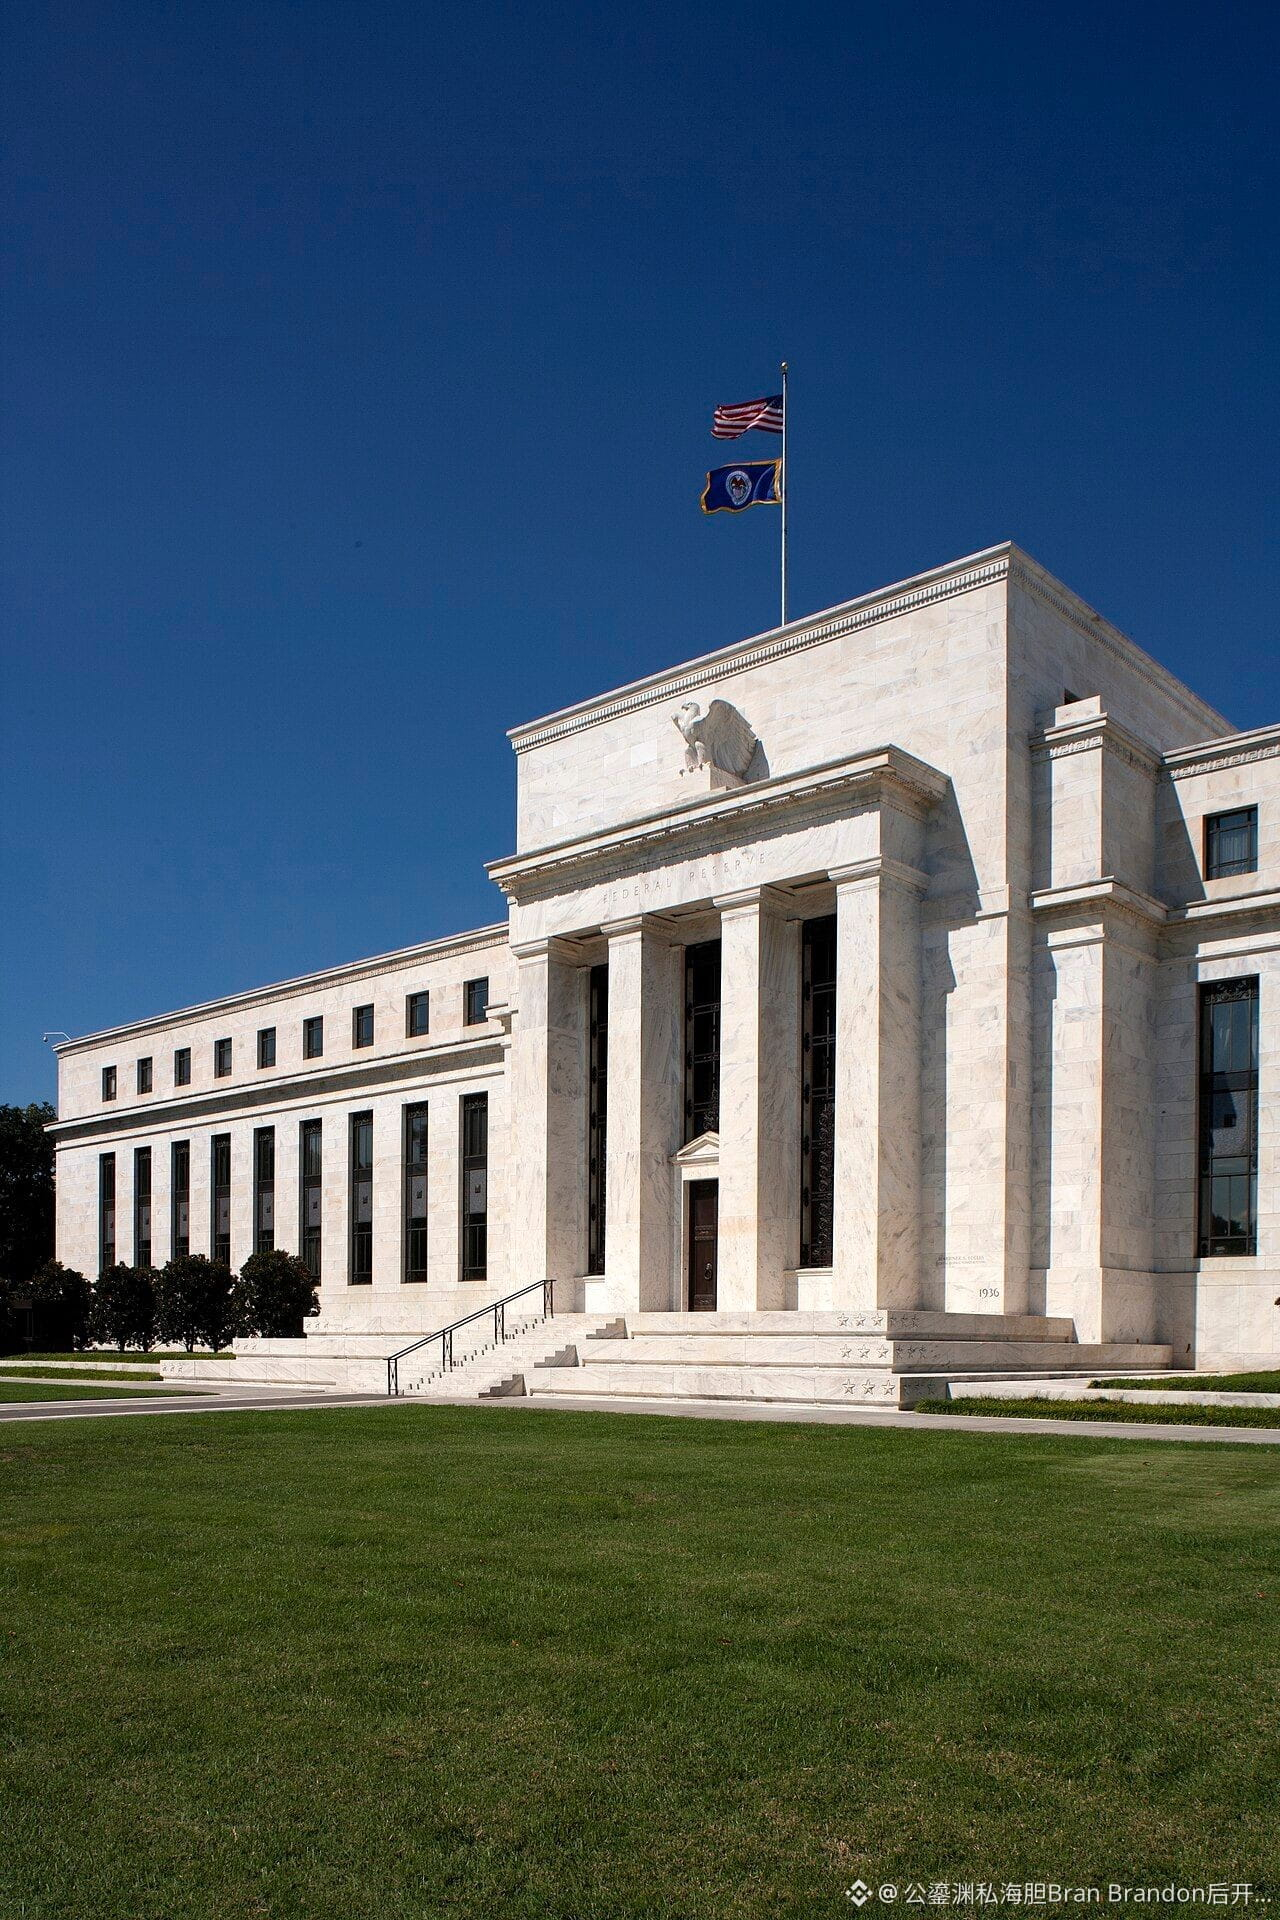
الصورة المرفقة لبرج/مبنى الاحتياطي الفيدرالي (لقطة أرشيفية)، وليست من داخل قاعة المؤتمر.
$BTC $ETH $SOL
اضغط على صورة ملفي الشخصي لعرض الصفقات الفعلية مع أوامر