

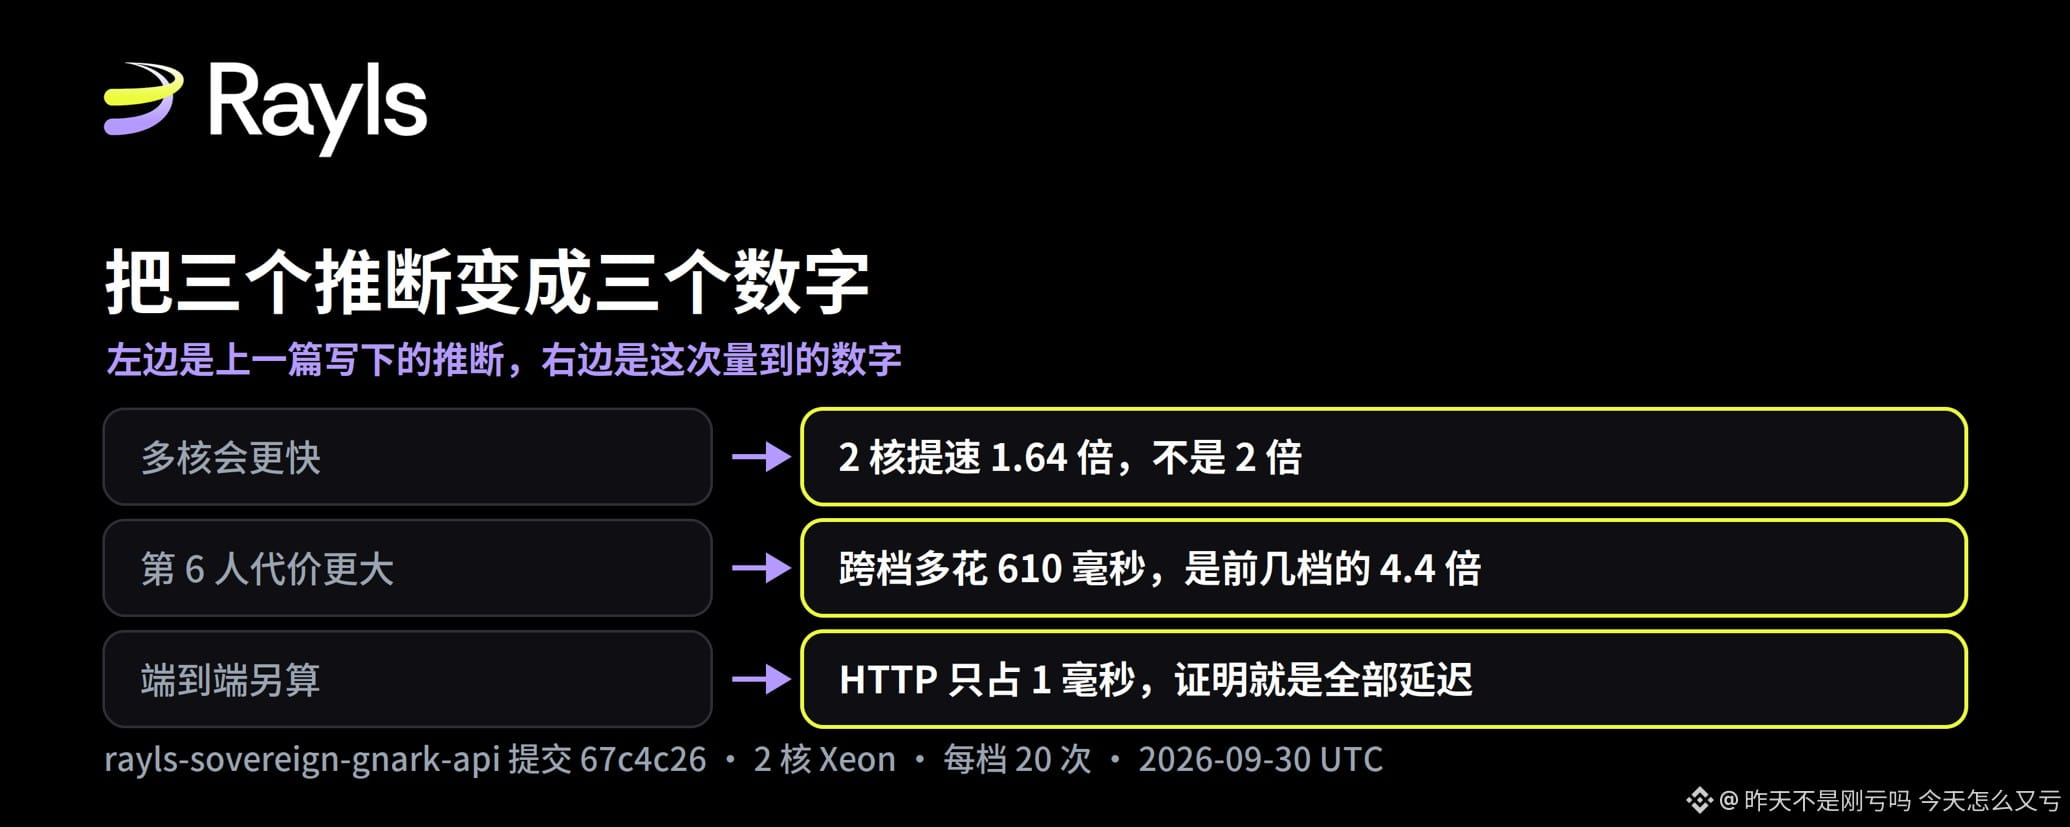
上一篇我把 Rayls 公开的证明代码跑了一遍,测出 6 人匿名集每笔 1.96 秒。但那篇里有三句话是推断不是测量,我自己心里有数。这周把机器换成 2 核,又补了几档数据,就是回去把那三句话补上。
先说清楚这篇和上一篇的关系,免得读者以为是同一篇的重发。上一篇测的是单核环境下 2 人档和 6 人档的证明耗时,这两个数字这次复测了,几乎没变。这篇的全部新内容,是上一篇没能测、只能推的那三件事。
三件事分别是:多核会不会更快、第 6 个参与者为什么特别贵、端到端延迟里证明占多少。下文凡是写「上一篇推断」的,是我自己当时的说法;写「这次测到」的,是这次的结果。
先把测试数据的来源交代清楚
Rayls 的证明服务仓库自带测试数据,但只有 2 人档和 6 人档两组。中间的 3、4、5 档没有,这正是上一篇没法测中间值的原因。自己随便编一组是不行的。电路会当场拒绝,退一步说,就算真凑得出来能通过,读者也没有理由相信它。
所以我写了一个生成器。电路的约束条件写在仓库的 common-checks.go 里,每一项都能反推:发送方的共享密钥是上一轮随机数和私钥的 Poseidon 哈希对 BabyJubJub 子群阶取模,公钥是私钥自哈希取模,随机因子里接收方各取哈希的负值、发送方取接收方之和,交易承诺是金额和随机因子的 Pedersen 承诺。生成器就是把这些规则用仓库自己的原生函数实现一遍。
关键是怎么证明这个生成器没写错。我的办法是:先用它去复现官方那两组数据。把官方数据里所有受约束的字段全部清空,只留种子和其他参与者的公开输入,然后让生成器重新算一遍,再逐字段比对。结果是 6 人档和 2 人档全部字段完全一致。
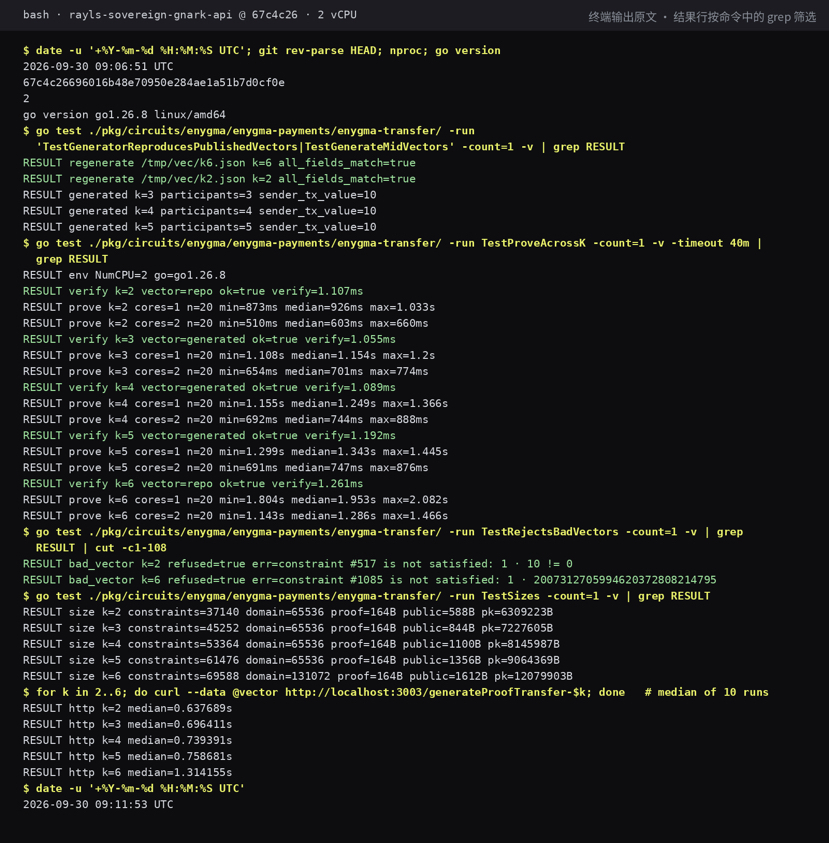
这两组数据是 Rayls 各自独立发布的,私钥、区块号、余额、转账金额都不一样,能同时被复现,说明生成器实现的就是电路要求的那套规则。之后我才用同一套逻辑,按 6 人档的种子生成 3、4、5 档,每一档都先生成证明、再用对应的验证密钥验过一遍,全部通过。
有一点要说明:这三档沿用了 6 人档的转账金额和参与方,所以它们测的是同一笔交易在不同匿名集大小下的成本,不是三笔不同的业务。
第 6 个人贵在哪里
上一篇我看到 6 人档的计算规模是 131,072,而 2 到 5 档都是 65,536,于是推断从 5 档换到 6 档的代价会比前面几档之间大。当时没有中间档数据,只能停在推断。
这次的单核中位数是:2 人档 0.93 秒,3 人档 1.15 秒,4 人档 1.25 秒,5 人档 1.34 秒,6 人档 1.95 秒。前四档之间每档平均多 139 毫秒,而第 5 档到第 6 档一次多了 610 毫秒,是前面的 4.4 倍。
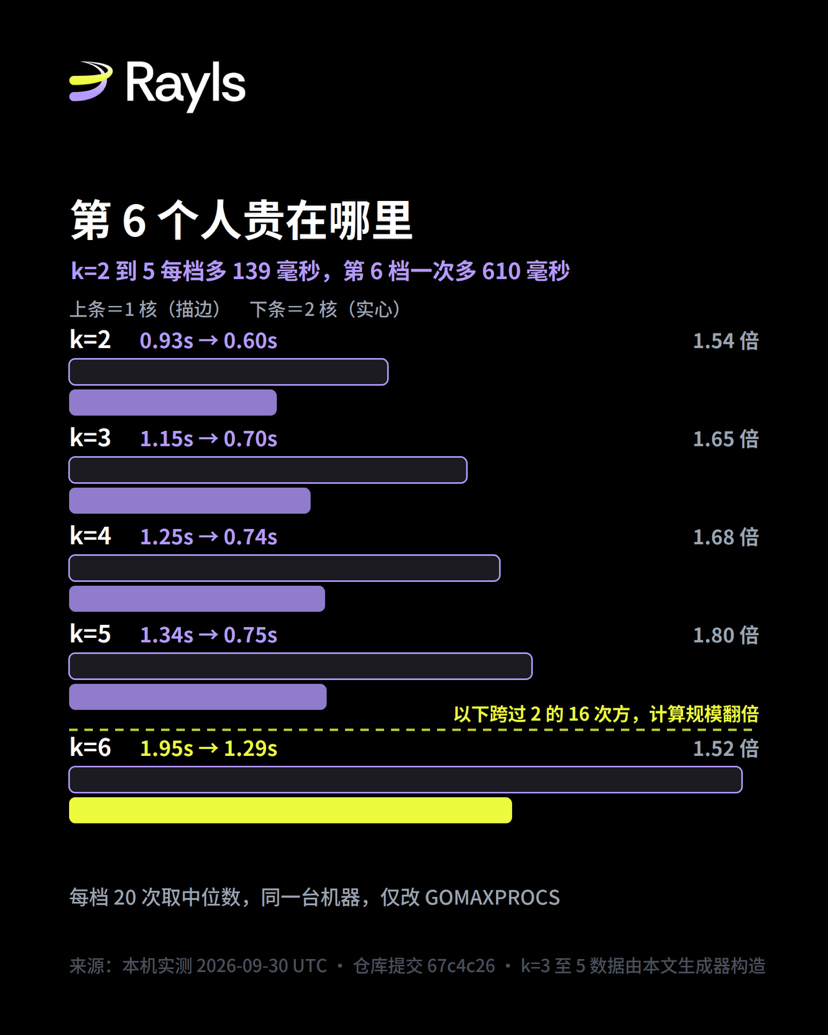
证明密钥的大小是同一个台阶:2 到 5 档每档稳定增加约 918 KB,到 6 档一次增加约 3.0 MB。约束数本身是完全均匀的,每多一个参与者固定加 8,112 条,从 37,140 条涨到 69,588 条,这条线上看不出任何台阶。
所以台阶不在约束数上,而在证明系统给电路分配的计算空间上,它按 2 的幂次取整,6 人档刚好越过 65,536。耗时和密钥大小在同一个位置一起跳,与这个解释一致。我把这写成一致,而不是写成证明。这次测的只有耗时和体积,证明过程内部各阶段的开销我没有单独拆开量过。
对使用者的意义很直接:如果匿名集大小是可配的,5 和 6 之间不是均匀的一小步。要么停在 5,要么接受一次性的跳变,中间没有折中位置。
多核只快 1.64 倍
上一篇我写过一句:机构服务器通常是多核,耗时会低于单核结果。依据是 gnark 的证明代码按 CPU 核数拆分最重的多标量乘法。这句话方向是对的,但当时那台机器只有 1 个核,倍数是多少我没法说。
这次的机器有 2 个核,同一台机器上只改 GOMAXPROCS,其余全部不变。五档的加速比分别是 1.54、1.65、1.68、1.80、1.52 倍,平均 1.64 倍,没有到 2 倍。
为什么不到 2 倍,代码里能看到一部分原因:多标量乘法确实按核数分任务,但证明过程里还有见证求解和若干串行步骤不随核数缩短。我只能说观察到的结果与此一致,没有逐阶段拆解验证。
这个倍数对部署选型是有影响的,方向还和直觉相反。按 6 人档算,一台单核机每秒能出 0.51 个证明,一台双核机每秒 0.78 个。要同样的吞吐量,用双核机反而要花更多的核,但每笔的等待时间少三分之一。 追吞吐就堆单核工作机更省,追单笔延迟就给每个证明多给核,两者不能同时最优。
上一篇只测了证明函数,没走完整服务,所以我当时把 JSON 解析和网络开销列为未测项。
这次把服务真正编译出来跑起来,用 curl 发真实 HTTP 请求。服务自己带分段计时,输出是:请求绑定 0.1 毫秒,参数解析 0.1 毫秒,证明生成 1,300 毫秒,序列化接近 0。curl 测到的端到端中位数是 1.314 秒,服务端内部合计 1.300 秒,差值在 1 到 14 毫秒之间,占整个请求的百分之一左右。
结论就是这么朴素:对这条路径来说,证明生成时间基本等于端到端延迟,HTTP 那一层可以忽略。上一篇把两者分开列为待测,现在可以合并了。
另外测到一件上一篇完全没提的事:冷启动。 每一档的第一个请求要 2.5 到 4.5 秒,之后才稳定下来,因为服务要把 6 到 12 MB 的证明密钥从磁盘读进内存并缓存。对按需扩容的部署来说,这个时间要算进容量规划,而不是只看稳态。
还有一个体积上的补充。证明本身固定 164 字节,五档都一样;随证明一起公开的数据是线性增长的,从 2 人档 588 字节到 6 人档 1,612 字节,每多一名参与者刚好多 256 字节。
按窗口内的平均速率算:CHAPS 日均 210,483 笔,折合每秒 4.87 笔,用单核工作机需要约 9.5 个核;Fedwire 日均 869,187 笔,每秒 10.97 笔,需要约 21.4 个核。英格兰银行记载的 CHAPS 单日笔数纪录是 2018 年 3 月 29 日的 320,034 笔,按同样窗口折合每秒 7.41 笔,约 14.5 个核。
对比一下就知道口径有多重要:CHAPS 按 24 小时平摊只需 4.8 个核,按真实的 12 小时窗口要 9.5 个,整整差一倍。Fedwire 因为窗口本来就接近全天,两种算法只差 9%。
还没算进去的有几项,读者可以自己加:窗口内的日内峰值高于窗口平均,各机构的负载不是均分的,结算链路上还有证明之外的环节,而且证明由发送方各自生成,负载天然是分散的,不集中在一台机器上。
这次确认了什么,还没有的
确认的是:五档的证明耗时和验证耗时、单核与双核的加速比、跨过计算规模边界那一步的代价、端到端与证明生成的差值、冷启动时间、证明和公开数据的体积、生成器能复现官方两组数据、故意改错的数据会被拒绝。这些照着截图里的命令都能重跑。
还没有的:只测了转账电路,存入、提取和 DvP 是另外几类;2 核仍然是很小的样本,更多核的曲线是什么形状我没有数据;只在一台机器上测,换硬件平台结果会变;生成的三档共用同一笔交易的参数;整条结算链路里证明之外的部分没有碰。上一篇被指出的一处措辞我也在这里改正:本机密钥和官方构建产物大小一致,能说明的是编译出的规模相同,不能说明电路逻辑相同。
我的看法
这次最有用的收获不是任何一个具体数字,而是把三句推断换成了三个可复现的结果,其中一句还被自己的测量修正了:多核会更快是对的,但只快 1.64 倍,不是想当然的 2 倍。
给读者一个可验证的判断标准:下次看到任何隐私方案的性能数字,先问三件事,匿名集或参与方规模是多少,跑在几个核上,这个数字是证明本身还是端到端。三个都答得上来的数字才能拿去做容量规划。这三项恰好也是这篇文章自己回答的三项,命令都在截图里。
参考来源:GitHub raylsnetwork/rayls-sovereign-gnark-api,提交 67c4c26(2026 年 9 月 30 日读取并实测);Rayls 官方博客《Privacy has a price: the honest math behind confidential settlement at scale》(2026 年 9 月 19 日);美联储 Fedwire Funds Service 年度统计(2026 年 1 月 26 日更新);英格兰银行 Payment and settlement statistics、《A brief introduction to RTGS and CHAPS》与 2026 年 5 月延长结算时间咨询文件。