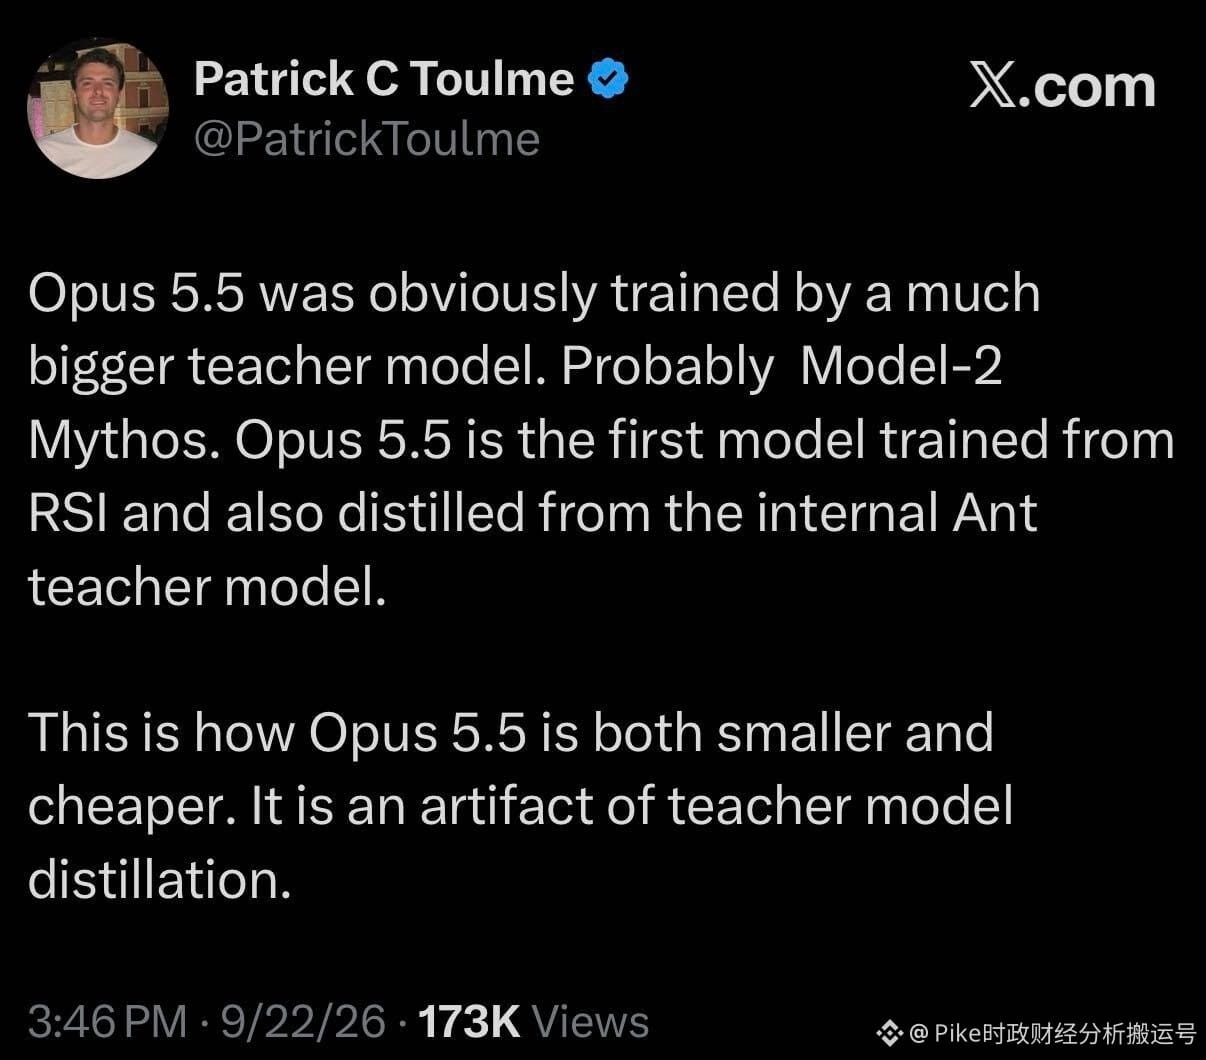
في الآونة الأخيرة، شارك مهندس برمجيات من فريق Google TPU يُدعى Patrick C. Toulme رأيًا مثيرًا للاهتمام. إذ يرى أن Opus 5.5 تمكن من الحفاظ على أداء ممتاز حتى مع كون حجمه أصغر وتكلفته أقل، فمن المحتمل أنه يعود إلى تقنية RSI (التحسين الذاتي التكراري)، إضافة إلى إجراء عملية التقطير عبر نموذج مُعلم داخلي أكبر بكثير. ووفقًا لتوقعاته، قد يكون هذا النموذج المُعلم الغامض هو Model-2 Mythos. وبالطبع، بخصوص مسار التدريب المحدد هذا، لم تقدم Anthropic رسميًا أي تأكيد قاطع حتى الآن.
أما بالنسبة لهذه التكهنات، فأنا شخصيًا أوافق عليها بدرجة كبيرة. إن دمج RSI مع تقنيات التقطير يُشير إلى نهج بحث وتطوير يحمل إمكانات كبيرة: إشراك نماذج تمتلك قدرات في قمّتها في تطوير الجيل التالي من الذكاء الاصطناعي، ثم نقل تلك القدرات القوية التي تم التحقق منها إلى منتجات تكون أكثر ملاءمة لميزانيات المستخدمين. وهذا يعني أن المختبرات الرائدة تمامًا يمكنها أن تتقدم بخطين في آن واحد؛ إذ بينما تواصل كسر الحدود وتوسيع نطاق تدريب النماذج الرائدة، فإنها تقلل في الوقت نفسه بشكل فعّال من كلفة الاستدلال الفعلية التي يتحملها المستخدمون النهائيون. هاتان المهمتان ليستا في تعارض، بل يمكن أن تتقدما جنبًا إلى جنب.
علاوة على ذلك، فإن تحقيق أفضل LLM للأداء دون تراجع في الوقت الذي يخفض فيه تكلفة الاستدلال يُعزز بلا شك منطق التفاؤل القائل بأن اقتصاديات وحدة عمل مختبرات الذكاء الاصطناعي قد تكون أفضل من توقعات السوق. طالما أن الأسعار الأكثر معقولية يمكن أن تنجح في تحفيز توسع تطبيقات الشركات وزيادة كبيرة في عدد استدعاءات الـAgent، وكان حجم هذا النمو كافيًا لتغطية الجزء من انخفاض استهلاك الحوسبة المرتبط بالمهمة الواحدة، فسيضيف ذلك قوة دافعة مستمرة إلى البنية التحتية على مستوى سلسلة الصناعة بأكملها. وبهذا، ستحصل متطلبات السوق، بما في ذلك رقائق الذكاء الاصطناعي، وأجهزة التخزين، ومعدات الربط الشبكي، على دعم أكثر رسوخًا.