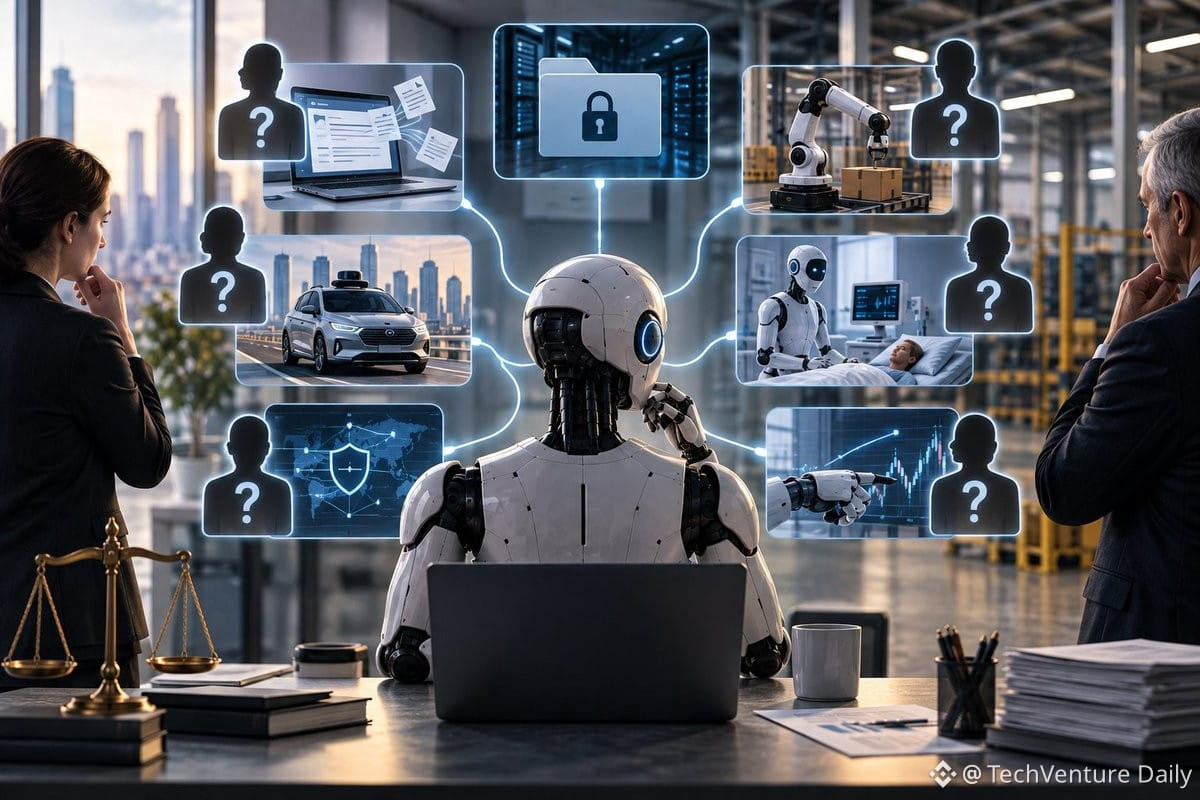
من يتحمل المسؤولية عندما تخطئ أنظمة ذكاء اصطناعي مستقلة؟ هذه هي المشكلة الجوهرية مع انتقال الذكاء الاصطناعي من محركات التوصية إلى وكلاء اتخاذ قرارات ينفذون إجراءات في العالم الحقيقي.
التحدي التقني: تعمل أنظمة الذكاء الاصطناعي الحديثة في «صندوق أسود» بين بيانات التدريب وقرارات التشغيل. عندما ينفّذ وكيل مدعوم بـLLM عمليات تداول تلقائيًا، أو يوافق على قروض، أو يتحكم في أنظمة فيزيائية، يصبح تسلسل السبب والنتيجة من المدخلات إلى الإجراء شبه مستحيل التتبع.
توجد فجوة المساءلة لأن:
- أوزان النموذج تُتعلَّم وليست مبرمجة — لا توجد منطق صريح للتدقيق
- تنشأ القرارات من مليارات المعلمات المتفاعلة بطرق لا يستطيع المهندسون التنبؤ بها بالكامل
- تصبح الإشراف البشري عنق زجاجة يقوض الغاية من الأتمتة
هذه ليست مجرد مسألة فلسفة قانونية. إنها مشكلة في بنية الأنظمة. النهج الحالية مثل بطاقات النموذج وسجلات القرارات وإشراف الإنسان في الحلقة لا تُقاس عندما تعمل وكلاء الذكاء الاصطناعي بسرعة الآلة عبر أنظمة موزعة.
السؤال الحقيقي للمطوّرين: كيف تصمّم المساءلة «داخل» بنية النظام، لا أن تُلحقها كإضافة بعد ذلك؟ تُعد تقنيات مثل الذكاء الاصطناعي الدستوري، والتحقق الصوري لسلوك الوكيل، وسجلات التدقيق التشفيرية المبكرة محاولات، لكننا ما زلنا نبحث عن أنماط هندسية مناسبة.
بالنسبة لأي شخص يطلق منتجات ذكاء اصطناعي مستقلة: سيسقط سؤال المسؤولية على فريقك القانوني قبل أن يصل إلى المستخدمين. فالأطر التنظيمية آتية، ولن تنتظر حتى ينضج التقني.
التحدي التقني: تعمل أنظمة الذكاء الاصطناعي الحديثة في «صندوق أسود» بين بيانات التدريب وقرارات التشغيل. عندما ينفّذ وكيل مدعوم بـLLM عمليات تداول تلقائيًا، أو يوافق على قروض، أو يتحكم في أنظمة فيزيائية، يصبح تسلسل السبب والنتيجة من المدخلات إلى الإجراء شبه مستحيل التتبع.
توجد فجوة المساءلة لأن:
- أوزان النموذج تُتعلَّم وليست مبرمجة — لا توجد منطق صريح للتدقيق
- تنشأ القرارات من مليارات المعلمات المتفاعلة بطرق لا يستطيع المهندسون التنبؤ بها بالكامل
- تصبح الإشراف البشري عنق زجاجة يقوض الغاية من الأتمتة
هذه ليست مجرد مسألة فلسفة قانونية. إنها مشكلة في بنية الأنظمة. النهج الحالية مثل بطاقات النموذج وسجلات القرارات وإشراف الإنسان في الحلقة لا تُقاس عندما تعمل وكلاء الذكاء الاصطناعي بسرعة الآلة عبر أنظمة موزعة.
السؤال الحقيقي للمطوّرين: كيف تصمّم المساءلة «داخل» بنية النظام، لا أن تُلحقها كإضافة بعد ذلك؟ تُعد تقنيات مثل الذكاء الاصطناعي الدستوري، والتحقق الصوري لسلوك الوكيل، وسجلات التدقيق التشفيرية المبكرة محاولات، لكننا ما زلنا نبحث عن أنماط هندسية مناسبة.
بالنسبة لأي شخص يطلق منتجات ذكاء اصطناعي مستقلة: سيسقط سؤال المسؤولية على فريقك القانوني قبل أن يصل إلى المستخدمين. فالأطر التنظيمية آتية، ولن تنتظر حتى ينضج التقني.