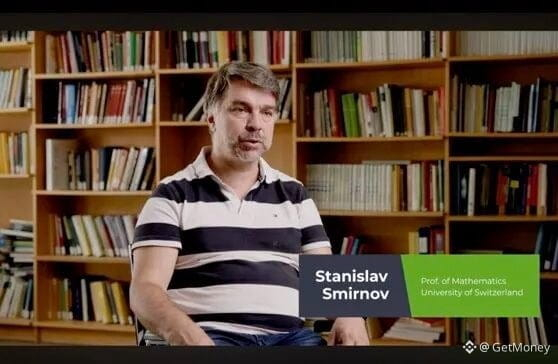
📰 اصدر الفائزون بالمركز الخامس والعشرين بجائزة فيلدز بيانًا مشتركًا، حيث يضعون بشكل صريح التناقض بين شركات الذكاء الاصطناعي وبين الأوساط الرياضية على الطاولة. ويرون أن شركات مثل OpenAI وAnthropic تعتبر التغلب على المسائل الشهيرة مجرد اختبار للنماذج، مما يضغط على مفاهيم الفهم العميق والأفكار الجديدة التي تضعها الرياضيات في المقام الأول.
🔥 الشرارة كانت معادلات N-S. تقول OpenAI إن نموذجًا داخليًا غير مُعلن حل—في 88 ساعة—مسألة وجودية الاستمرارية والنعومة (وجودية الحل وسلامة السلاسة). لكن في اليوم السابق، نشر عالم الرياضيات ترستين بَكمَستر، وباحثة من فريق Anthropic، ليفنت ألبِركْه، نتائج مرتبطة بذلك بالفعل.
👀 والأكثر حساسية أن بَكمَستر سبق أن أدخل مسودات غير منشورة واستدلالات في أداة أكواد تابعة لـ OpenAI، ثم شك في أن النموذج «يطلّع» عليها. تنفي OpenAI هذا الادعاء، لكنها تقر بعدم قدرتها على استبعاد مشاركة بيانات المستخدمين في التدريب بشكل غير مباشر بالكامل. وحتى الآن، لم تُقرّ الأوساط الرياضية رسميًا بإثبات OpenAI، كما أن OpenAI لم تتقدم بطلب لنيل جائزة قدرها 1,000,000 دولار أمريكي.
💡 بصراحة، الجدل لا يتعلق بما إذا كان بإمكان الذكاء الاصطناعي فعل الرياضيات أم لا، بل يتعلق بمن طرح الفكرة أولًا، ومن أين جاءت بيانات التدريب، وهل أحد يفهم حقًا الأدلة الطويلة التي يقدمها الجهاز. تشبيه فائز بجائزة فيلدز، سميلنوف، مباشر جدًا: إن الحفّار الآلي أسرع فعلًا، لكنه قد يتسبب أيضًا في تدمير القطع الأثرية الثمينة الموجودة في موقع التنقيب.
🤔 إذا استخدم الذكاء الاصطناعي مسودات لم يُنشرها الباحثون، ثم قدم في النهاية الدليل أولًا، برأيك تُحسب النتيجة للنموذج أم للشركة أم للمؤلف الأصلي؟
#人工智能 #OpenAI #数学研究 #AI伦理
🔥 الشرارة كانت معادلات N-S. تقول OpenAI إن نموذجًا داخليًا غير مُعلن حل—في 88 ساعة—مسألة وجودية الاستمرارية والنعومة (وجودية الحل وسلامة السلاسة). لكن في اليوم السابق، نشر عالم الرياضيات ترستين بَكمَستر، وباحثة من فريق Anthropic، ليفنت ألبِركْه، نتائج مرتبطة بذلك بالفعل.
👀 والأكثر حساسية أن بَكمَستر سبق أن أدخل مسودات غير منشورة واستدلالات في أداة أكواد تابعة لـ OpenAI، ثم شك في أن النموذج «يطلّع» عليها. تنفي OpenAI هذا الادعاء، لكنها تقر بعدم قدرتها على استبعاد مشاركة بيانات المستخدمين في التدريب بشكل غير مباشر بالكامل. وحتى الآن، لم تُقرّ الأوساط الرياضية رسميًا بإثبات OpenAI، كما أن OpenAI لم تتقدم بطلب لنيل جائزة قدرها 1,000,000 دولار أمريكي.
💡 بصراحة، الجدل لا يتعلق بما إذا كان بإمكان الذكاء الاصطناعي فعل الرياضيات أم لا، بل يتعلق بمن طرح الفكرة أولًا، ومن أين جاءت بيانات التدريب، وهل أحد يفهم حقًا الأدلة الطويلة التي يقدمها الجهاز. تشبيه فائز بجائزة فيلدز، سميلنوف، مباشر جدًا: إن الحفّار الآلي أسرع فعلًا، لكنه قد يتسبب أيضًا في تدمير القطع الأثرية الثمينة الموجودة في موقع التنقيب.
🤔 إذا استخدم الذكاء الاصطناعي مسودات لم يُنشرها الباحثون، ثم قدم في النهاية الدليل أولًا، برأيك تُحسب النتيجة للنموذج أم للشركة أم للمؤلف الأصلي؟
#人工智能 #OpenAI #数学研究 #AI伦理