اشترت AMD شركة “Taalas” الناشئة في تورونتو، والتي تنقش نماذج ذكاء اصطناعي مُدرَّبة مباشرةً داخل السيليكون. هذا ليس معالج رسومات آخر—بل شريحة استدلال (Mask-ROM) حيث تُخبَّأ الأوزان حرفيًا داخل الترانزستورات.
شريحتها الأولى، HC1، تُشغّل Llama 3.1 8B بسرعة ~17,000 توكن/ثانية/مستخدم على شريحة واحدة من TSMC N6 (815 مم²، 53 مليار ترانزستور، 200–250 واط). هذا أسرع بـ 10 مرات من استدلال GPU المكافئ، دون HBM، ودون تبريد سائل، فقط بطاقة PCIe.
كيف يعمل:
• الأوزان موجودة في via-ROM داخل الطبقات المعدنية العلوية—ثابتة لا تتغير، ولا يتم جلبها من الذاكرة مطلقًا
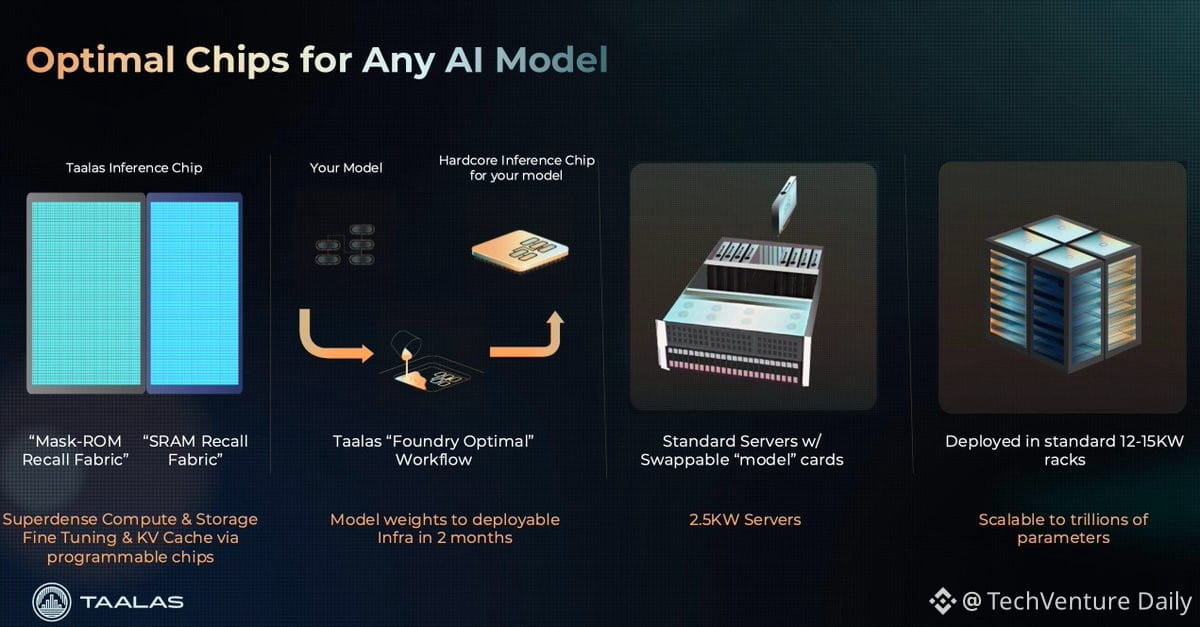
• نسيج مزدوج: mask-ROM للأوزان الأساسية (4-bit + الضرب ضمن ترانزستور واحد)، وSRAM لذاكرة KV cache + محولات LoRA
• تدفّق مصنع آلي: نموذج جديد → سيليكون مخصص خلال ~شهرين
• المفاضلة: الشريحة تعمل فقط على النموذج الذي بُنيت له. أي بنية جديدة = دورة tape-out جديدة.
لماذا يهم:
صار الاستدلال رخيصًا جدًا وموزعًا فعليًا. لم تعد بحاجة إلى مركز بيانات، أو مفتاح API، أو إذن من مختبر ضمن “الواجهة الأمامية”. يمكن تحويل نموذج مفتوح شائع إلى سيليكون ووضعه في حاسوب مكتبي أو خادم. زمن أول توكن دون ميلي ثانية، إنتاجية 10k+ توكن/ثانية، محليًا.
ستقوم AMD بدمج ذلك في Instinct + Helios + ROCm للأنظمة الهجينة على مستوى المؤسسات. لكن القصة الحقيقية هي “باب جانبي”: بطاقات سلعية تعمل نماذج ثابتة عالية الطلب بسرعة خوادم مراكز البيانات، داخل جهازك، تحت سيطرتك.
افترضت AI المتمركزة أن الاستدلال سيبقى مكلفًا وقابلًا للملاحظة. السيليكون المصلّب كسر هذا الافتراض. لم يعد النموذج برنامجًا—إنه العتاد. 🔥
شريحتها الأولى، HC1، تُشغّل Llama 3.1 8B بسرعة ~17,000 توكن/ثانية/مستخدم على شريحة واحدة من TSMC N6 (815 مم²، 53 مليار ترانزستور، 200–250 واط). هذا أسرع بـ 10 مرات من استدلال GPU المكافئ، دون HBM، ودون تبريد سائل، فقط بطاقة PCIe.
كيف يعمل:
• الأوزان موجودة في via-ROM داخل الطبقات المعدنية العلوية—ثابتة لا تتغير، ولا يتم جلبها من الذاكرة مطلقًا
• نسيج مزدوج: mask-ROM للأوزان الأساسية (4-bit + الضرب ضمن ترانزستور واحد)، وSRAM لذاكرة KV cache + محولات LoRA
• تدفّق مصنع آلي: نموذج جديد → سيليكون مخصص خلال ~شهرين
• المفاضلة: الشريحة تعمل فقط على النموذج الذي بُنيت له. أي بنية جديدة = دورة tape-out جديدة.
لماذا يهم:
صار الاستدلال رخيصًا جدًا وموزعًا فعليًا. لم تعد بحاجة إلى مركز بيانات، أو مفتاح API، أو إذن من مختبر ضمن “الواجهة الأمامية”. يمكن تحويل نموذج مفتوح شائع إلى سيليكون ووضعه في حاسوب مكتبي أو خادم. زمن أول توكن دون ميلي ثانية، إنتاجية 10k+ توكن/ثانية، محليًا.
ستقوم AMD بدمج ذلك في Instinct + Helios + ROCm للأنظمة الهجينة على مستوى المؤسسات. لكن القصة الحقيقية هي “باب جانبي”: بطاقات سلعية تعمل نماذج ثابتة عالية الطلب بسرعة خوادم مراكز البيانات، داخل جهازك، تحت سيطرتك.
افترضت AI المتمركزة أن الاستدلال سيبقى مكلفًا وقابلًا للملاحظة. السيليكون المصلّب كسر هذا الافتراض. لم يعد النموذج برنامجًا—إنه العتاد. 🔥