

يتضمن رؤى من شبكة AIOZ و-YOM
أخيرًا، كشفت سنة 2026 عن المشكلة الرئيسية في صناعة الذكاء الاصطناعي: لا يتعلق الأمر بالأجهزة. فالطلب على الحوسبة لتدريب نماذج الذكاء الاصطناعي والاستدلال بها ينمو بوتيرة أسرع من قدرة الصناعة على بناء مراكز بيانات.
تتعطل قوائم انتظار وحدات معالجة الرسوم (GPU) لدى كبار مزودي الخدمات السحابية لأشهر، وتظل أسعار تأجير الحوسبة مرتفعة للغاية بالنسبة للفرق الصغيرة والمطورين المستقلين.
مأزق البنية التحتية للذكاء الاصطناعي
عمليًا، تتركز سوق البنية التحتية للذكاء الاصطناعي بالكامل تقريبًا في أيدي عدد قليل من اللاعبين: AWS وGoogle Cloud وMicrosoft Azure، وصنّاع الشرائح مثل Nvidia.
وهذا يخلق سيناريو اختناق كلاسيكي: يصبح الوصول إلى أجهزة الكمبيوتر امتيازاً، ويُجبر ذلك الشركات الناشئة على تخصيص ميزانية للصراع على مكان في قائمة تأجير GPU إضافةً إلى كل شيء آخر.
تُجلب المركزية مخاطر منهجية معها: نقطة فشل واحدة، الاعتماد على سياسة مقدّم محدد، وقيود إقليمية أو قيود على الوصول.
بالنسبة لصناعة تقدم نفسها كأساس لاقتصاد المستقبل، تبدو هذه النوعية من الاعتماد تناقضاً مع مبادئها الخاصة بالانفتاح واللامركزية.
الخطوة التالية في تطور الشبكات
لقد سلكت الصناعة هذا الطريق من قبل. فقد كانت خوادم مشاركة الملفات المركزية ذات يوم تمهّد الطريق لشبكات نظير إلى نظير (P2P)، ثم لاحقاً إلى شبكات CDN موزعة، تعلمت أن تُسلم المحتوى بشكل أسرع وأرخص تماماً من خلال استخدام العديد من العقد المنتشرة بدلاً من مركز بيانات واحد.
يُطبق المبدأ نفسه الآن على الحوسبة: تقترح DePIN تجميع قوة الحوسبة من آلاف الأجهزة المستقلة حول العالم.
منطق DePIN بسيط وأنيق بطريقته الخاصة. لدى ملايين الناس موارد حوسبة خاملة يتم تركها دون استخدام: مساحة قرص حرة، وعرض نطاق غير مستخدم، ودورات GPU/CPU خاملة. تجمع شبكة DePIN هذه الموارد المتناثرة في بنية تحتية واحدة وتكافئ المشاركين بالرموز مقابل مقدار التخزين أو حركة المرور التي يتم تسليمها أو الحوسبة التي يقدمونها.
بدلاً من بناء مركز بيانات واسترداد تكاليف رأس المال على المعدات والكهرباء، يعتمد بروتوكول DePIN على عتاد موجود بالفعل، موزع حول العالم.
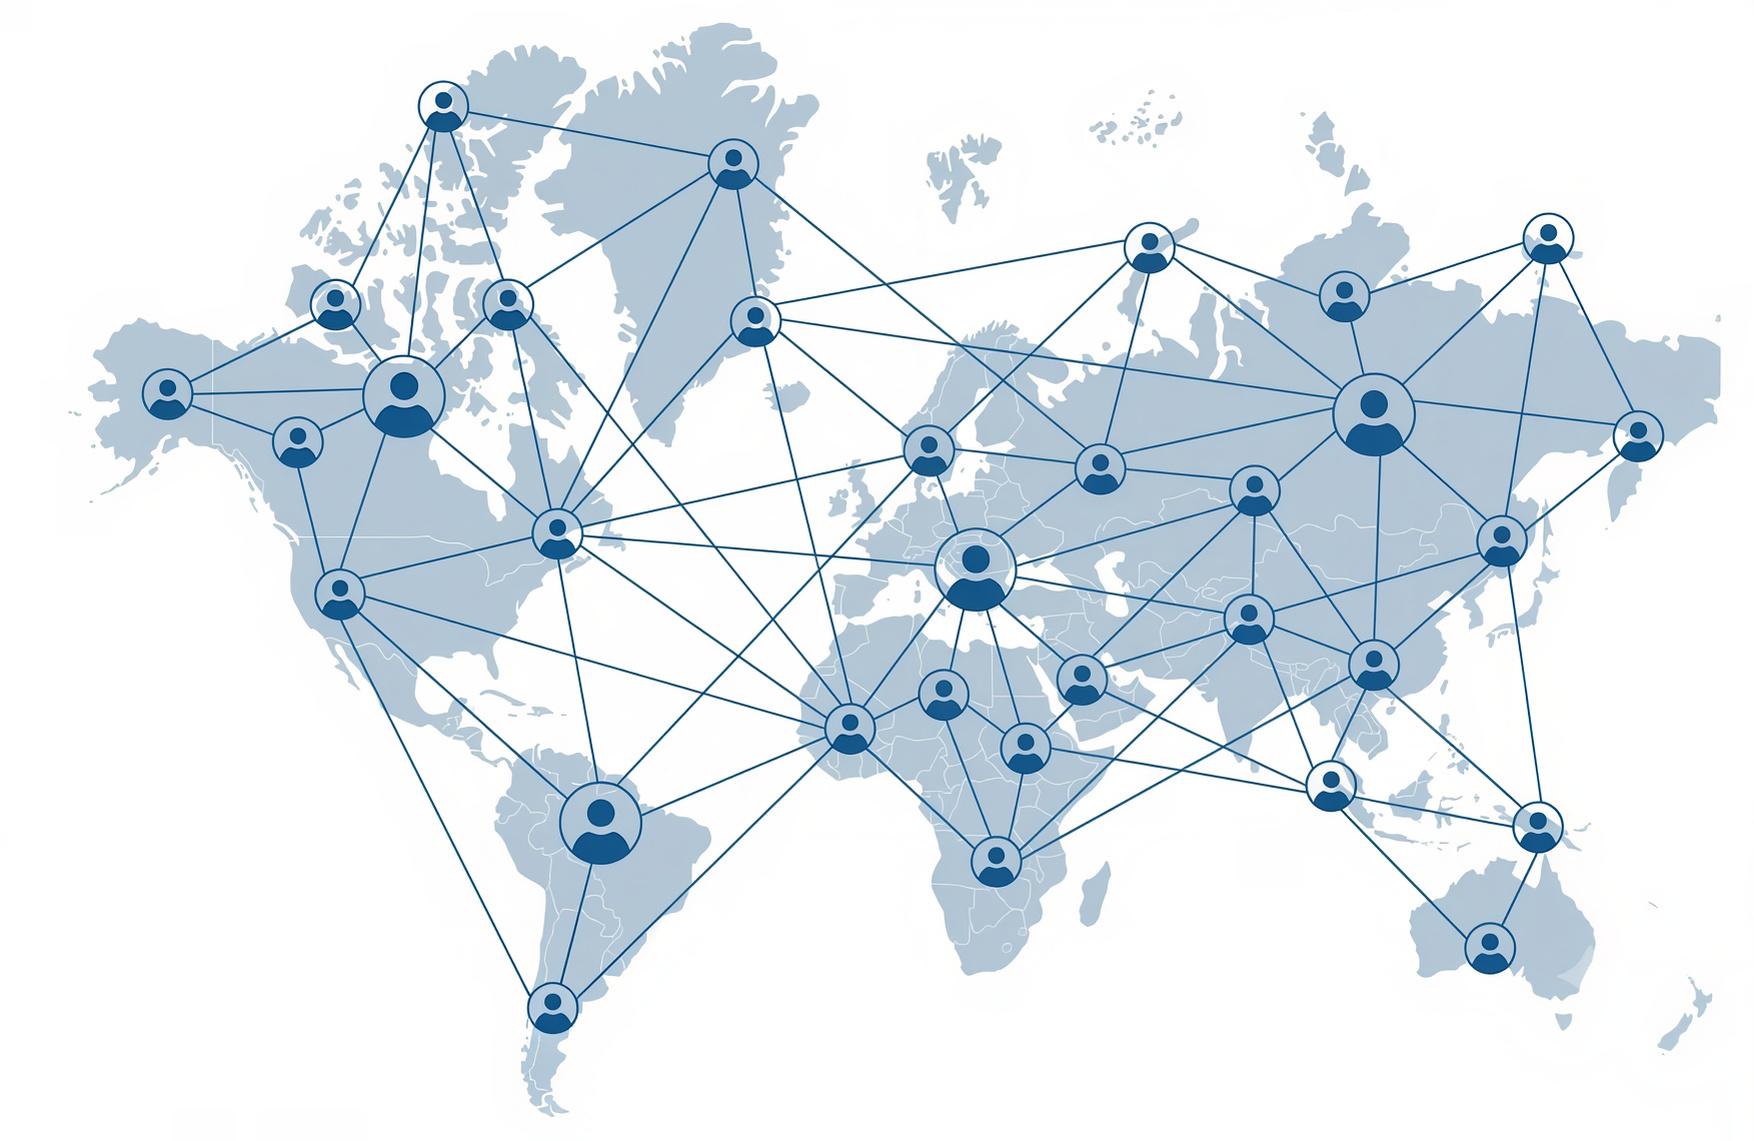
يقلل ذلك عائق الدخول أمام مشغلي العقد، وبالنسبة لمستهلكي الحوسبة في النهاية قد يخفض تكلفة الوصول أيضاً بفضل المنافسة بين مزودي طاقة مستقلين كثيرين داخل شبكة واحدة.
السؤال الرئيسي لأي شبكة DePIN هو ما إذا كان يمكن تحويلها إلى اقتصاد يعمل: هل توجد عقد كافية؟ وهل الطلب على سعتها مستقر؟ وهل تستطيع البنية التحتية التعامل مع ضغط سيناريوهات استخدام حقيقية، لا سيناريوهات اختبارية؟
عندما تكون المللي ثانية مهمة
تعزز اتجاهات أخرى لعام 2026 من منطق DePIN—التحول من روبوتات الدردشة إلى وكلاء ذكاء اصطناعي مستقلين يعملون في الوقت الفعلي: يرون ويسمعون ويستجيبون بالصوت، ويتفاعلون مع تيارات الفيديو. في مثل هذه السيناريوهات، لم يعد زمن الاستجابة معلمة ثانوية، بل يصبح سمة حاسمة في المنتج.
الفرق بين وكيل لطيف عند التحدث إليه، وآخر تكون توقفاته مزعجة، يُقاس بمئات المللي ثانية.
تعمل المعمارية الكلاسيكية ضد المستخدم هنا. ينتقل الطلب من الجهاز إلى مركز بيانات، غالباً عبر قارة أخرى، ثم تتم معالجته ويعود. تضيف كل جولة من هذا النوع تأخيراً، ويتراكم هذا خلال بث الصوت والفيديو. ولا يمكن لمراكز البيانات المركزية أن تقع فعلياً بجوار كل مستخدم على كوكب الأرض في الوقت نفسه.
تتعامل شبكة موزعة من العقد مع هذه المهمة بأفضل شكل. بدل مركز واحد قوي لكنه بعيد، توجد نقاط تواجد عديدة، موزعة جغرافياً حيث يوجد المستخدمون مباشرة. تتم معالجة الطلب بواسطة أقرب عقدة متاحة، لا بواسطة أبعد خادم مجاني.
عند التقاطع الدقيق بين نقص حوسبة الذكاء الاصطناعي المركزية والحاجة المتزايدة إلى بنية تحتية للذكاء الاصطناعي منخفض التأخير على أطراف الشبكة، تحصل بروتوكولات DePIN على فرصة لاحتلال مكانة (niche) لا تستطيع عمالقة السحابة فائقة السعة سدّها من تلقاء أنفسهم بشكل بنيوي.
AIOZ: من التخزين إلى شبكة حوسبة الذكاء الاصطناعي
تُعد شبكة AIOZ واحدة من مشاريع DePIN القليلة التي سلكت الطريق من حالة استخدام ضيقة إلى بنية تحتية كاملة متعددة الطبقات.
بدأت الشبكة بمهمة التسليم والتخزين اللامركزية لمحتوى الوسائط (StreamP2P وتخزين متوافق مع S3)، ثم توسعت إلى اقتصاد حوسبة ذكاء اصطناعي كامل—سوق لقوة الحوسبة ونماذج الذكاء الاصطناعي المبنية على شبكة موزعة من العقد.
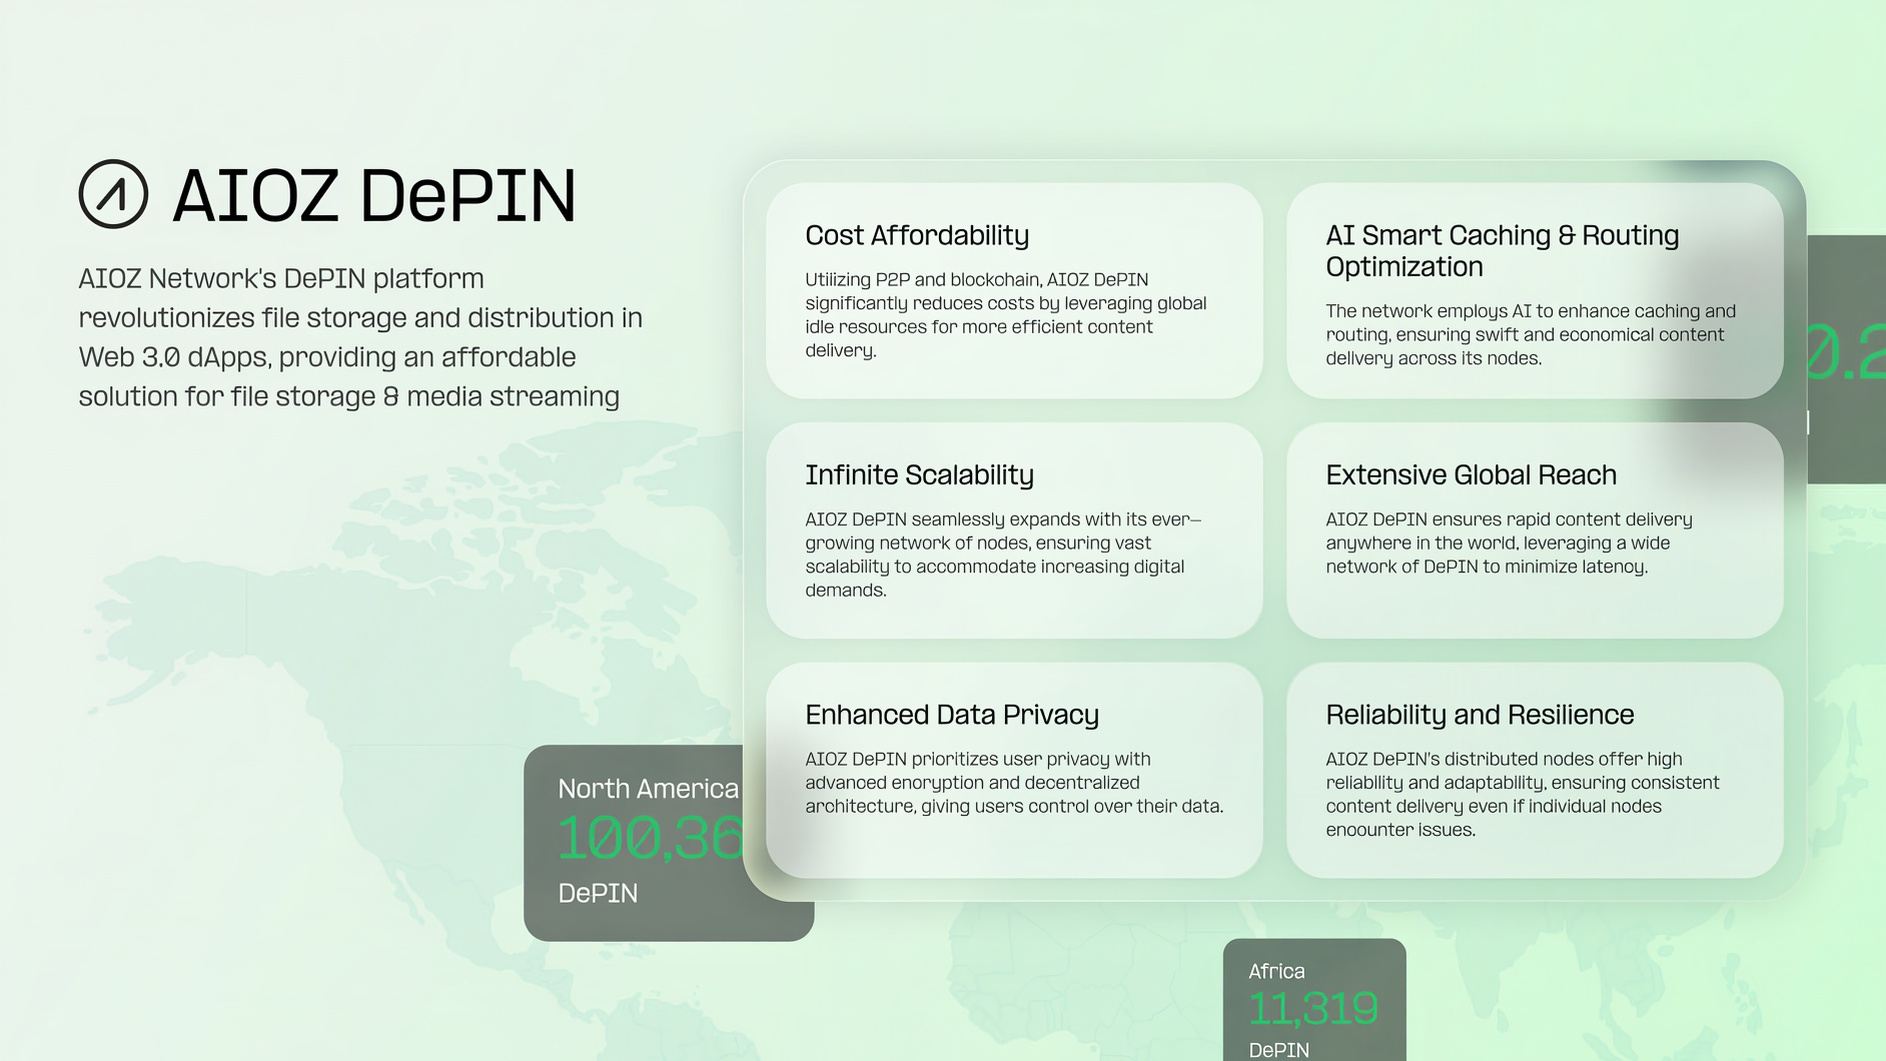
أساس الشبكة هو عقد DePIN الخاصة بها، التي يشغّلها آلاف المشاركين حول العالم، باستخدام الموارد الخاملة لأجهزة الكمبيوتر العادية: الأقراص الصلبة للتخزين، وعرض النطاق لتسليم البيانات، وGPU/CPU لتحويل وسائط (media transcoding) وحوسبة الذكاء الاصطناعي.
وفقاً لبيانات الشبكة، تم تسجيل أكثر من 327,000 عقدة DePIN حالياً، ويتجاوز إجمالي حجم البيانات المُسلّمة 26,000 تيرابايت. يتم مكافأة المشاركين برموز $AIOZ بنسبة إلى مساهمتهم الفعلية.
بحلول عام 2026، كانت شبكة AIOZ قد بنت عدة خطوط منتجات مترابطة فوق نفس قاعدة عقد DePIN:
اقتصاد حوسبة الذكاء الاصطناعي: سوق لقوة الحوسبة ونماذج الذكاء الاصطناعي المتاحة للتشغيل عبر شبكة موزعة من العقد؛
StreamP2P: شبكة توصيل محتوى لا مركزية (CDN)، بديل لمقدمي البث المركزيين؛
التخزين: تخزين بيانات موزع متوافق مع S3؛
Pin: خدمة تثبيت (IPFS pinning) تضمن بقاء البيانات متاحة بشكل دائم في التخزين اللامركزي.
برهان عملي على أن توجه AIOZ في الذكاء الاصطناعي هو بنية تحتية تعمل بالفعل هو نشر نموذج Qwen2.5-Omni على منصة AIOZ AI.
إنه نموذج متعدد الوسائط (multimodal) بعمارة Thinker-Talker، قادر على معالجة النصوص والصور والصوت والفيديو في الوقت الفعلي، والرد عبر النصوص معاً والكلام المُصنَّع (synthesized speech).
تتطلب نماذج مثل هذه موارد حوسبة كبيرة، وكونها متاحة للتشغيل عبر شبكة AIOZ الموزعة مثالٌ ملموس على كيفية سدّ بنية DePIN للفجوة بين المطورين المستقلين والنماذج الثقيلة في الذكاء الاصطناعي.
بالنسبة للشبكة، يضع هذا AIOZ ضمن السردية الأوسع المتعلقة بمركزية البنية التحتية للذكاء الاصطناعي: يحصل المستخدمون والمطورون على الحوسبة والنماذج عبر شبكة موزعة من العقد.
رؤى من شبكة AIOZ
تحدثنا مع فريق AIOZ حول أحد أكثر الاختبارات الواقعية صعوبة لبنيتهم التحتية لـ DePIN. وهذه ما قالوه لنا حول كيفية تكييف نموذج كهذا مع شبكة لامركزية.
س: ما أكبر تحديات الهندسة في تكييف Qwen2.5 Omni للعمل بكفاءة على بنية DePIN اللامركزية لدى AIOZ، وما الدروس التي تعلمتها فرقكم؟
كانت أكبر تحدياتنا تحويل مقياس وتنوع DePIN الخاص بـ AIOZ إلى بيئة موثوقة للاستدلال متعدد الوسائط في الوقت الفعلي.
يتطلب Qwen2.5 Omni أكثر من مجرد قوة GPU خام. فزمن الاستجابة يعتمد على معالجة الوسائط، وتحميل النموذج، والاصطفاف (queueing)، والاستدلال، والإخراج المُبث. يوفر AIOZ DePIN مجموعة واسعة من الحوسبة الموزعة والتخزين وعرض النطاق، لكن تختلف هذه الموارد من حيث خصائص العتاد، والموقع، وجودة الشبكة، والتوفر الحالي. لذلك كانت مهمة الهندسة الأساسية هي مطابقة كل طلب مع الموارد المناسبة مع الحفاظ على زمن استجابة يمكن توقعه.
وهذا يتطلب جدولة تراعي العتاد عبر مسابح حوسبة مؤهلة، وتوجيهًا ذكيًا بناءً على الموقع وظروف الشبكة، وتخزين نماذج مُهيأ (warm model caching) لتقليل زمن بدء التشغيل، ومراعاة “انتماء الجلسة” للحفاظ على سياق متعدد الوسائط أثناء البث. كما أن البنية الموزعة لـ AIOZ DePIN تمنح مرونة في توجيه جلسات مختلفة عبر الآلات المتاحة، وتوسيع السعة مع نمو الطلب، وتقليل الاعتماد على مركز بيانات واحد.
كانت الدروس الأساسية أن قوة AIOZ DePIN لا تكمن فقط في كمية الحوسبة المتاحة. بل تكمن في القدرة على تنسيق الحوسبة والتخزين وعرض النطاق كطبقة بنية تحتية واحدة. وللذكاء الاصطناعي في الوقت الفعلي، يجب أن تعطي هذه التنسيقات الأولوية لجاهزية النموذج، وقربه المكاني، والاتصالات المستقرة، وزمن الاستجابة الطرفي (tail latency) بدلاً من الإنتاجية وحدها.
في النهاية، الهدف هو جعل تعقيد DePIN الأساسي غير مرئي للمستخدم. يجب أن يختبر المستخدم خدمة واحدة متعددة الوسائط سريعة الاستجابة، مدعومة بسعة AIOZ DePIN الموزعة، وبالتخصيص الذكي للموارد، وبالقدرة على توسيع الأحمال عبر الشبكة.
كما يشير فريق AIOZ، فإن تشغيل نموذج مثل Qwen2.5-Omni يتطلب تنسيق الحوسبة والتخزين وعرض النطاق كطبقة واحدة، حيث يكون زمن التأخير (latency) أكثر أهمية من الإنتاجية.
رؤى من YOM
كما طرحنا سؤالاً على فريق YOM، شبكة GPU اللامركزية على الحافة (edge) المعروفة جيداً ببث ألعاب AAA مباشرة إلى المتصفح. ومع توجيه خريطة YOM نحو ذكاء اصطناعي في الوقت الفعلي، أردنا معرفة كيف ستشارك أحمال الألعاب والذكاء الاصطناعي فعلياً نفس البنية التحتية.
س: مع تنافس الألعاب والذكاء الاصطناعي على نفس عقد GPU مستقبلاً، كيف سيعطي YOM الأولوية للأحمال عبر الشبكة؟
تفترض البنية أن الأحمال تتنافس على العقد. وبنيتنا مصممة كي لا يحدث ذلك. إن نواتنا من فئة Vulkan (قيد براءة اختراع) تقسم وحدة معالجة الرسوميات (GPU) للمستهلك إلى ما يصل إلى 7 فتحات/مساحات معزولة، لكل منها ميزانية VRAM خاصة بها، بحيث لا تطأ جلسات بعضها بعضاً.
ثم يقوم مُجدول HyperOrch AI بتوزيع كل جلسة وفقاً لما تحتاجه فعلياً: جلسة ألعاب سحابية تحتاج إلى عقدة ضمن نحو 50 كم لتحقيق زمن استجابة أقل من 10 مللي ثانية، بينما تهتم العديد من مهام استدلال الذكاء الاصطناعي أكثر بالإنتاجية من المسافة. التوزيع يكون بحسب المتطلبات، لا بحسب طابور الانتظار.
كما أن الإتاحة في YOM تتبع الطلب أيضاً بدلاً من وضع سقف عليه. تراخيص العقد تُفتح على دفعات عندما تتجاوز نسبة الاستخدام عتبات محددة، لذلك يؤدي الطلب المستمر إلى رفع عائد المشغّل وجذب عقد جديدة إلى المناطق التي تتوفر فيها الأعمال.
عندما لا تكون التغطية المجتمعية قد لحقت بعد، توفر وحدات GPU عبر شركات الاتصالات (telco) وسعة الانفجار (burst capacity) لدى مقدمي الخدمات السحابية العملاقة سِنداً للشبكة. لا أحد يُحرم من الموارد، ويجني البروتوكول رسماً عن كل جلسة في كلتا الحالتين. فكلما زادت فئات الأحمال تصبح الشبكة أقوى، لا أكثر ازدحاماً.
س: هل يعمل الذكاء الاصطناعي في الوقت الفعلي على نفس البنية التحتية الخاصة بالألعاب، أم يحتاج طبقة تقنية منفصلة؟
نفس البنية التحتية، وفق التصميم. بدأنا بالألعاب لأنها أصعب حمل وقت حقيقي موجود: زمن استجابة وسيطي أقل من 10 مللي ثانية، جودة AAA، وآلاف الجلسات المتزامنة ذات الحالة (stateful) . يمكن لشبكة تبث Unreal Engine 5 إلى متصفح أن تخدم أي حمل بنفس قيود زمن الاستجابة وحالة الجلسة، والذكاء الاصطناعي في الوقت الفعلي ينتمي بالضبط إلى هذه الفئة.
تنتقل اللبنات الأساسية حرفاً بحرف. نفس المجدول الذي يضع جلسة لعبة يضع جلسة استدلال. نفس تقسيم Vulkan لذاكرة VRAM يمنح حمل ذكاء اصطناعي فتحة معزولة على GPU للمستهلك. نفس طبقة التسوية تدفع للمشغّل، ويأخذ البروتوكول رسمه بغض النظر عمّا يتم تشغيله. ما يتغير هو زمن التشغيل داخل الحاوية: خادم نموذج بدل بناء لعبة. هذه طبقة رقيقة فوق الباقي، وليست شبكة ثانية.
أثبتت الأبحاث المنشورة لدى DeepSeek حول DualPipe وDeepEP أن “حصن” الربط البيني (interconnect moat) الخاص بعمالقة السحابة يمكن كسره بخوارزميات لا بالعتاد. نواتنا Vulkan هي المكافئ الخاص بسوق GPU للمستهلك: فهي تتيح لأجهزة GPU للمستهلك تنفيذ أحمال كانت تتطلب في السابق عزلًا بمستوى مؤسسي. الألعاب تُظهر الفيزياء. والذكاء الاصطناعي يرث الشبكة.
ما يظهر من هنا هو أن YOM لا يقوم فقط بلصق الذكاء الاصطناعي على شبكة الألعاب لديه. فالبنية نفسها المبنية لأشد حالات زمن الاستجابة سوءاً في الألعاب هي ما يجعلها جاهزة أيضاً للذكاء الاصطناعي في الوقت الفعلي.
ملاحظة من الرئيس التنفيذي لشركة Cicada Maxim Moris
أغلقنا الحلقة عبر سؤال الرئيس التنفيذي والمؤسس المشارك لشركة Cicada، Maxim Moris، لماذا يولي صانعُ السوق اهتماماً بـ DePIN، وما الذي يتم تسعيره فعلياً عند دعم المشاريع في مراحلها المبكرة.
س: ما الذي يضع DePIN على رادار Cicada في الصورة الأكبر؟
حقيقتان لا سردية. سوق الـGPU انقسم: ساعات H100 الفورية هبطت من 8–10 دولارات في 2024 إلى أقل من 3.50 دولارات، بينما ارتفعت الطاقة المحجوزة لمدة سنة بنحو 40% من أدنى مستوى في أواخر 2025. رخيص عند الطلب، لكنه مكلف عندما تحتاجه مضموناً—وهذه الفجوة هي المكان الذي تحصل فيه السعة الموزعة على فرصتها.
أخيراً لدى DePIN إيرادات: نحو 150 مليون دولار على السلسلة (on-chain) في يناير 2026. صغير، لكنه يعني أن الرموز تحمل تدفقاً نقدياً يمكنك نمذجته بدل قصة يمكنك ضخّها. نحن نتبع الطلب على السيولة، والسيولة تتبع الإيرادات.
س: هل سيتجاوز DePIN ضجيج الذكاء الاصطناعي، أم سيتلاشى معه؟
الآن كل الاهتمام موجّه إلى الذكاء الاصطناعي والأتمتة والوكلاء. لكن هذا الضجيج قد يخبو بسرعة، لأن معظم هذه الاتجاهات لا تحتاج ببساطة إلى بلوكشين. معظم المشاريع اليوم تقوم بالتداول مع وكلاء ذكاء اصطناعي.
س: ما الذي يختلف في صُنع السوق (market-making) لرموز DePIN؟
ما يختلف في DePIN هو جانب الإمداد. يتم دفع أجرة مشغلي العقد بالرمز (token)، ووفقاً لتصميم النظام، يبيعون كل يوم. إنها تدفّق دائم عليك أن تبني حوله دفتر الأوامر (orderbook).
تشير إجابات Maxim إلى الشيء نفسه من مقعد مختلف: إن DePIN مثير للاهتمام لأن هناك الآن إيرادات وبيعاً متوقعاً من جانب الشراء (sell-side) للنموذج.
الخلاصة
من غير المرجح أن تستبدل بنية DePIN مراكز بيانات فائقة السعة (hyperscale) بين ليلة وضحاها. فمواصلة تدريب أكبر النماذج ما تزال تتطلب تجمعات حوسبة مركزة.
لكن بالنسبة لمدى واسع من المهام، فإن نموذجًا تتوفر فيه الحوسبة والتخزين عبر آلاف المشاركين المستقلين في الشبكة يبدو بديلاً عملياً عن نقطة الفشل الواحدة التي تمثلها السحابة المركزية.
تُظهر مشاريع مثل AIOZ Network أن انتقال DePIN من الفكرة إلى الإنتاج جارٍ بالفعل: بنية تحتية لتخزين البيانات وتسليمها، بُنيت على مدى سنوات، أصبحت أساساً لمرحلة حوسبة الذكاء الاصطناعي الموزعة.
وهذا مثال تدعم فيه سردية اللامركزية بالأرقام الخاصة بالشبكة وبعمليات تكامل تعمل فعلاً.
اقرأ المزيد: DePIN: سدّ فجوات السحابة