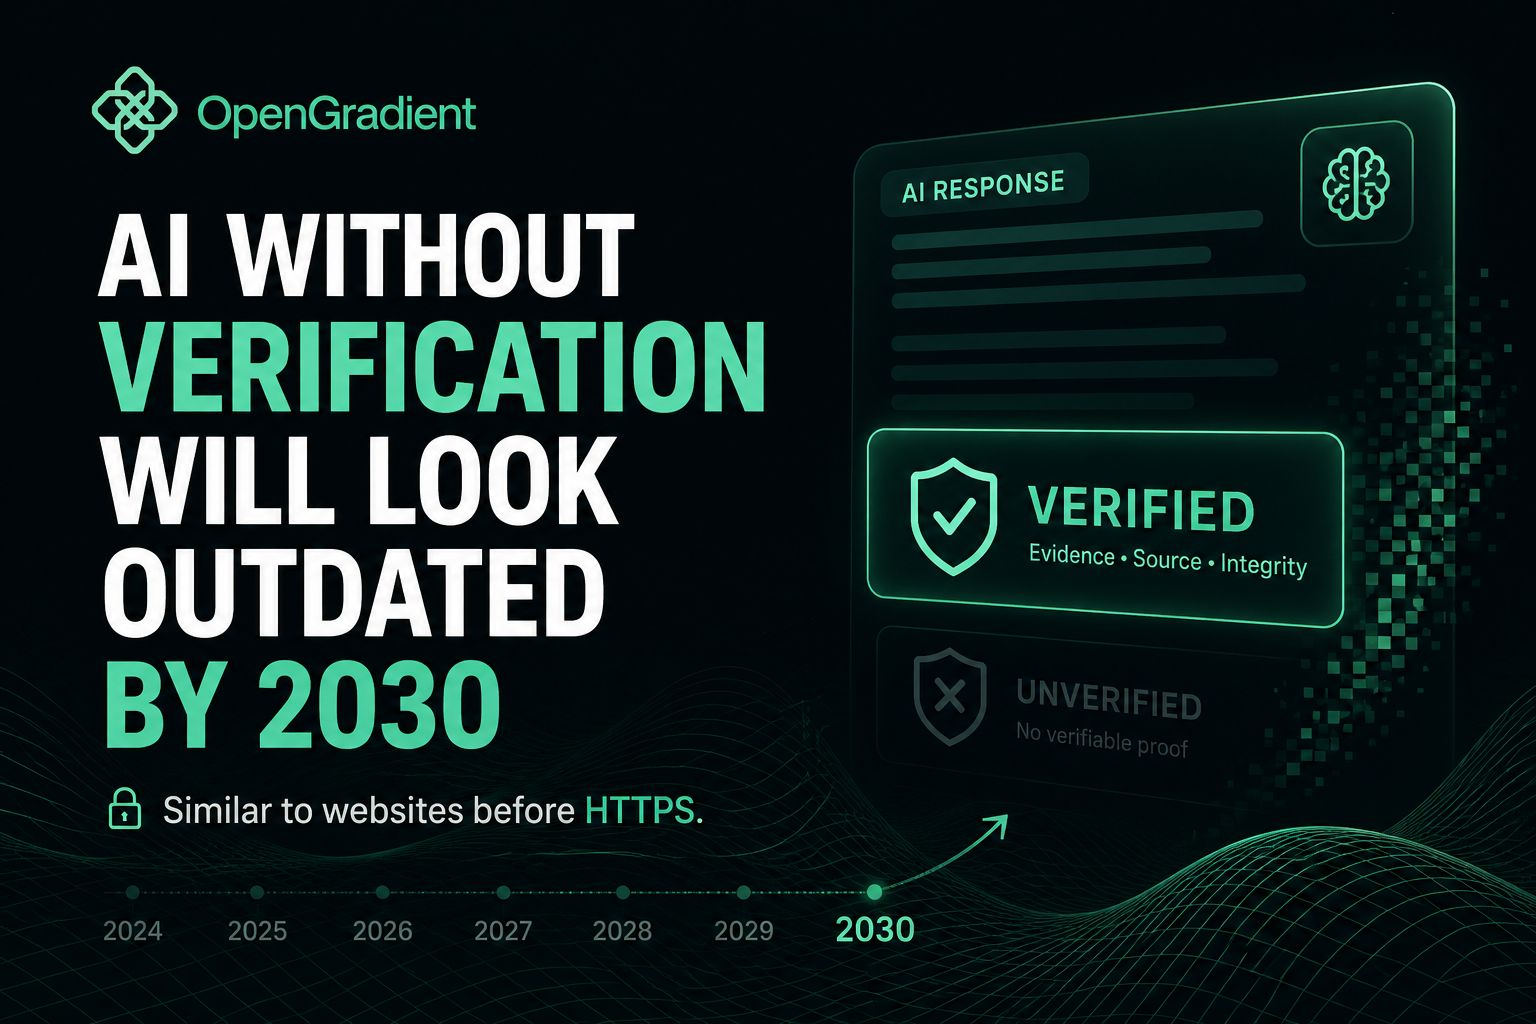

opAI بدون تحقق بدأ يشعر كثيرًا مثل مواقع الويب قبل HTTPS.
ليس معطّلًا. ليس غير قابل للاستخدام. فقط ينقصه شيء ما توقف الناس في النهاية عن قبوله.
كنت أبحث في OpenGradient مؤخرًا، ورقم واحد ظل يجذب انتباهي إلى الخلف: 156,461 استدلالًا خاصًا تمت معالجته في شهر واحد. لم تكن الكمية نفسها هي الجزء المثير للاهتمام. بل كان السؤال الذي تلاها.
كم عدد تلك المخرجات التي يمكن لأي شخص أن يتحقق منها بشكل مستقل؟
ظللت أفكر في كيفية تفاعلنا حاليًا مع أغلب أنظمة الذكاء الاصطناعي. نحصل على إجابة، وربما درجة ثقة، وربما مصدر إذا كنا محظوظين. ثم نقرر ما إذا كنا سنثق بها. ما يزال جزء كبير من هذا الثقة ينبع من السمعة بدلًا من الدليل.
هذا يبدو مؤقتًا.
كلما استخدمت أنظمة تعرض أدلة حول ما حدث أثناء الاستدلال، صار النموذج القديم غريبًا أكثر. ليس لأن كل نتيجة أصبحت فجأة مثالية. بعض الاستجابات كانت لا تزال متوسطة. وبعضها كان على الأرجح خاطئًا.
الفرق كان في إمكانية الرؤية.
قبل بضع سنوات، كان موقع ويب يطلب معلومات شخصية بدون HTTPS يبدو طبيعيًا. ثم صار علامة تحذير. درّبت المتصفحات الجميع على ملاحظة غياب التحقق.
أظن أن الذكاء الاصطناعي سيسلك مسارًا مشابهًا.
ليس هذا العام. ربما ليس العام القادم.
لكن بحلول 2030، قد يبدو الحصول على نتيجة مهمة مولّدة بالذكاء الاصطناعي دون أي طريقة للتحقق من مصدرها، أو كيفية إنتاجها، أو ما إذا كانت قد تم تعديلها، قديمًا بشكل غريب.
الجزء الذي ما زلت غير متأكد منه هو ما إذا كان المستخدمون سيفرضون هذا التحول أولًا، أم ما إذا وصلت البنية التحتية إلى هناك قبل أن يبدأ أي شخص في المطالبة بذلك.
@OpenGradient $OPG #OPG
بحلول 2030، ما الذي سَيهم أكثر عند تقييم استجابة من الذكاء الاصطناعي؟
ليس معطّلًا. ليس غير قابل للاستخدام. فقط ينقصه شيء ما توقف الناس في النهاية عن قبوله.
كنت أبحث في OpenGradient مؤخرًا، ورقم واحد ظل يجذب انتباهي إلى الخلف: 156,461 استدلالًا خاصًا تمت معالجته في شهر واحد. لم تكن الكمية نفسها هي الجزء المثير للاهتمام. بل كان السؤال الذي تلاها.
كم عدد تلك المخرجات التي يمكن لأي شخص أن يتحقق منها بشكل مستقل؟
ظللت أفكر في كيفية تفاعلنا حاليًا مع أغلب أنظمة الذكاء الاصطناعي. نحصل على إجابة، وربما درجة ثقة، وربما مصدر إذا كنا محظوظين. ثم نقرر ما إذا كنا سنثق بها. ما يزال جزء كبير من هذا الثقة ينبع من السمعة بدلًا من الدليل.
هذا يبدو مؤقتًا.
كلما استخدمت أنظمة تعرض أدلة حول ما حدث أثناء الاستدلال، صار النموذج القديم غريبًا أكثر. ليس لأن كل نتيجة أصبحت فجأة مثالية. بعض الاستجابات كانت لا تزال متوسطة. وبعضها كان على الأرجح خاطئًا.
الفرق كان في إمكانية الرؤية.
قبل بضع سنوات، كان موقع ويب يطلب معلومات شخصية بدون HTTPS يبدو طبيعيًا. ثم صار علامة تحذير. درّبت المتصفحات الجميع على ملاحظة غياب التحقق.
أظن أن الذكاء الاصطناعي سيسلك مسارًا مشابهًا.
ليس هذا العام. ربما ليس العام القادم.
لكن بحلول 2030، قد يبدو الحصول على نتيجة مهمة مولّدة بالذكاء الاصطناعي دون أي طريقة للتحقق من مصدرها، أو كيفية إنتاجها، أو ما إذا كانت قد تم تعديلها، قديمًا بشكل غريب.
الجزء الذي ما زلت غير متأكد منه هو ما إذا كان المستخدمون سيفرضون هذا التحول أولًا، أم ما إذا وصلت البنية التحتية إلى هناك قبل أن يبدأ أي شخص في المطالبة بذلك.
@OpenGradient $OPG #OPG
بحلول 2030، ما الذي سَيهم أكثر عند تقييم استجابة من الذكاء الاصطناعي؟
🟢 Smarter models
80%
⚪ Privacy and ownership
7%
⚪ Speed and convenience
7%
⚪ Verifiable proof of output
6%
15 الأصوات • تمّ إغلاق التصويت