@OpenGradient
كنت أعتقد أن السؤال الأكثر أهمية في الذكاء الاصطناعي هو ما إذا كانت النماذج تزداد ذكاءً.
في الآونة الأخيرة، بدأت أفكر في سؤال مختلف.
ماذا يحدث عندما يصبح الذكاء الاصطناعي شيئًا نعتمد عليه كل يوم؟
ليس كروبوت محادثة. وليس كعرض توضيحي.
ولكن كجزء من البحث، والتداول، وتطوير البرمجيات، وإنشاء المحتوى، وأنظمة اتخاذ القرار.
كلما اندمج الذكاء الاصطناعي في سير العمل الواقعي، كلما شعرت أن النقاش لا يتعلق بالقدرة فقط.
يبدأ الأمر وكأنه سؤال ثقة.
قليل منا يفكر في كيفية إنتاج ردود الذكاء الاصطناعي. نرى إجابة، نحدد ما إذا كانت تبدو مفيدة، ونتابع.
هذا يعمل حتى تؤثر النتيجة على شيء مهم.
في تلك النقطة، يصبح الفجوة الغريبة مرئية.
يمكننا تقييم النتيجة، لكن غالبًا لا يمكننا التحقق بشكل مستقل من كيفية إنتاجها، ما هي العملية التي أنتجتها، أو ما إذا كان هناك أي تغيير على طول الطريق.
أثناء استكشاف OpenGradient، أصبحت تلك الفجوة الجزء الأكثر إثارة للاهتمام في المشروع بالنسبة لي.#opg
بدلاً من التركيز فقط على بناء أو استضافة نماذج الذكاء الاصطناعي، يركز المشروع على تنفيذ الذكاء الاصطناعي القابل للتحقق.
الفكرة بسيطة: تجاوز "ثق في المزود" وجعل التحقق جزءًا من البنية التحتية نفسها.
لست مقتنعًا بأن كل تطبيق للذكاء الاصطناعي سيحتاج إلى هذا المستوى من الشفافية.
الراحة قوية، ومعظم المستخدمين يختارون بشكل طبيعي الخيار الأسهل المتاح.
لكن التاريخ يظهر أن الأنظمة المهمة غالبًا ما تتطور في نفس الاتجاه. أولاً تأتي الوظائف. لاحقًا تأتي المساءلة.
لهذا السبب أعتقد أن النقاش الأكبر ليس حول الذكاء الاصطناعي مقابل العملات المشفرة، أو المركزية مقابل اللامركزية، أو حتى أي نموذج هو الأكثر ذكاءً.
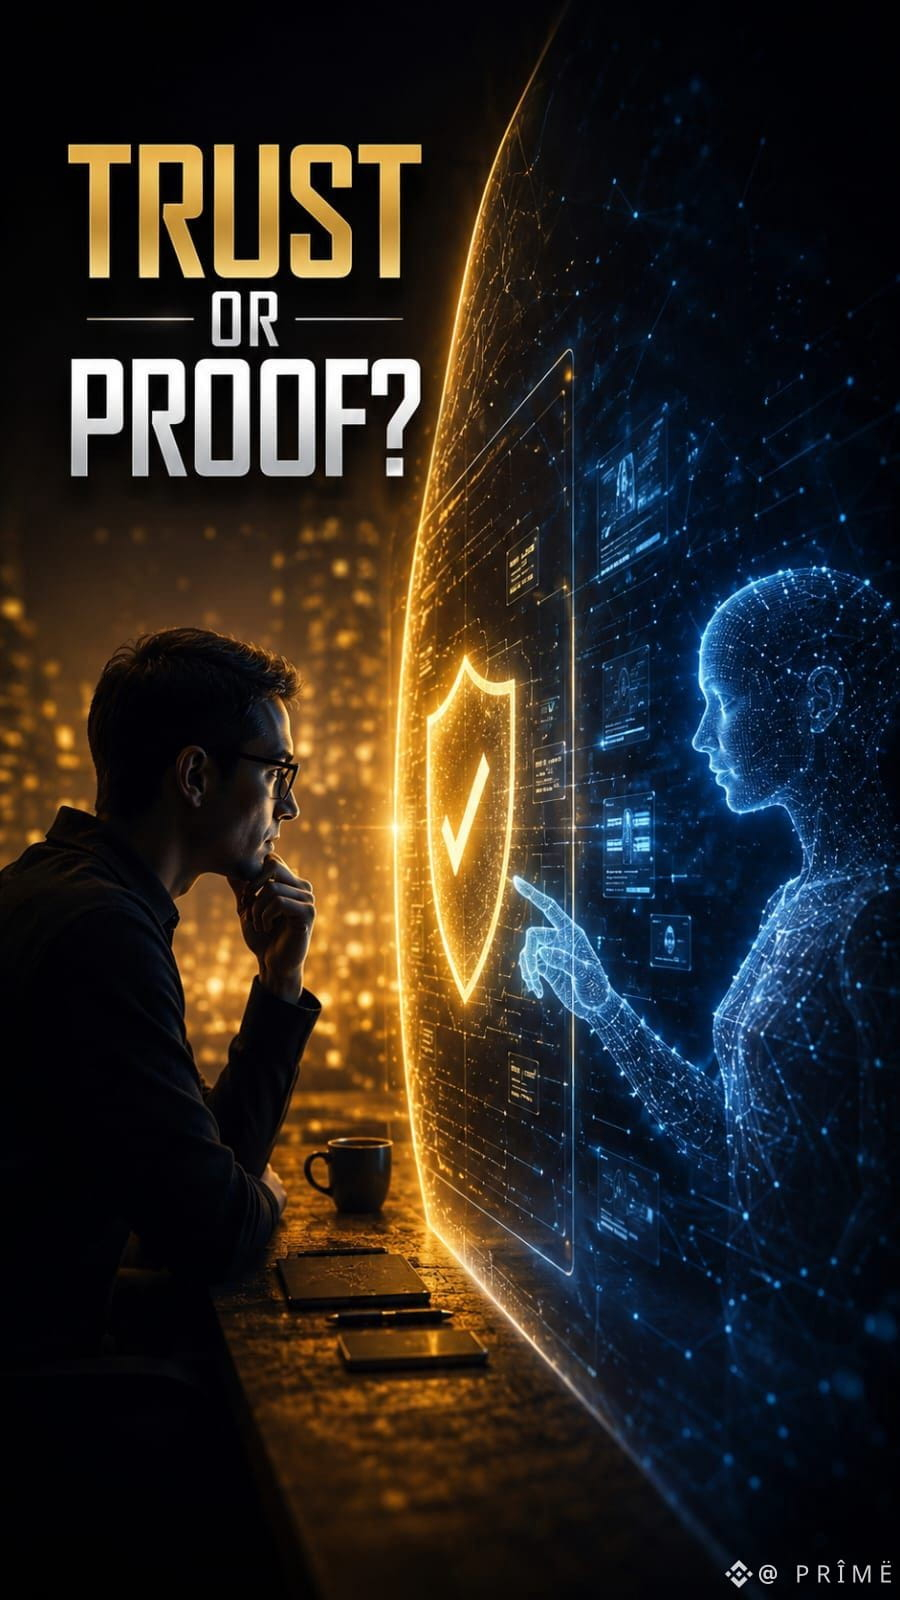
إنها ما إذا كانت أنظمة الذكاء الاصطناعي المستقبلية ستُبنى على الثقة وحدها أو ما إذا كان الدليل في النهاية سيصبح مهمًا بنفس القدر.
مع تزايد انغماس الذكاء الاصطناعي في القرارات اليومية، يبدو أن هذا التمييز يصبح من الصعب تجاهله بشكل متزايد.
#OPG #OpenGradient $OPG
كنت أعتقد أن السؤال الأكثر أهمية في الذكاء الاصطناعي هو ما إذا كانت النماذج تزداد ذكاءً.
في الآونة الأخيرة، بدأت أفكر في سؤال مختلف.
ماذا يحدث عندما يصبح الذكاء الاصطناعي شيئًا نعتمد عليه كل يوم؟
ليس كروبوت محادثة. وليس كعرض توضيحي.
ولكن كجزء من البحث، والتداول، وتطوير البرمجيات، وإنشاء المحتوى، وأنظمة اتخاذ القرار.
كلما اندمج الذكاء الاصطناعي في سير العمل الواقعي، كلما شعرت أن النقاش لا يتعلق بالقدرة فقط.
يبدأ الأمر وكأنه سؤال ثقة.
قليل منا يفكر في كيفية إنتاج ردود الذكاء الاصطناعي. نرى إجابة، نحدد ما إذا كانت تبدو مفيدة، ونتابع.
هذا يعمل حتى تؤثر النتيجة على شيء مهم.
في تلك النقطة، يصبح الفجوة الغريبة مرئية.
يمكننا تقييم النتيجة، لكن غالبًا لا يمكننا التحقق بشكل مستقل من كيفية إنتاجها، ما هي العملية التي أنتجتها، أو ما إذا كان هناك أي تغيير على طول الطريق.
أثناء استكشاف OpenGradient، أصبحت تلك الفجوة الجزء الأكثر إثارة للاهتمام في المشروع بالنسبة لي.#opg
بدلاً من التركيز فقط على بناء أو استضافة نماذج الذكاء الاصطناعي، يركز المشروع على تنفيذ الذكاء الاصطناعي القابل للتحقق.
الفكرة بسيطة: تجاوز "ثق في المزود" وجعل التحقق جزءًا من البنية التحتية نفسها.
لست مقتنعًا بأن كل تطبيق للذكاء الاصطناعي سيحتاج إلى هذا المستوى من الشفافية.
الراحة قوية، ومعظم المستخدمين يختارون بشكل طبيعي الخيار الأسهل المتاح.
لكن التاريخ يظهر أن الأنظمة المهمة غالبًا ما تتطور في نفس الاتجاه. أولاً تأتي الوظائف. لاحقًا تأتي المساءلة.
لهذا السبب أعتقد أن النقاش الأكبر ليس حول الذكاء الاصطناعي مقابل العملات المشفرة، أو المركزية مقابل اللامركزية، أو حتى أي نموذج هو الأكثر ذكاءً.
إنها ما إذا كانت أنظمة الذكاء الاصطناعي المستقبلية ستُبنى على الثقة وحدها أو ما إذا كان الدليل في النهاية سيصبح مهمًا بنفس القدر.
مع تزايد انغماس الذكاء الاصطناعي في القرارات اليومية، يبدو أن هذا التمييز يصبح من الصعب تجاهله بشكل متزايد.
#OPG #OpenGradient $OPG