#opg $OPG
كنت أفكر في كيفية تركيز المناقشات حول الذكاء الاصطناعي غالبًا على أداء النموذج، بينما يتلقى مفهوم الثقة اهتمامًا أقل بكثير. كلما أصبح الذكاء الاصطناعي أكثر قدرة، من المهم معرفة مصدر البيانات، وكيف يتم اتخاذ القرارات، وما إذا كان يمكن التحقق من النتائج. هذه واحدة من الأسباب التي تجعل @OpenGradient radient تبرز بالنسبة لي.
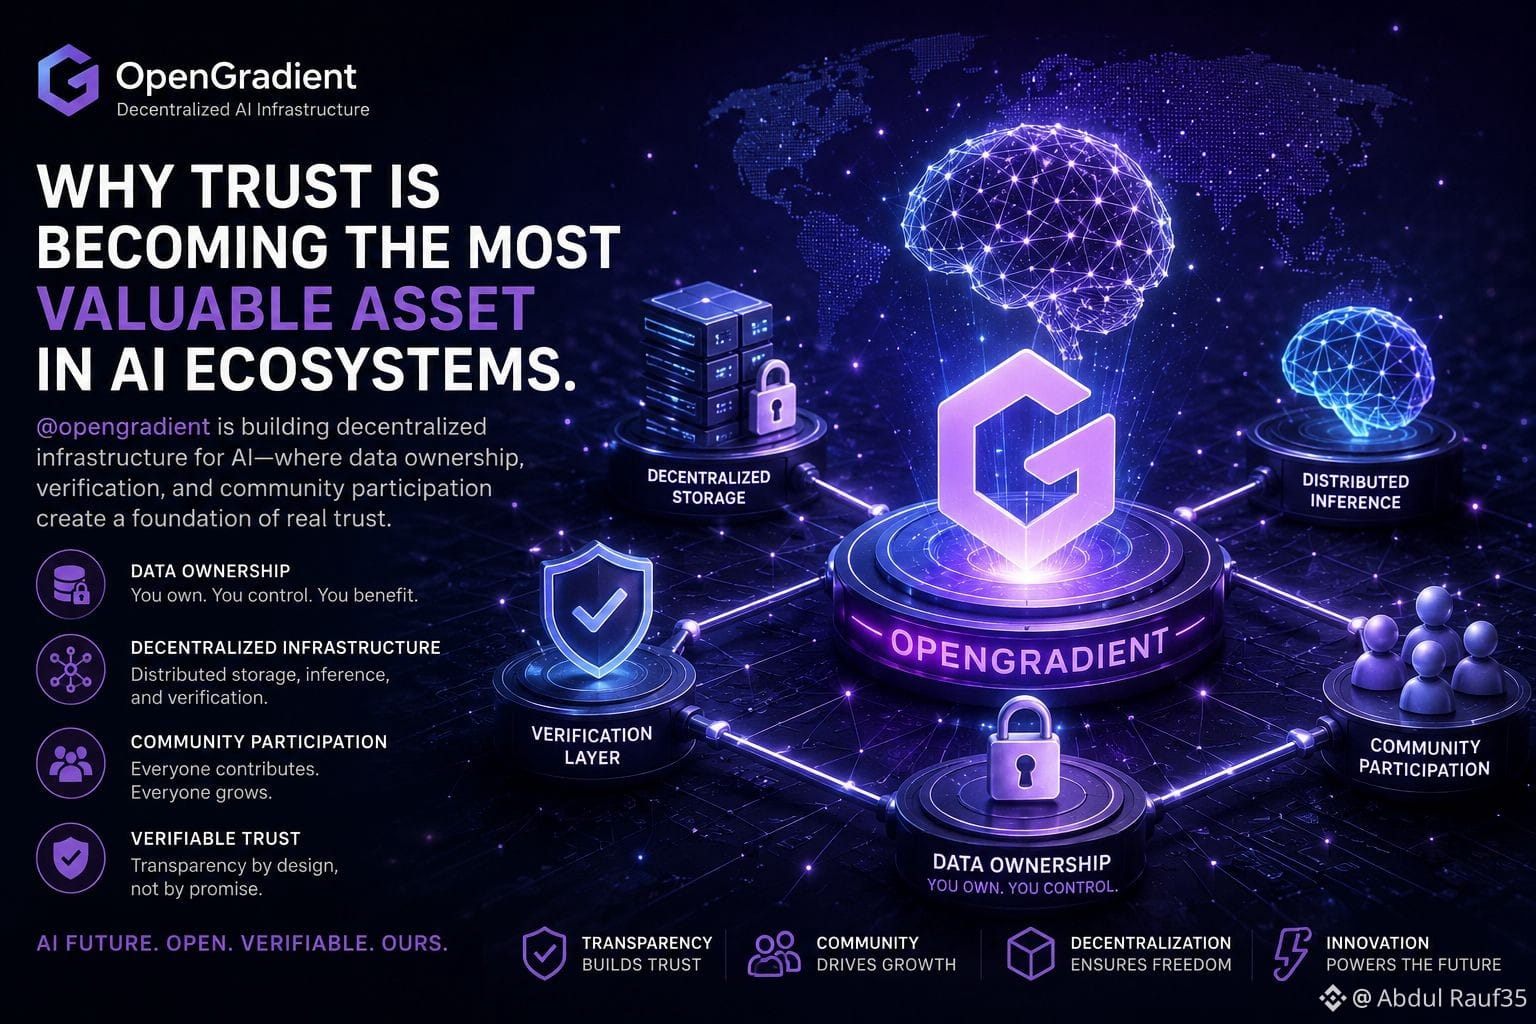
ما أجد مثيرًا للاهتمام بشأن @OpenGradient radient هو أنها تتعامل مع الثقة كمشكلة بنية تحتية بدلاً من مشكلة علامة تجارية. من خلال دمج الذكاء الاصطناعي مع بنية تحتية لامركزية، تستكشف @OpenGradient radient كيف يمكن أن يصبح التحقق، وملكية البيانات، ومشاركة المجتمع جزءًا من النظام نفسه بدلاً من الاعتماد على الثقة العمياء في المزودين المركزيين.
الدرس الذي تعلمته من Web3 هو أن الشفافية غالبًا ما تتوسع بشكل أفضل من الوعود. إذا كان الذكاء الاصطناعي سيقود تطبيقات حيوية، فسوف يحتاج المستخدمون إلى طرق للتحقق من النتائج، وفهم الحوافز، والاحتفاظ بالتحكم في مساهماتهم. @OpenGradient radient تدفع هذا النقاش إلى الأمام.
مع نمو نظم الذكاء الاصطناعي، هل ستصبح الثقة هي الأصول الأكثر قيمة - وهل يمكن أن تساعد الشبكات اللامركزية في خلقها بشكل أكثر فعالية من النماذج التقليدية؟
#OpenGradient $OPG @OpenGradient
كنت أفكر في كيفية تركيز المناقشات حول الذكاء الاصطناعي غالبًا على أداء النموذج، بينما يتلقى مفهوم الثقة اهتمامًا أقل بكثير. كلما أصبح الذكاء الاصطناعي أكثر قدرة، من المهم معرفة مصدر البيانات، وكيف يتم اتخاذ القرارات، وما إذا كان يمكن التحقق من النتائج. هذه واحدة من الأسباب التي تجعل @OpenGradient radient تبرز بالنسبة لي.
ما أجد مثيرًا للاهتمام بشأن @OpenGradient radient هو أنها تتعامل مع الثقة كمشكلة بنية تحتية بدلاً من مشكلة علامة تجارية. من خلال دمج الذكاء الاصطناعي مع بنية تحتية لامركزية، تستكشف @OpenGradient radient كيف يمكن أن يصبح التحقق، وملكية البيانات، ومشاركة المجتمع جزءًا من النظام نفسه بدلاً من الاعتماد على الثقة العمياء في المزودين المركزيين.
الدرس الذي تعلمته من Web3 هو أن الشفافية غالبًا ما تتوسع بشكل أفضل من الوعود. إذا كان الذكاء الاصطناعي سيقود تطبيقات حيوية، فسوف يحتاج المستخدمون إلى طرق للتحقق من النتائج، وفهم الحوافز، والاحتفاظ بالتحكم في مساهماتهم. @OpenGradient radient تدفع هذا النقاش إلى الأمام.
مع نمو نظم الذكاء الاصطناعي، هل ستصبح الثقة هي الأصول الأكثر قيمة - وهل يمكن أن تساعد الشبكات اللامركزية في خلقها بشكل أكثر فعالية من النماذج التقليدية؟
#OpenGradient $OPG @OpenGradient