أتذكر محادثة أجريتها منذ فترة مع صديق يعمل في الذكاء الاصطناعي. قضينا ساعات نتحدث عن النماذج، قوة الحوسبة، وحدات معالجة الرسوميات، وكل الأشياء المعتادة التي يرتبط بها الناس بالذكاء الاصطناعي.
في ذلك الوقت، افترضت أن هذه كانت حيث تحدث المنافسة الحقيقية.
بناء نماذج أكبر. التدريب على بيانات أكثر. الحصول على وصول إلى مزيد من الحوسبة.
بسيطة.
لكن كلما تابعت المجال أكثر، كلما بدأت ألاحظ شيئاً يبدو أنه مغفَل.
لم تكن ذكاءً.
كانت الذاكرة.
ليس الذاكرة بالمعنى التقني. أعني الذاكرة بالطريقة التي تتذكر بها الأنظمة الناجحة ما هو مهم وتغفل ما ليس كذلك.
ما إن بدأت في التفكير في الأمر، رأيت أمثلة في كل مكان.
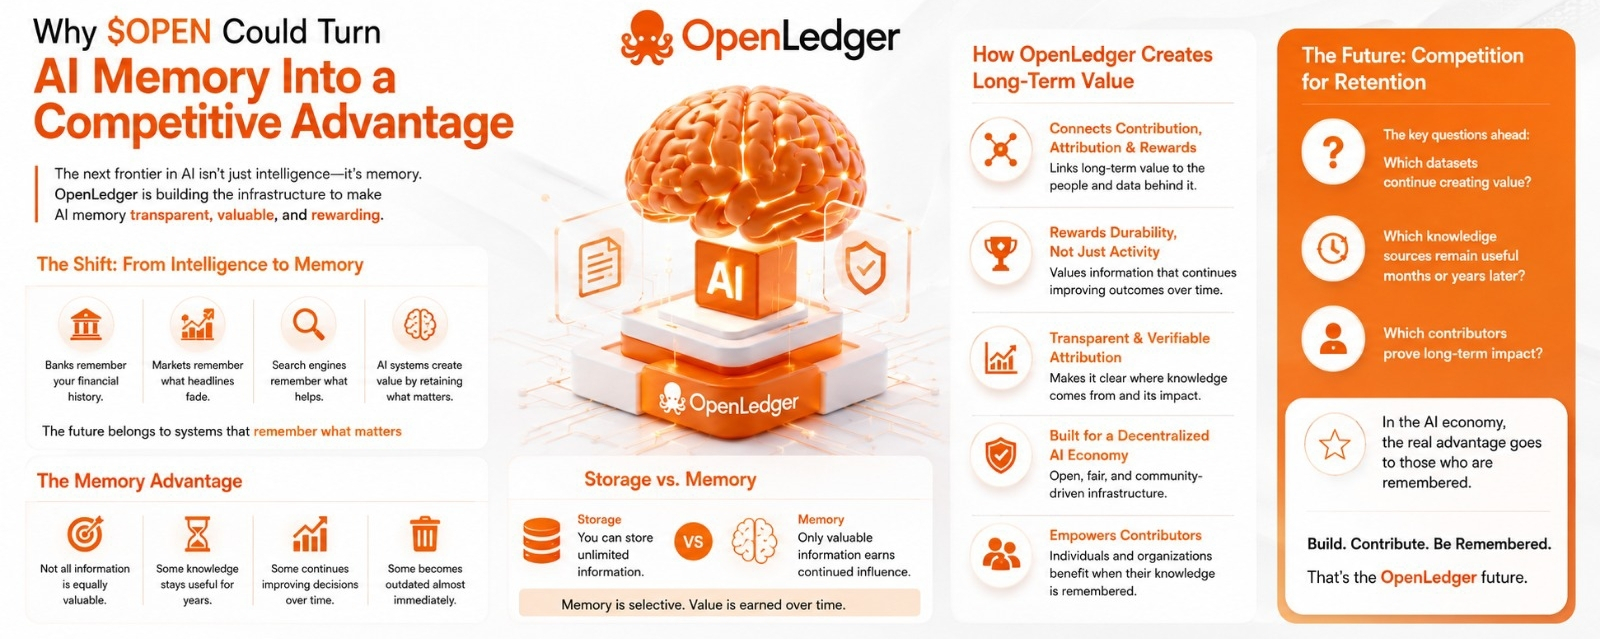
البنوك تتذكر تاريخك المالي.
تتذكر الأسواق المعلومات بعد زوال العناوين الرئيسية بوقت طويل.
تتذكّر محركات البحث المصادر التي تُفيد المستخدمين باستمرار.
غالباً ما لا تكون الأنظمة التي تخلق أكبر قيمة هي التي تعرف أكثر. بل تلك التي تحتفظ بأكبر قدر من المعلومات المفيدة عبر الزمن.
وهذه إحدى الأسباب التي تجعل OpenLedger يلفت انتباهي باستمرار.
معظم نقاشات الذكاء الاصطناعي اليوم ما زالت تركز على توليد إجابات أفضل. لكنني أجد نفسي أتساءل عن سؤال مختلف:
كيف يقرر الذكاء الاصطناعي ما الذي يستحق أن يُتَذكَّر؟
لأن ليست كل المعلومات متساوية في القيمة.
بعض المعرفة تبقى مفيدة لسنوات.
يتحول بعضها إلى قديم تقريباً فوراً.
بعض المعلومات يستمر في تحسين القرارات بعد وقتٍ طويل من دخولها إلى نظام، بينما يفقد نوع آخر من المعلومات أهميته بهدوء.
وفي الوقت الحالي، يبدو أن الصناعة تقضي وقتاً أكبر بكثير في مناقشة كيفية تعلم الذكاء الاصطناعي مقارنة بكيفية تذكّره.
كلما فكرت في الأمر أكثر، زاد شعوري بأن الذاكرة قد تكون مشكلة اقتصادية بقدر ما هي مشكلة تقنية.
تخيّل شخصين يساهمان بمعلومات في شبكة ذكاء اصطناعي.
يساهم أحدهم ببيانات تستمر في تحسين النتائج بعد سنوات.
بينما يساهم الآخر بمعلومات بدت مفيدة في البداية لكنها أصبحت غير ذات صلة بسرعة.
في البداية، قد تبدو كلتا المساهمتين متساويتين في القيمة.
الفرق لا يصبح واضحاً إلا مع مرور الوقت.
وهنا يصبح نهج OpenLedger مثيراً للاهتمام بالنسبة لي.
ما يلفت الانتباه ليس وعود الذكاء الاصطناعي الأكثر ذكاءً. تكاد كل جهة مشروع تزعم ذلك.
ما يلفت الانتباه هو فكرة ربط المساهمة والإسناد والمكافآت بطريقة تجعل القيمة طويلة الأمد ظاهرة للعيان.
أتفكّر في الأمر باستمرار وأقارنه بما حدث مع الإنترنت.
في الأيام الأولى، كانت المعلومات في كل مكان، لكن العثور على المعلومات المفيدة كان صعباً.
ثم أدخلت محركات البحث أنظمة الترتيب.
فجأة، لم يكن المحتوى يتنافس فقط كي يكون موجوداً.
كانت تتنافس كي تبقى مرئية.
قد تكون الذكاء الاصطناعي يتحرك نحو لحظة مماثلة.
باستثناء هذه المرة، قد لا تكون المنافسة على جذب الانتباه.
قد يكون ذلك من أجل الاحتفاظ.
ما مجموعات البيانات التي تواصل خلق قيمة؟
ما مصادر المعرفة التي تظل مفيدة بعد أشهر أو سنوات؟
أي المساهمين يمكنهم إثبات أن معلوماتهم تستمر في تحسين النتائج بعد وقت طويل من تقديمها؟
تبدو هذه الأسئلة أكثر أهمية على نحو متزايد مع ازدياد انخراط الذكاء الاصطناعي في القرارات الواقعية.
أمر واحد أدركته هو أن التخزين والذاكرة ليسا الشيء نفسه.
يمكنك تخزين كمية غير محدودة من المعلومات.
لا يعني ذلك أن أي شيء منها لا يهم.
الذاكرة انتقائية.
تكسب بعض المعلومات تأثيراً مستمراً.
معظم المعلومات لا.
إذا تمكن OpenLedger من المساعدة في جعل هذه العملية أكثر شفافية، فقد يبدأ المساهمون بتحسين شيء مختلف.
ليس الحجم.
المتانة.
وكذلك أن المتانة أصعب بكثير على التقليد.
يمكن لأي شخص رفع البيانات.
يمكن لأي شخص إنشاء محتوى.
لقد رأينا ذلك عبر الإنترنت لسنوات.
لكن المعلومات التي تبقى مفيدة بعد وقت طويل من إنشائها نادرة بكثير.
مجموعة بيانات ما زالت تُحسّن النتائج بعد ثمانية عشر شهراً تروي قصة.
مصدر يُستشهد به باستمرار عبر آلاف التفاعلات يخبرنا شيئاً آخر.
مع مرور الوقت، يبدأ السوق بالتمييز بين المعلومات التي توجد وبين المعلومات التي تبقى.
أظن أن هذا التمييز يصبح أكثر أهمية مع انتقال الذكاء الاصطناعي بعمق إلى مجالات مثل التمويل، وبرمجيات المؤسسات، والرعاية الصحية، وغيرها من البيئات التي تكون فيها القرارات لها تبعات حقيقية.
لأن الناس في النهاية سيطرحون أسئلة بسيطة بشكل مدهش.
لماذا أوصى الذكاء الاصطناعي بذلك؟
ما المعلومات التي أثّرت في هذا القرار؟
من أين جاءت تلك المعرفة؟
حين تصبح تلك الأسئلة مهمة، تصبح الإسنادات مهمة أيضاً.
بالطبع، لا يضمن أي شيء مما سبق نجاح OpenLedger.
التحديات حقيقية.
قياس قيمة المعلومات أمرٌ بالغ الصعوبة.
المعرفة لا تنتقل عبر مسارات منظمة.
تؤثر مصادر مختلفة في النتائج في الوقت نفسه.
تصير الإسنادات فوضوية.
وكما هو الحال مع أي نظام يقدّم مكافآت، ستوجد دائماً محاولات للعبث به.
لقد رأينا ذلك مع محركات البحث.
لقد رأينا ذلك مع وسائل التواصل الاجتماعي.
لن تكون شبكات الذكاء الاصطناعي مختلفة عن ذلك.
لكن هذا في الواقع جزء مما يجعل الفرصة مثيرة للاهتمام.
المشكلة ما زالت في بدايتها.
لم يحلّ أحد هذه المشكلة بالكامل.
ما يجعلني أواصل الانتباه ليس فكرة أن ذاكرة الذكاء الاصطناعي يجب أن تكون دائمة.
إنها فكرة أن الذاكرة يمكن أن تصبح منافِسة.
ربما لن يُحدَّد اقتصاد الذكاء الاصطناعي في المستقبل فقط من خلال من يبني أذكى النماذج.
ربما ستُحدَّد أيضاً من خلال من يقدّم معلومات قيّمة بما يكفي لتُتَذكَّر.
ويبدو ذلك كفرصة أكبر بكثير مما يدركه معظم الناس.
@OpenLedger #OpenLedeger #openledger $OPEN