لقد كنت أبحث في OpenLedger بعمق خلال الأيام القليلة الماضية وبصراحة أعتقد أن معظم الناس لا يزالون ينظرون إليه من الزاوية الخطأ.
الجميع يناديه "مجرد مشروع آخر للذكاء الاصطناعي + الكريبتو" لكن كلما قرأت عن نظام النسب الخاص بهم، أصبح الأمر أكثر إثارة.
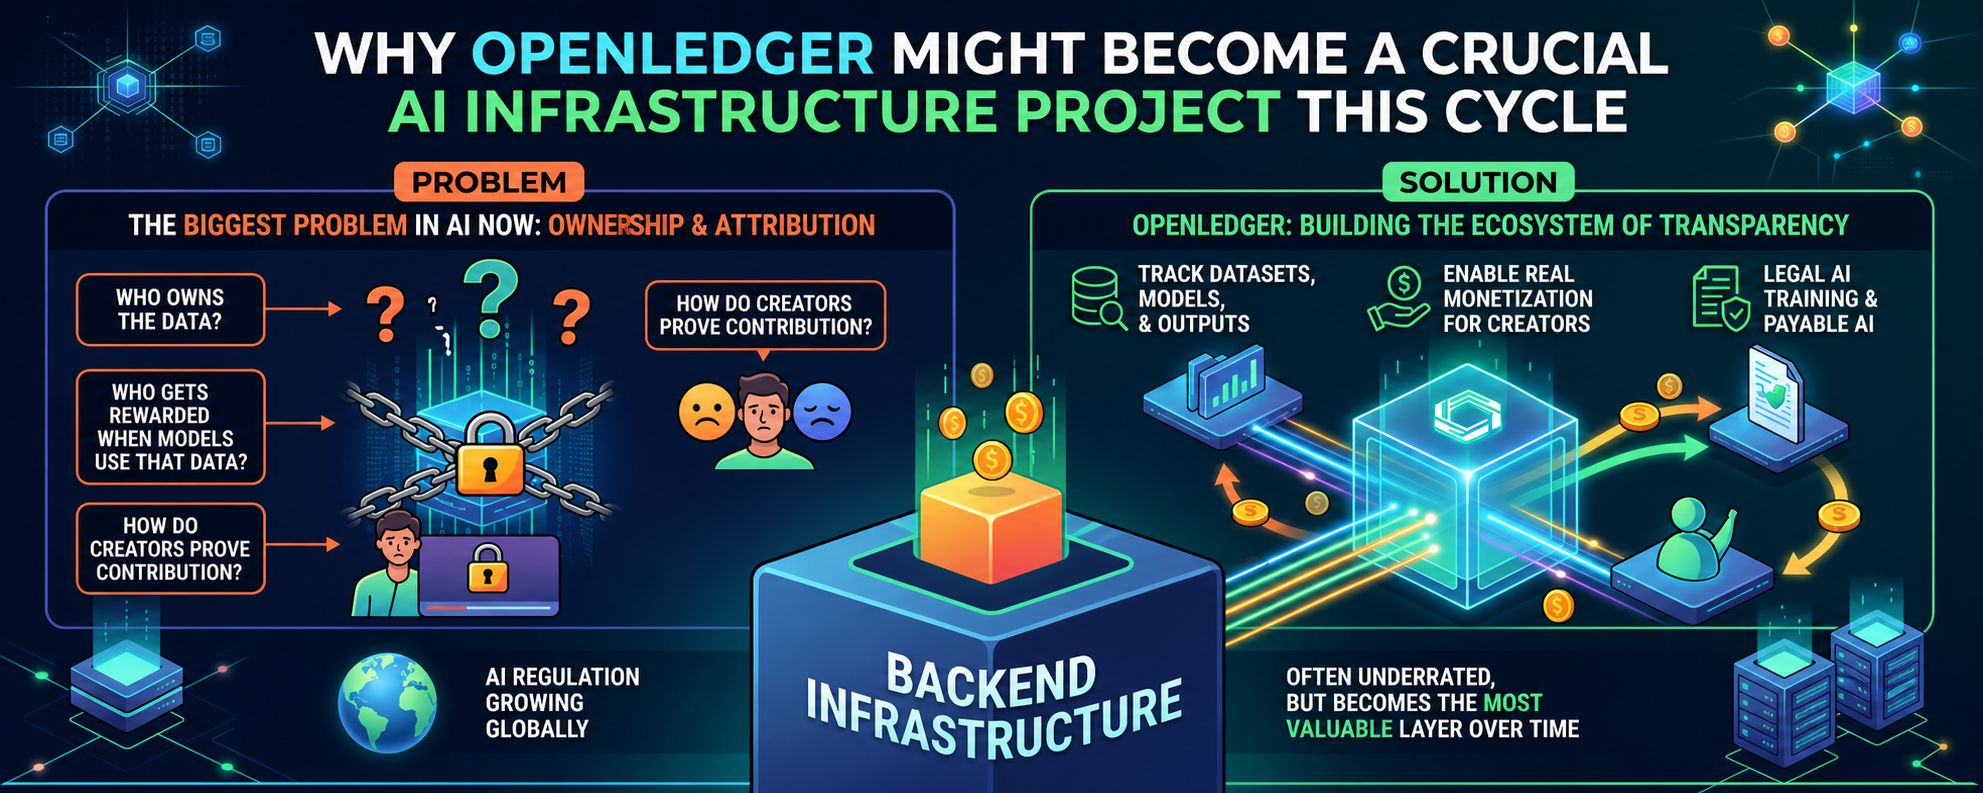
أكبر مشكلة في الذكاء الاصطناعي الآن ليست فقط في قدرة الحوسبة.
إنها الملكية.
من يملك البيانات؟
من يحصل على المكافأة عندما تستخدم النماذج تلك البيانات؟
كيف يثبت المبدعون مساهمتهم؟
هنا يبدأ OpenLedger في التميز.
إنهم يحاولون بناء نظام بيئي حيث يمكن تتبع مجموعات البيانات، ونماذج الذكاء الاصطناعي، والمخرجات وتحقيق الربح منها بدلاً من أن تصبح غير مرئية داخل الأنظمة المغلقة.
وإذا استمرت لوائح الذكاء الاصطناعي في النمو عالميًا، فقد تصبح المشاريع التي تركز على الشفافية والإسناد أكثر أهمية بكثير مما يتوقعه الناس.
ومن الأشياء الأخرى التي لاحظتها أن OpenLedger تتموضع أكثر كأنها بنية تحتية بدلًا من كونها روايات ذكاء اصطناعي مبنية على الضجيج. هذا الجزء يبدو أقل تقديرًا برأيي.
على الأرجح لن يلاحظ معظم المستخدمين حتى هذه الأنظمة عندما تعمل في الخلفية يومًا ما، لكن البنية التحتية للخادم غالبًا ما تصبح الطبقة الأكثر قيمة مع مرور الوقت.
ما يزال الأمر مبكرًا بالطبع، لكن التنفيذ يَهم كثيرًا من هنا فصاعدًا.
لكن السردية المتعلقة بتدريب الذكاء الاصطناعي القانوني والذكاء الاصطناعي المدفوع بدأت الآن تبدو منطقية أكثر بكثير بعد التعمق في المشروع.
@OpenLedger #openlegeder $OPEN