في الآونة الأخيرة، بعد استكشاف العديد من مشاريع الذكاء الاصطناعي وبيئات الذكاء الاصطناعي المعتمدة على blockchain، بدأت أفكر في مشكلة واحدة بعمق أكبر: الثقة في البيانات.
يعتقد معظم الناس أن مستقبل الذكاء الاصطناعي يعتمد بشكل رئيسي على نماذج أكبر، والمزيد من وحدات معالجة الرسوميات، وبنية تحتية أقوى للحوسبة. يبدو أن كل مشروع جديد يركز على معالجة أسرع، وشبكات عصبية أكبر، وقوة حسابية أرخص.
لكن كلما قرأت أكثر، كلما شعرت أن قوة الحوسبة الخام ليست أكبر مشكلة ستواجهها الذكاء الاصطناعي على المدى الطويل.
التحدي الحقيقي هو الشفافية.
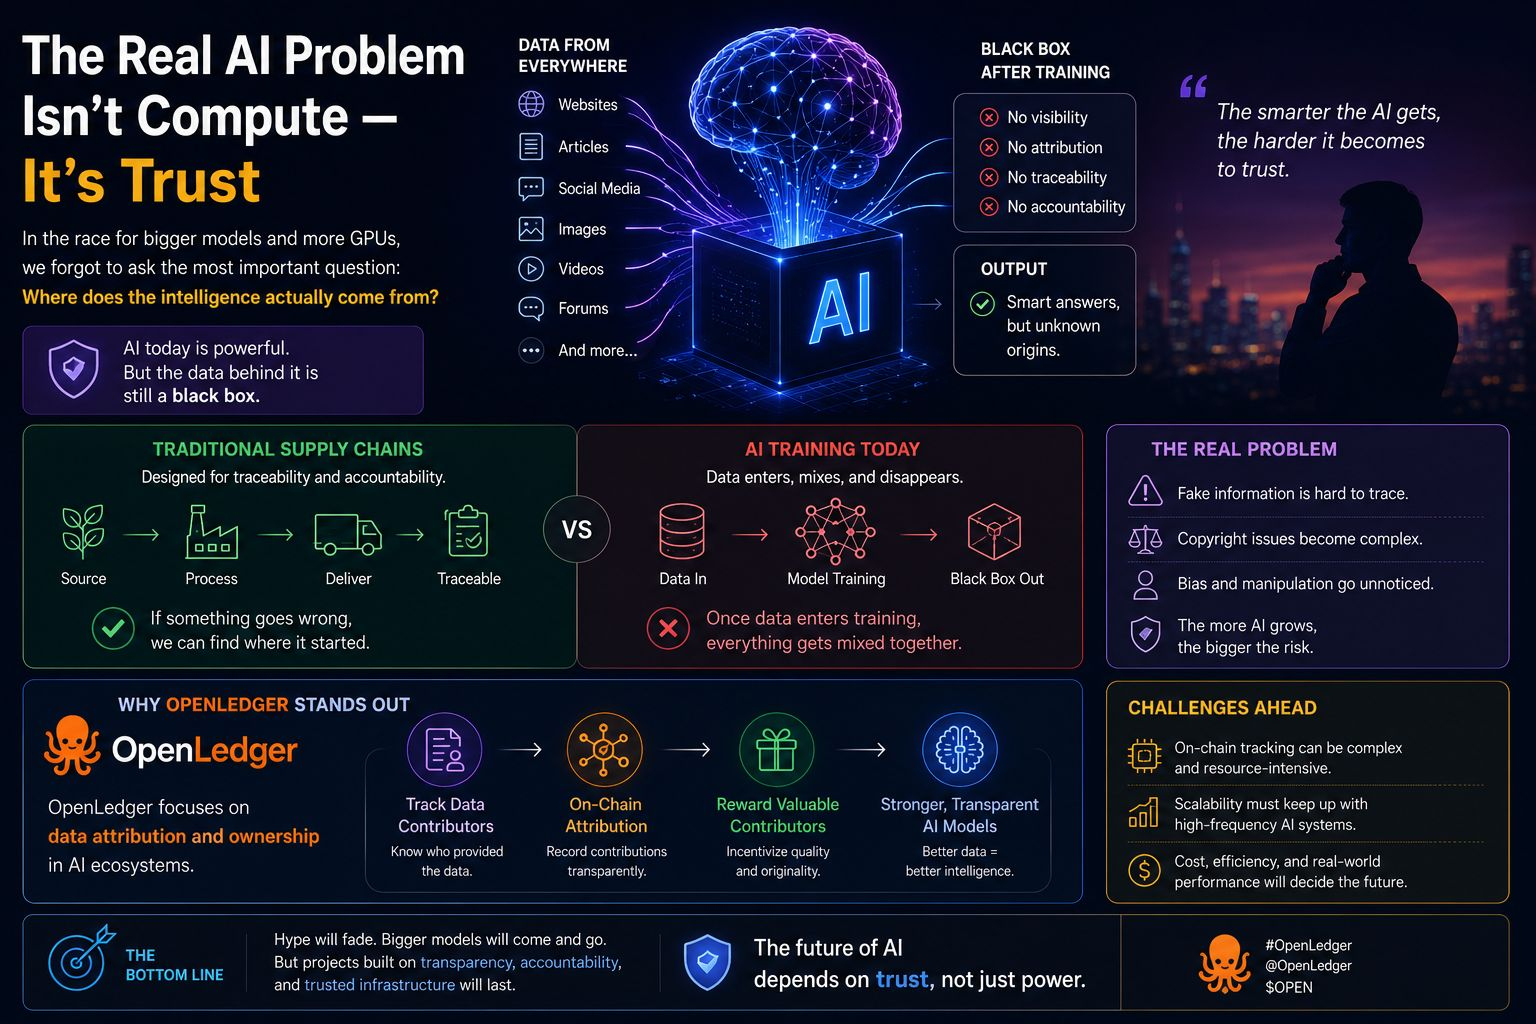
تُدرَّب أنظمة الذكاء الاصطناعي الحالية على كميات هائلة من بيانات الإنترنت المجمّعة من مصادر لا تُحصى.
يمكن لهذه النماذج أن تُنشئ ردودًا ذكية، وصورًا واقعية، ومحادثات تبدو بشرية بشكل مدهش.
ومع ذلك، ما زال هناك سؤال كبير لا يستطيع أحد الإجابة عنه بالكامل:
من أين يأتي هذا القدر من الذكاء بالضبط؟
بمجرد دخول المعلومات في عملية التدريب، يصبح من الصعب للغاية تتبّعها.
يتم دمج البيانات من المقالات، والمواقع الإلكترونية، والمنتديات، ومنشورات وسائل التواصل الاجتماعي، والصور، ومقاطع الفيديو، معًا داخل النموذج.
مع مرور الوقت، يصبح الذكاء الاصطناعي أقوى، لكن القدرة على رؤية البيانات الأصلية تصبح أضعف.
وهذا يثير عدة مخاوف جدية.
إذا دخلت معلومات غير صحيحة إلى النموذج، يصبح من شبه المستحيل تتبّع المصدر لاحقًا. تنطبق المشكلة نفسها على المحتوى المتحيّز، والبيانات المجموعـة المُعدَّلة، والمواد المحمية بحقوق النشر. ومع ازدياد تقدم الذكاء الاصطناعي، قد تتضخم هذه المشكلات أكثر لأن الناس يعتمدون بشكل متزايد على المعلومات المُولّدة بالذكاء الاصطناعي في الحياة اليومية.
تذكّرني هذه الحالة بكيف تعمل سلاسل الإمداد التقليدية في صناعات مثل الأغذية والطب والتصنيع.
في تلك الصناعات، عادةً ما تحافظ الشركات على أنظمة لتتبّع السلاسل. ويمكن غالبًا تتبع المنتجات خطوة بخطوة من المنشأ حتى التسليم النهائي. وإذا ظهرت مشكلة، يستطيع المحققون تحديد مكان بدء المشكلة ومن كان مسؤولًا عنها.
تعمل بنية ذكاء اصطناعي البنية التحتية للذكاء الاصطناعي بشكل مختلف جدًا اليوم.
تعمل معظم النماذج مثل الصناديق السوداء: تدخل البيانات، ثم تختلط وتختفي داخل عملية التدريب دون إسناد واضح. يتلقى المستخدمون مخرجات، لكنهم نادرًا ما يعرفون ما المعلومات التي ساهمت في تلك النتائج.
لهذا السبب لفتت انتباه OpenLedger إليّ مؤخرًا.
بينما تتنافس العديد من المشاريع في المقام الأول حول البنية التحتية للحوسبة اللامركزية، يبدو أن OpenLedger تركز على شيء أوسع: إسناد البيانات والملكية داخل أنظمة ذكاء اصطناعي.
الفكرة نفسها مثيرة للاهتمام لأنها تُحوّل الاهتمام بعيدًا عن المنافسة على العتاد وحده.
بدلًا من الاكتفاء بالسؤال عن كيفية بناء نماذج ذكاء اصطناعي أقوى، يستكشف المشروع كيف يمكن للمساهمين إثبات أن بياناتهم ساعدت في تدريب نموذج وربما الحصول على مكافآت مقابل المساهمات القيمة. ومن الناحية النظرية، قد يخلق ذلك اقتصادًا للذكاء الاصطناعي أكثر شفافية، حيث يتم الاعتراف بمقدمي البيانات بدلًا من بقائهم غير مرئيين خلف أنظمة مركزية ضخمة.
بالطبع، ما زالت هناك تحديات كبيرة في الطريق.
تتبّع مساهمات البيانات على السلسلة يبدو فكرة قوية من الناحية المفاهيمية، لكن توسيع نطاق مثل هذه الأنظمة بكفاءة ليس بالأمر السهل. تعالج بيئات الذكاء الاصطناعي كميات ضخمة من البيانات بشكل مستمر، وقد يؤدي الحفاظ على سجلات الإسناد إلى تكاليف إضافية وزمن وصول وتأقلم تقني تعقيد. وستحتاج أنظمة الذكاء الاصطناعي عالية التردد إلى بنية تحتية قادرة على البقاء شفافة وفعّالة على نطاق كبير.
لذا، فإن الاختبار الحقيقي لمشاريع مثل OpenLedger لن يكون مجرد الرؤية — بل التنفيذ.
ومع ذلك، أعتقد أن هذه المحادثة مهمة.
في الوقت الحالي، يمتلئ قطاع الذكاء الاصطناعي بالمبالغة التسويقية والافتراضات والمنافسة المستمرة من أجل نماذج أكبر. لكن عندما تهدأ الحماسة في النهاية، قد تصبح المشاريع التي تبني بنية تحتية جديرة بالثقة، وأنظمة بيانات شفافة، وآليات للمساءلة أكثر أهمية بكثير مما يتوقعه الناس حاليًا.
على المدى الطويل، قد لا يحتاج الذكاء الاصطناعي فقط إلى مزيد من الذكاء.
قد يحتاج الأمر إلى مزيد من الثقة.