
 شيء واحد أعتقد أن السوق لا يزال يسيء فهمه حول الذكاء الاصطناعي هو أن الشركات لا تقوم فعلاً بتحسين الذكاء.
هم يقومون بتحسين البقاء.
هذا يبدو متشائمًا حتى تشاهد كيف تُتخذ قرارات التكنولوجيا في المؤسسات فعلاً.
المجالس لا تهتم ما إذا كان النموذج مثيرًا فلسفيًا. الإدارات القانونية لا تهتم ما إذا كانت البنية التحتية أنيقة. فرق الامتثال لا تستيقظ متحمسة بشأن معايير التفكير على الحدود. معظم الشركات تهتم في النهاية بشيء واحد:
هل يمكن لهذا النظام أن يخلق قيمة دون أن يولّد تعرّضاً غير قابل للسيطرة لاحقاً؟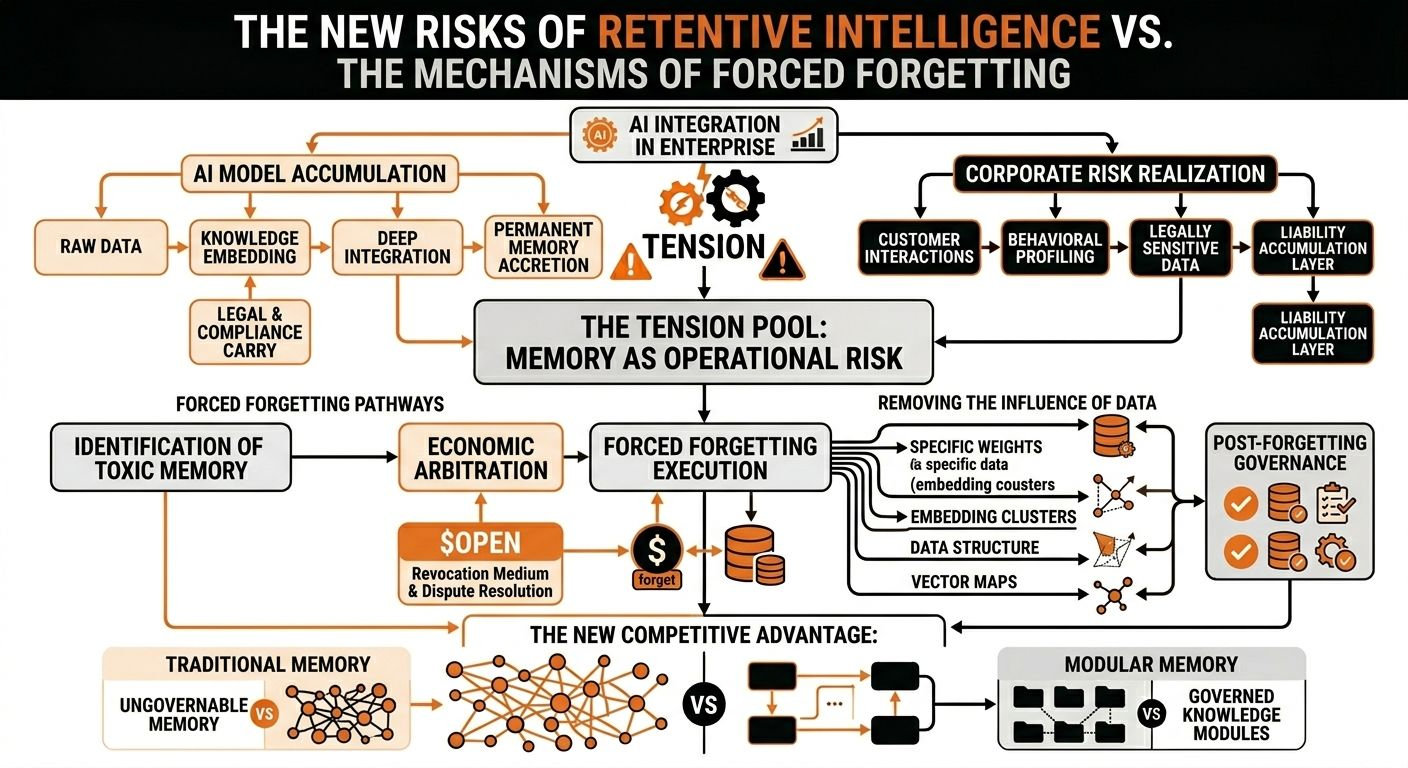
لهذا السبب تستمر OpenLedger في أن تصبح أكثر إثارة للاهتمام بالنسبة لي كلما فكرت بعمق في اتجاه ذكاء المؤسسات الاصطناعي.
ما يزال أغلب الناس ينظرون إلى OpenLedger عبر عدسة مألوفة: ذكاء اصطناعي لا مركزي. مساهمو البيانات، أنظمة النسبة (المنسوبية)، Datanets، تنسيق النماذج، وحوافز الرمز عبر $OPEN. حسنًا. هذا التفسير على مستوى السطح موجود.
لكنني أشك أكثر فأكثر بأن الطبقة الأكثر أهمية هي شيء آخر تماماً.
قد تكون OpenLedger في الواقع تُمهّد حول مستقبل يصبح فيه النسيان الانتقائي استراتيجية اقتصادية.
لأن سوق الذكاء الاصطناعي حالياً ما زال محاصراً بعقلية التراكم. كل شركة تعتقد أن الميزة التنافسية تأتي من الاحتفاظ بأكبر قدر ممكن من المعلومات. تفاعلات عملاء أكثر. أنماط سلوكية أكثر. سجلات تاريخية أكثر. سياق خاصية (ملكي) أكثر.
الافتراض الكامن وراء هذه الاستراتيجية بسيط: كلما زادت الذاكرة، كان الذكاء أفضل.
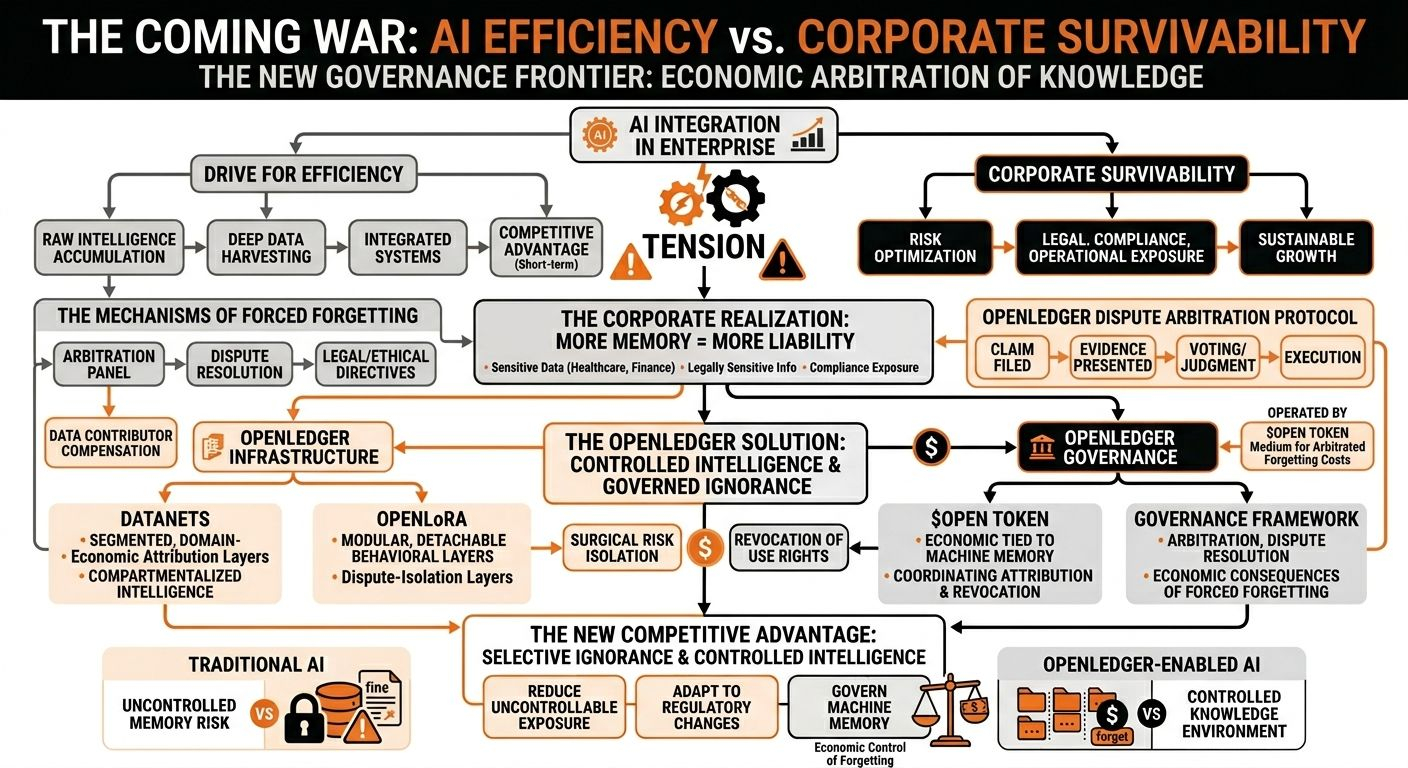
لكن هذا المنطق ينكسر بهدوء بمجرد أن تبدأ الذاكرة نفسها في توليد مخاطر قانونية وتشغيلية ومالية أسرع مما تولد قيمة.
وبصراحة، أعتقد أن كثيراً من المؤسسات أقرب إلى هذه القناعة بكثير مما يفهمه السوق العام.
في الوقت الحالي، ما زال أغلب أنظمة الذكاء الاصطناعي المؤسسية تعمل في بيئات مُتحكَّم بها نسبياً: مساعدون افتراضيون داخليون. دعم خدمة العملاء. أتمتة سير العمل. دعم التحليلات. لكن كلما تحرك الذكاء الاصطناعي إلى الصناعات المُنظَّمة والبنية التحتية الحساسة لاتخاذ القرار، كلما أصبح الذكاء المحتفظ به أكثر خطورة.
لأن الذاكرة المؤسسية ليست محايدة.
نموذج رعاية صحية يحتفظ بسياق تشخيص حساس ليس مجرد «ذكي». إنه يحمل مسؤولية قانونية. نظام استشارات مالية تم تدريبه على سنوات من بيانات سلوك العملاء ليس مجرد تخصيص. إنه يتراكم فيه التعرض للامتثال. قد يتسبب وكيل مؤسسي يستوعب الاتصالات الداخلية دون قصد في أن يصبح أرشيفاً دائماً لمعلومات حساسة قانونياً.
والجزء غير المريح حقاً هو هذا:
معظم أنظمة الذكاء الاصطناعي سيئة من الناحية البنيوية في النسيان بشكل نظيف.
وهذا يخلق مستقبلاً غريباً حيث قد تتنافس المؤسسات لاحقاً بدرجة أقل على مقدار ما تعرفه أنظمتها…
والمزيد حول مدى دقة قدرتهم على التحكم فيما يُسمح لتلك الأنظمة بالاستمرار في معرفته.
يبدو أن هذا التمييز مُسعّر بأقل من قيمته بكثير حالياً.
لأنّه بمجرد أن تُدمج البيانات عبر طبقات مُحَدَّدة بدقة، وأنظمة الاسترجاع، ومساحات المتجهات، وحتى سلوك النموذج نفسه، يتوقف الحذف عن العمل مثل الحذف التقليدي للبرمجيات. تكتشف المؤسسات ببطء أن «إزالة البيانات» و«إزالة تأثير البيانات» هما تماماً مشكلتان هندسيتان مختلفتان.
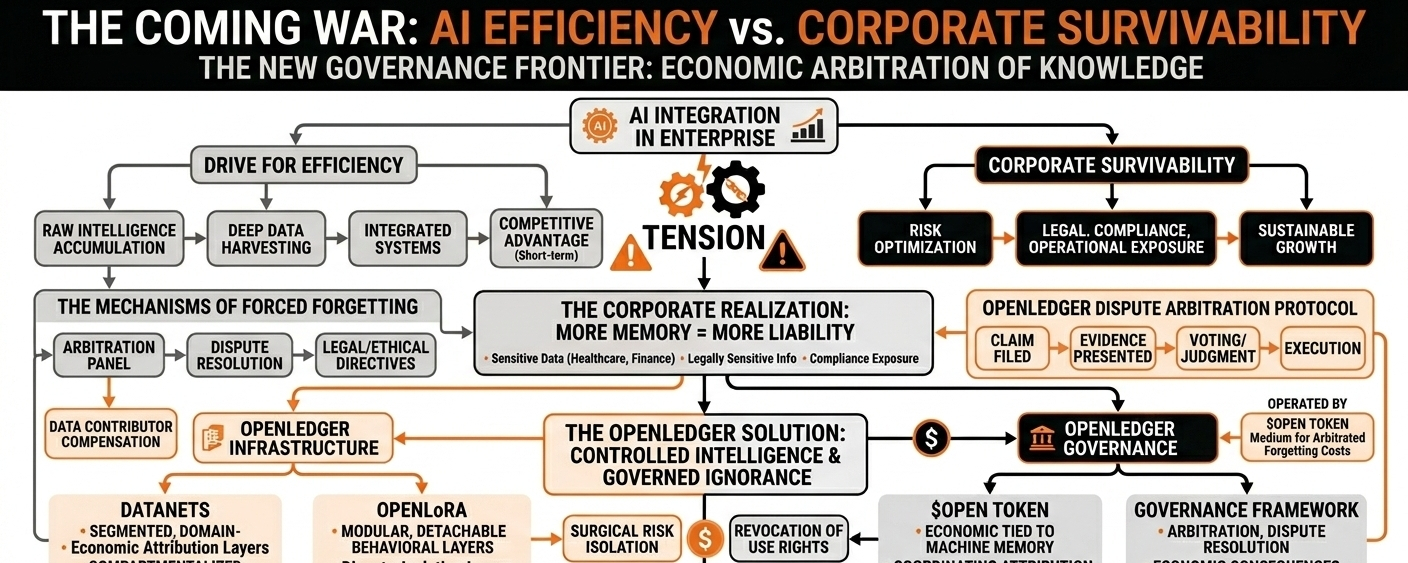
وهنا تبدأ OpenLedger تبدو أقل كأنها سوق بيانات لا مركزي، وأكثر كأنها بنية تحتية لتجزئة المخاطر المؤسسية.
إن بنية Datanet مثيرة للاهتمام لهذا السبب تحديداً. بدل التعامل مع الذكاء كحوض ذاكرة عملاق غير مُتميَّز، تدفع البنية نحو بيئات معرفة مجزأة ومحددة بالمجال مرتبطة بالنِسبة (المنسوبية) والمساءلة الاقتصادية.
للوهلة الأولى، يبدو ذلك غير كفؤ مقارنة بتراكم الذكاء الاصطناعي المركزي بالهجوم المباشر.
على المدى الطويل، قد يصبح ذلك ضرورياً على مستوى التشغيل.
لأن الذكاء المجزأ من الأسهل حوكمة من الذاكرة العامة الدائمة.
وهذا أيضاً هو سبب شعور OpenLoRA بأنها أكثر أهمية بكثير مما يدركه معظم الناس حالياً. يميل السوق إلى تصويرها كطبقة كفاءة لنشر تعديلات خفيفة للنماذج بتكلفة أقل. لكن الدلالة الأعمق هي المرونة المعمارية.
إذا أمكن تجزئة الذكاء، يمكن أيضاً فصله.
وهذا يغيّر اقتصاديات مخاطر ذكاء المؤسسات بالكامل.
لم تعد المؤسسة بحاجة إلى إعادة تدريب نظام تأسيسي كامل في كل مرة يتغير فيها إطار تنظيمي أو تصبح مجموعة بيانات ما مشكلة. يمكن نظرياً عزل طبقات سلوكية محددة أو فصلها أو استبدالها أو إهمالها اقتصادياً.
بعبارة أخرى، إن OpenLoRA ليست مجرد مساعدة على أن يتخصص الذكاء الاصطناعي.
إنها تساعد الذكاء الاصطناعي على أن يصبح قابلاً للاستغناء عنه انتقائياً.
قد ينتهي الأمر إلى أن يصبح ذلك ذا قيمة لا تصدق لاحقاً.
وخاصةً لأن المؤسسات نادراً ما تُحسن التخطيط للقيم المثالية. فهي تُحسن التخطيط للتعرّض القابل للسيطرة. إن القدرة على عزل مخاطر التشغيل بشكل جراحي دون انهيار كامل طبقات مكدس النظام هي شيء تدفع له الشركات تاريخياً مبالغ كبيرة كميزة مضافة.
وهذا يعيدني إلى $OPEN ذاته.
أعتقد أن أغلب الناس ما زالوا يقيّمون الرمز عبر منطق البنية التحتية للعملات المشفرة المعتاد: استخدام أكثر، معاملات أكثر، نشاط نظام بيئي أكثر، طلب أكثر.
ربما.
ولكن الإمكانية الأكثر إثارة للاهتمام هي أن $OPEN يرتبط اقتصادياً بحوكمة ذاكرة الآلة نفسها. ليس فقط تسهيل تدفقات الذكاء، بل تنسيق تكلفة نسبه واستمراره وإزالته في نهاية المطاف لطبقات ذكاء تعمل عبر أنظمة المؤسسات.
إنها سوق أغرب بكثير مما يدركه الناس.
لأنّه بمجرد أن تحمل الذاكرة وزناً مالياً وقانونياً، تتوقف بنية تحتية للذكاء الاصطناعي عن كونها تقنية بحتة.
تصبح مسألة سياسية.
من يتحكم في حقوق الإلغاء؟
من يفصل في النزاعات بين المساهمين والمؤسسات؟
من يقرر متى يصبح الذكاء المحتفظ به غير آمن؟
من يتحمل العواقب الاقتصادية للنسيان القسري؟
تلك الصراعات لا تملك إجابات واضحة.
وبصراحة، هذا هو بالضبط سبب شعور هذا المجال بأنه مهم بنيوياً.
لا تزال سوق الذكاء الاصطناعي تتصرف كما لو أن الذكاء الخام ما زال هو المورد النادر.
أعتقد أكثر فأكثر أن الذكاء المُتحكّم فيه سيصبح أشد ندرة.
هذا يغيّر أي طبقات البنية التحتية تصبح أكثر أهمية.
قد تفشل OpenLedger بالتأكيد. تفشل معظم بروتوكولات البنية التحتية. إن التعقيد التشغيلي وحده تحدٍ خطير. قد تستمر المؤسسات في تفضيل الغموض المركزي فقط لأنه أسهل وأسرع.
لكن إذا أصبح الذكاء الاصطناعي مُدمجاً بعمق في الحياة الاقتصادية لدرجة أن الذاكرة غير المتحكَّم فيها تتحول إلى خطر مؤسسي…
ثم قد تصبح الشركات القادرة على حوكمة جهل الآلة أكثر قيمة من الشركات التي تكتفي ببناء آلات أكثر ذكاءً.
وبصراحة، يبدو أن OpenLedger أصبحت واحدة من القلائل من المشاريع التي تبني بالفعل حول شدّة هذا المستقبل قبل أن يرى السوق ذلك بالكامل.
#OpenLedger #openledger $BSB @OpenLedger
#BitcoinBreaksBelow75KAsWarshTakesFedHelm #FenwickWestSettlesFTXFor54M #SECHaltsInnovationExemption