

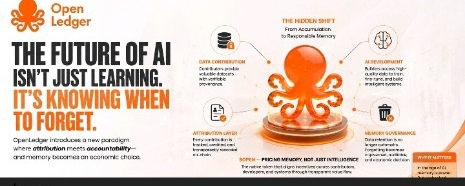
نمط ألاحظه باستمرار في أسواق التكنولوجيا هو أن الناس يهتمون بما يمكن أن تجمعه الأنظمة، لكنهم يقضون وقتًا أقل بكثير في التفكير فيما يجب أن يُسمح لتلك الأنظمة بالاحتفاظ به.
هذا يحدث في كل مكان. المنصات الاجتماعية تحتفظ ببيانات سلوكية لأنه يمكن أن تصبح مفيدة لاحقًا. تحتفظ التطبيقات المالية بالسجلات لفترة طويلة بعد أن ينتقل الزبون ذهنيًا. تجمع شركات الذكاء الاصطناعي مجموعات البيانات تحت افتراض أن المزيد من السياق عادة ما يحسن النتائج. كانت تلك المنطق منطقيًا عندما كانت التخزين رخيصًا وكان خطر القانون بعيدًا.
الآن أنا أقل يقينًا.
لأنه بمجرد أن يبدأ الذكاء في اتخاذ القرارات، تتوقف الذاكرة عن كونها أصلًا سلبيًا. وتصبح مصدرًا للمسؤولية.
لذلك جزئيًا لفت OpenLedger انتباهي، وإن لم يكن بالضرورة للسبب الواضح.
يركز معظم الناس على OpenLedger بوصفه سوق بيانات للذكاء الاصطناعي. يقدّم المساهمون بيانات مفيدة. يستهلكها البناؤون. تتحسن النماذج. $OPEN ينسّق الحوافز. قصة نظيفة. منطق كريبتو مألوف. عنوان سهل.
لكنني أعتقد أن ذلك التفسير قد يفوّت الجزء الأكثر غرابة.
ماذا لو كانت مشكلة البنية التحتية الحقيقية ليست في مساعدة الذكاء الاصطناعي على التعلّم بسرعة أكبر؟
ماذا لو كان يساعد الذكاء الاصطناعي على النسيان بشكل صحيح؟
يبدو ذلك مجردًا حتى تفكر في كيفية تصرف أنظمة الذكاء الاصطناعي الحديثة فعليًا. بمجرد امتصاص البيانات في عمليات التدريب، أو طبقات الاسترجاع، أو التمثيلات المتجهية، أو السلوكيات المضبوطة بدقة، أو منطق دعم القرار، لم يعد الحذف بديهيًا. كثيرًا ما يتخيل غير التقنيين الحذف كما لو كان إزالة مستند من التخزين السحابي. لكن في الواقع، ذاكرة الآلة أكثر فوضوية بكثير. المعلومات تتبدد.
أتذكر أنني قرأت قبل فترة نقاشات حول «التعلّم غير» الآلي، وشعرت بأن الفكرة كلها اعتذار هندسي. ليس لأن البحث ضعيف، بل لأنه يعترف بهدوء بشيء غير مريح: تعليم الآلات أسهل من جعلها تنسى بدقة.
ذلك مهم الآن أكثر مما كان عليه قبل عامين.
الجهات التنظيمية تصبح أكثر حدة. الشركات تصبح أكثر حذرًا. الذكاء الاصطناعي يقترب من سير عمل تتعلق بالهوية، والمدفوعات، والاتصالات الداخلية، ومراجعة الامتثال، وربما لاحقًا أتمتة القرارات حيث تكون الأخطاء مكلفة فعليًا.
ومع بدء الأنظمة في ملامسة الأسطح التشغيلية الحقيقية، يتغير السؤال.
لم يعد السؤال «هل يمكن لهذا النموذج أن يؤدي؟»
يصبح الأمر «ما الذي ينقله هذا النموذج بالضبط إلى الأمام؟»
سؤال مختلف. تبعات أكبر.
هذا هو السبب الذي يجعل OpenLedger أكثر إثارة لاهتمامي.
إذا نجح OpenLedger في جعل الإسناد دائمًا وذا مغزى اقتصادي، فإن الذاكرة المحتفظ بها لم تعد بنية تحتية مجانية. بل تصبح كائنًا اقتصاديًا مُدارًا.
ذلك يغيّر هيكل الحوافز بطريقة لا أعتقد أن السوق الأوسع قد سعّرها بالكامل بعد.
عادةً، تحتفظ أنظمة الذكاء الاصطناعي بالمعلومات لأن الاحتفاظ بها مفيد. تخصيص أفضل. استمرارية أفضل. مخرجات أفضل. والافتراض الاقتصادي الكامن بسيط: الإبقاء على السياق يكون عادةً مفيدًا.
لكن في شبكة يمكن فيها تحديد هوية المساهمين، وترتبط فيها تدفقات القيمة بالأصل، تبدأ الذاكرة في حمل تكلفة.
ومتى أصبحت الذاكرة تحمل تكلفة، يصبح النسيان عقلانيًا.
هذا هو الجزء الذي يواصل الناس تجاوزه.
تخيّل مساعدًا مؤسسيًا للذكاء الاصطناعي تدرب جزئيًا على تفاعلات ملكية مع العملاء. بعد ستة أشهر، يغيّر أحد العملاء أذونات البيانات. أو تتبدل اللوائح. أو تقرر الشركة أن بعض التفاعلات التاريخية تخلق تعرضًا قانونيًا. المشكلة ليست مجرد حذف السجلات. إنها تحديد ما إذا كان ينبغي للذكاء الذي تشكّل بتلك التفاعلات أن يظل نشطًا اقتصاديًا وتشغيليًا أم لا.
ويتفاقم الأمر بسرعة.
قطاع الرعاية الصحية يجعل هذا أكثر إزعاجًا. وكذلك أنظمة الاستشارات المالية.
في الواقع، حتى وكلاء الذكاء الاصطناعي البسطاء يخلقون هذا التوتر. إذا كانت البرامج الذاتية تبني ذاكرة سلوكية عن الأطراف المقابلة، أو عادات المعاملات، أو التفاعلات المتكررة، فإن تلك الذاكرة تصبح مفيدة استراتيجيًا. لكنها تصبح خطرة أيضًا.
الذاكرة المفيدة والذاكرة الإشكالية غالبًا ما تبدوان متطابقتين حتى يحدث خطأ ما.
يفهم أهل الكريبتو هذا النمط أفضل من معظم الناس، على نحو غريب. بدت السجلات الدائمة أنيقة إلى أن اصطدمت الخصوصية بالدوام. وفجأة، لم تعد «عدم القابلية للتغيير» تبدو إيجابية عالميًا.
قد يكون الذكاء الاصطناعي بصدد الدخول في نسخته الخاصة من ذلك التناقض.
يقع OpenLedger، عن قصد أو غير قصد، قريبًا من نقطة الضغط هذه.
لأن أنظمة الإسناد تفعل شيئًا دقيقًا. إنها تجعل الذاكرة قابلة للقراءة.
ومتى أصبحت الذاكرة مقروءة، يمكن الطعن فيها.
تظهر مطالبات التعويض. تظهر نزاعات الملكية. تظهر الأسئلة التنظيمية. وتصبح المسؤولية أقل غموضًا.
هذا لا يعني تلقائيًا أن OpenLedger يحل المشكلة. أعتقد أن الناس يقفزون بسرعة كبيرة من مخططات البنية إلى الحتمية.
تتبّع الأصل أسهل من ضمان النسيان الآلي الهادف.
تحدٍّ هندسي مختلف تمامًا.
والاقتصاد الرمزي هنا ليس تافهًا أيضًا.
كثير من قصص البنية التحتية في الكريبتو تبدو أنيقة حتى تطرح سؤال الطلب المزعج. لماذا يحتاج الرمز إلى ضغط عضوي مستدام بدلًا من المضاربة المؤقتة؟
إذا أصبح $OPEN مرتبطًا باستمرارية الإسناد، أو تنسيق الوصول، أو توجيه القيمة المرتبطة بالبيانات، فقد تكون هناك حلقة اقتصادية مقنعة. ربما.
لكن أنظمة الحوافز يمكنها أيضًا أن تبالغ في تعقيد نفسها. إذا كانت كل مساهمة محتفظ بها تخلق منطق تعويض متكرر، فقد يبحث المشغّلون عن طرق مختصرة. غالبًا ما تفوز البنية التحتية الخاصة لأن البساطة التشغيلية تتغلب على النقاء المفاهيمي.
ليس ذلك خطرًا صغيرًا.
وأظل أتساءل أيضًا: من يملك السلطة النهائية على النسيان؟
المساهم؟
مشغّل النموذج؟
طبقة التطبيقات؟
منظّم؟
فريق امتثال مؤسسي؟
هؤلاء أصحاب المصلحة لن يتفقوا، خصوصًا عندما يدخل المال في الحديث.
ولهذا بالضبط تبدو هذه القضية مهمة بنيويًا.
لا يزال سوق الذكاء الاصطناعي يتصرف كما لو أن الذكاء هو الأصل النادر. نماذج أفضل، ونماذج أكبر، ومخرجات أذكى.
أصبحت أعتقد بشكل متزايد أن المسؤولية قد تصبح أندر من الذكاء.
ذلك يغيّر ما هي البنية التحتية المهمة.
قد يظل OpenLedger تمامًا كما يعتقد معظم الناس: شبكة مساهمة في الذكاء الاصطناعي مُرمَّزة، مع مسارات للإسناد.
لكن الاحتمال الأكثر إثارة للاهتمام هو أكثر فوضوية.
قد يصبح ذلك بنية تحتية للتفاوض حول ما يُسمح لأنظمة الذكاء الاصطناعي بتذكّره، ومدة احتفاظها به، ومن يحصل على اعتراف اقتصادي بينما تظل تلك الذاكرة حيّة.
ذلك سوق أقل راحة بكثير.
وهذا عادةً يعني أنه يستحق الانتباه.