



تم التنظيم والتجميع بواسطة: Sunny، Shenchao TechFlow
أعلن بروتوكول حوسبة Blockchain AI Gensyn في 12 يونيو أنه أكمل تمويلًا بقيمة 43 مليون دولار من السلسلة A بقيادة a16z.
تتمثل مهمة Gensyn في تزويد المستخدمين بإمكانية الوصول إلى نطاق حوسبة يعادل امتلاك مجموعة حوسبة خاصة، والأهم من ذلك، تحقيق الوصول العادل الذي يتجنب التحكم أو الإغلاق من قبل أي كيان مركزي. وفي الوقت نفسه، Gensyn هو بروتوكول حوسبة لامركزي يركز على تدريب نماذج التعلم الآلي.
إذا نظرنا إلى الوراء في البودكاست الخاص بمؤسسي Gensyn هاري وبن مع Epicenter في نهاية العام الماضي، يمكنك أن تجد أنهم ناقشوا بعمق التحقيق في موارد الحوسبة، بما في ذلك AWS والبنية التحتية المحلية والبنية التحتية السحابية، لفهم كيفية تحسين هذه الموارد واستخدامها دعم تطوير تطبيقات الذكاء الاصطناعي.
وفي الوقت نفسه، ناقشوا أيضًا بتفصيل فلسفة تصميم Gensyn وأهدافها وتموضعها في السوق، بالإضافة إلى مختلف القيود وافتراضات واستراتيجيات التنفيذ التي يواجهونها أثناء عملية التصميم。
يعرض البودكاست الأدوار الأربعة الرئيسية في شبكة Gensyn خارج السلسلة، ويستكشف خصائص شبكة Gensyn على السلسلة، وأهمية توكنات Gensyn والحَوْكمة。
بالإضافة إلى ذلك، شارك Ben وHarry بعض الحقائق الشيّقة عن الذكاء الاصطناعي لتمنح الجميع فهمًا أعمق للمبادئ الأساسية للذكاء الاصطناعي وتطبيقاته。
主持人:Dr. Friederike Ernst,Epicenter 播客
المتحدث الرئيسي: Ben Fielding & Harry Grieve، المؤسسون المشاركون في Gensyn
العنوان الأصلي: (Ben Fielding & Harry Grieve: Gensyn – The Deep Learning Compute Protocol)
تاريخ البث: 24 نوفمبر 2022
سلسلة الكتل كطبقة ثقة لبنية تحتية للذكاء الاصطناعي لامركزية
سأل المضيف Ben وHarry: لماذا دمجوا خبرتهم الغنية في الذكاء الاصطناعي والتعلم العميق مع سلسلة الكتل؟
قال Ben إن قرارهم لم يكن لحظيًا، بل تم بعد فترة زمنية نسبية طويلة. وهدف Gensyn هو بناء بنية تحتية ضخمة للذكاء الاصطناعي. وعندما راقبوا كيفية تحقيق أقصى درجات قابلية التوسع، أدركوا أنهم بحاجة إلى طبقة لا تتطلب الثقة。
إنهم بحاجة إلى أن تكون لديهم القدرة على تجميع قوة الحوسبة دون الاعتماد على موردين جدد مركزيين للانضمام، وإلا فسيواجهون قيود التوسع الإداري. ولحل هذه المشكلة، بدأوا استكشاف أبحاث حوسبة قابلة للتحقق، لكنهم اكتشفوا أنها ما زالت تتطلب دائمًا طرفًا ثالثًا أو قاضيًا موثوقًا للتحقق من الحوسبة。
هذا القيد دفعهم إلى التوجه نحو البلوك تشين. يوفّر البلوك تشين طريقة لكسر الحاجة إلى مُقرِّر واحد أو مُحكِّم واحد، لأنه يتيح تحقيق توافق بين مجموعة كبيرة من الناس。
Harry也分享了 رؤيته، وهو وBen يدعمان بقوة حرية التعبير ويقلقان بشأن نظام الرقابة。
قبل انتقالهم إلى سلسلة الكتل، كانوا يدرسون التعلم الاتحادي (federated learning)، وهو مجال تعلم عميق تقوم فيه بتدريب عدة نماذج على مصادر بيانات موزعة، ثم تجمعها لإنشاء نموذج ميتا يمكنه التعلم من جميع مصادر البيانات. وقد تعاونوا مع البنوك لتنفيذ هذا النهج. لكنهم أدركوا بسرعة أن المشكلة الأكبر هي الحصول على موارد الحوسبة أو المعالجات اللازمة لتدريب تلك النماذج。
لزيادة دمج موارد الحوسبة إلى أقصى حد، يحتاجون إلى أسلوب تنسيق لامركزي، وهنا يأتي دور سلسلة الكتل。
مسح موارد الحوسبة في السوق: AWS، البنية التحتية المحلية والبنية التحتية السحابية
Harry解释了运行AI模型的不同计算资源选择,取决于模型规模。
قد يستخدم الطلاب AWS أو أجهزة محلية، وقد تختار الشركات الناشئة AWS عند الطلب أو خيارات أرخص مُحددة مسبقًا。
لكن مع احتياجات GPU الكبيرة على نطاق واسع، قد تُقيِّد AWS نفسها من حيث التكلفة وقابلية التوسع، وغالبًا ما يتم اختيار إنشاء بنية تحتية داخلية。
تُظهر الأبحاث أن العديد من المؤسسات تحاول توسيع النطاق، بل إن بعضها يختار شراء وحدات GPU وإدارتها بأنفسها. وبشكل عام، يكون شراء وحدات GPU على المدى الطويل أكثر جدوى اقتصاديًا مقارنة بتشغيلها على AWS。
تشمل خيارات موارد الحوسبة للتعلم الآلي الحوسبة السحابية، وتشغيل نماذج الذكاء الاصطناعي محليًا، أو إنشاء مجموعة حوسبة خاصة بهم. تهدف Gensyn إلى توفير وصول بحجم حوسبة يعادل امتلاك عنقود خاص، والأهم هو تحقيق وصول عادل لا يمكن لأي جهة مركزية التحكم فيه أو إغلاقه。
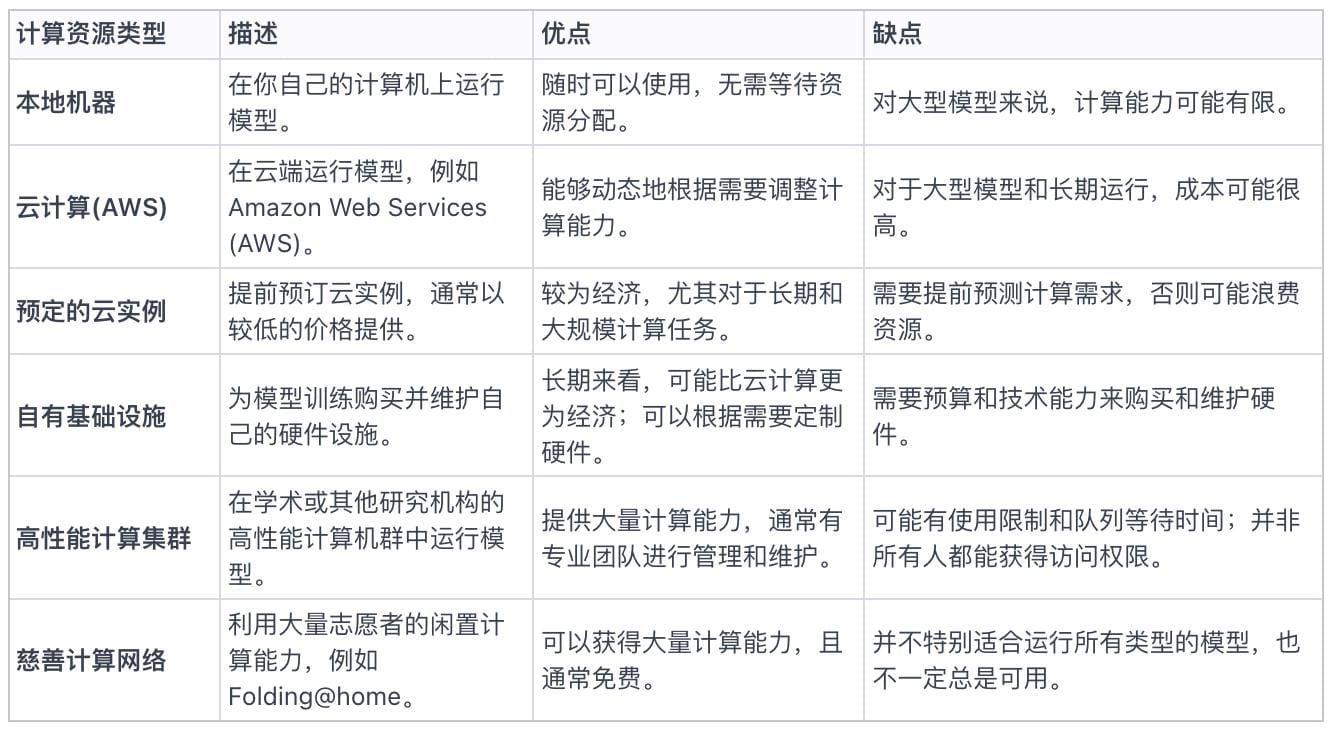
الجدول رقم 1: جميع خيارات موارد الحوسبة المتاحة حاليًا في السوق
对Gensyn设计理念、目标和市场定位的探讨
سأل المضيف: ما الفرق بين Gensyn ومشاريع حوسبة سلاسل كتل سابقة مثل Golem Network؟
Harry解释说,Gensyn的设计理念主要沿着两个轴线进行考虑:
درجة دقة البروتوكول: بخلاف بروتوكولات الحوسبة العامة مثل Golem، فإن Gensyn بروتوكول دقيق يركز على تدريب نماذج التعلم الآلي。
قابلية التحقق للتوسع: غالبًا ما كانت المشاريع المبكرة تعتمد على السمعة أو أنظمة نسخ أقل تسامحًا مع أعطال البيزنطة (Byzantine). وهذا لا يوفر ثقة كافية في نتائج التعلم الآلي. تهدف Gensyn إلى الاستفادة من خبرات بروتوكولات الحوسبة في عالم التشفير وتطبيقها تحديدًا على التعلم الآلي، لتحسين السرعة والتكلفة مع ضمان مستوى مرضٍ من التحقق。
Harry补充说,当考虑网络必须具备的性质时,它需要针对机器学习工程师和研究人员。它需要有验证部分,但关键是在允许任何人参与的方面,它需要既能抵抗审查,又对硬件保持中立。
设计过程中的约束,假设和执行
في عملية تصميم منصة Gensyn، شدد Ben على أهمية مراعاة قيود النظام وافتراضاته. ويتمثل هدفهم في إنشاء شبكة تحول العالم كله إلى كمبيوتر فائق للذكاء الاصطناعي، ولهذا فهم بحاجة إلى إيجاد توازن بين افتراضات المنتج وافتراضات البحث وافتراضات التقنية。
أما سبب بناء Gensyn كسلسلة بلوكشين من الطبقة الأولى الخاصة بها، فيتمثل في الحفاظ على مرونة أكبر وحرية في اتخاذ القرار في مجالات تقنية حاسمة مثل آليات الإجماع. ويريدون القدرة على إثبات صحة بروتوكولهم مستقبلًا، ولا يرغبون بفرض قيود غير ضرورية في المراحل المبكرة للمشروع. علاوة على ذلك، يعتقدون أنه في المستقبل ستتفاعل مختلف السلاسل عبر بروتوكول معلومات واسع القبول، لذلك تتماشى قراراتهم مع هذه الرؤية。
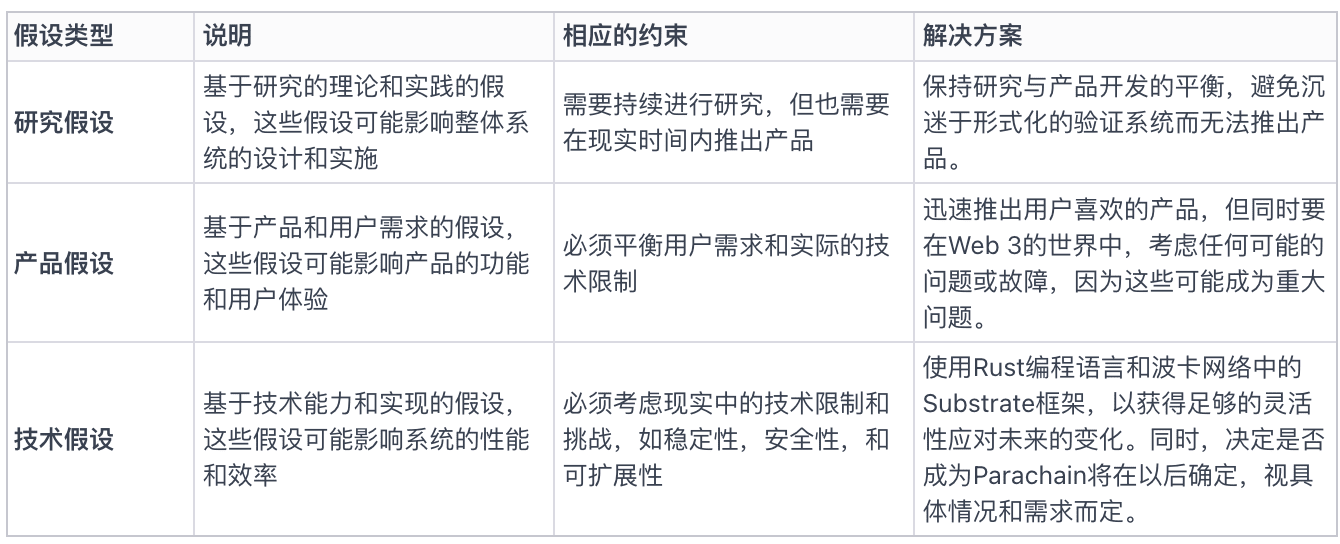
图表二:产品假设、研究假设和技术假设,限制和执行
الأدوار الأربعة الرئيسية في شبكة Gensyn خارج السلسلة
في مناقشة اقتصاد Gensyn، تم تقديم أربعة أدوار رئيسية: المُقدِّم (Submitter)، العامل (Worker)، المُتحقق (Verifier)، والمُبلّغ (Whistleblower). يمكن للمُقدِّم إرسال مختلف المهام إلى شبكة Gensyn، بما في ذلك توليد صور محددة أو تطوير نماذج ذكاء اصطناعي يمكنها قيادة السيارات وغيرها。
提交者 (Submitter)提交任务
شرح Harry كيفية استخدام Gensyn لتدريب النماذج. يعرّف المستخدم أولًا النتيجة المرغوبة، مثل توليد صورة بناءً على تعليمات نصية. بعد ذلك، يبني نموذجًا يأخذ التعليمات النصية كمدخل وينتج الصورة المقابلة. تعد بيانات التدريب أمرًا حاسمًا لتعلم النموذج وتحسينه. بمجرد أن يصبح تصميم النموذج وبيانات التدريب جاهزين، يقوم المستخدم بإرسالها إلى شبكة Gensyn مع معاملات فائقة (hyperparameters) مثل جدولة معدل التعلّم ومدة التدريب. ناتج عملية التدريب هو النموذج المُدرَّب، ويمكن للمستخدم استضافته واستخدامه。
عندما سُئلوا عن كيفية اختيار نماذج غير مدرَّبة، اقترح Harry طريقتين。
النوع الأول يعتمد على مفهوم نماذج الأساس الشائع حاليًا، حيث تقوم الشركات الكبيرة مثل OpenAI أو Midjourney ببناء نموذج أساس، ثم يمكن للمستخدمين إجراء تدريب مُخصّص على هذا النموذج باستخدام بيانات محددة。
الخيار الثاني هو بناء النموذج من الصفر، وهو مختلف عن نهج نماذج الأساس。
في Gensyn، يمكن للمطورين استخدام طرق مماثلة لأساليب التحسين التطوري لتقديم معماريات مختلفة بغرض التدريب والاختبار، ثم تحسينها باستمرار لبناء النموذج المرغوب。
قدّم Ben من وجهة نظرهم رؤى عميقة حول نماذج الأساس، ويعتقد أنها مستقبل المجال。
بوصف Gensyn بروتوكولًا، نأمل أن يتم استخدامه عبر DApps التي تنفذ تقنيات تحسين تطوري أو أساليب مشابهة. يمكن لهذه الـDApps إرسال معماريات فردية إلى بروتوكول Gensyn للتدريب والاختبار، ثم تحسينها عبر التكرار لبناء النموذج المثالي。
هدف Gensyn هو توفير أساس نظيف للحوسبة الخاصة بالتعلم الآلي، وتشجيع تطوير نظام بيئي حوله。
على الرغم من أن النماذج المدربة مسبقًا قد تُدخل انحيازًا، لأن المؤسسات قد تستخدم مجموعات بيانات خاصة أو تخفي معلومات عن عملية التدريب، فإن حل Gensyn يتمثل في تدريب مفتوح للخطوات، وليس إزالة الصندوق الأسود أو الاعتماد على الحتمية الكاملة. ومن خلال التصميم والتدريب الجماعيين على نماذج الأساس، يمكننا إنشاء نموذج عالمي دون الانحياز المرتبط بأي مجموعة بيانات مملوكة لشركة بعينها。
العامل (Solver)
بالنسبة لتوزيع المهام، ترتبط مهمة واحدة بخادم واحد. لكن يمكن تقسيم نموذج واحد إلى مهام متعددة。
تستغل النماذج اللغوية الكبيرة عند تصميمها كامل السعة القصوى من العتاد المتاح آنذاك. ويمكن توسيع هذا المفهوم ليشمل الشبكة، مع مراعاة تجانس/تباين الأجهزة。
بالنسبة لمهام محددة مثل المُتحقِّق أو العامل (الـWorker)، يمكن اختيار استلامها من الميمبول (Mempool). ومن بين الأشخاص الذين يعرضون أنفسهم لاستلام هذه المهمة، يتم اختيار عامل بشكل عشوائي. إذا لم يمكن للنموذج والبيانات أن يتلاءما مع جهاز محدد، لكن مالك الجهاز يدّعي أنه قادر، فقد يتم تغريمه بسبب ازدحام النظام。
يتم تحديد ما إذا كان بإمكان تشغيل مهمة على جهاز واحد بواسطة دالة عشوائية قابلة للتحقق، تقوم باختيار عامل من بين مجموعة العوامل المتاحة。
بالنسبة لمسألة القدرة على التحقق من العامل: إذا لم يدّع العامل أنه يملك قدرة الحوسبة، فلن يتمكن من تنفيذ مهمة الحساب، وهذا سيتم اكتشافه عند تقديم الإثبات。
لكن حجم المهمة يمثل مشكلة. فإذا كانت المهمة كبيرة جدًا، فقد تسبب مشاكل في النظام، مثل هجوم حجب الخدمة (DoS)، حيث يدّعي العامل أنه سيُنجز المهمة لكنه لن ينتهي أبدًا، ما يؤدي إلى إهدار الوقت والموارد。
لذلك فإن تحديد حجم المهمة أمر بالغ الأهمية، ويجب أخذه في الاعتبار إلى جانب عوامل مثل التوازي وتحسين بنية المهام. يعمل الباحثون بنشاط على دراسة واستكشاف أفضل الطرق بناءً على مختلف القيود。
بمجرد إطلاق شبكة الاختبار، سيتم أخذ الظروف الواقعية في الاعتبار أيضًا، ومراقبة أداء النظام في العالم الحقيقي。
إن تحديد حجم المهمة المثالي أمر صعب، وقد جهزت Gensyn نفسها لإجراء تعديلات وتحسينات بناءً على الملاحظات والخبرة من العالم الحقيقي。
在链上进行大规模计算的验证机制和检查点 (Checkpoints)
أظهر Harry وBen أن التحقق من صحة الحسابات مهم جدًا كتحدٍّ، لأن الأمر ليس حتميًا مثل دوال التجزئة (hash)؛ وبالتالي لا يمكن ببساطة استخدام التحقق بالهاش لتحديد ما إذا كانت عملية الحوسبة قد حدثت. ولحل هذه المشكلة، تتمثل الفكرة المثالية في استخدام تطبيقات لإجراء إثباتات المعرفة الصفرية (Zero-Knowledge Proofs) على كامل عملية الحساب. وفي الوقت الحالي، لا تزال Gensyn تعمل على تحقيق هذه القدرة。
目前,Gensyn介绍了使用检查点的混合方法,通过概率机制和检查点来验证机器学习计算。通过结合随机审计方案和梯度空间路径,可以建立一个相对稳健的检查。此外,还引入了零知识证明来增强验证过程,并在模型的全局损失上进行了应用。
验证者(Verifier)和举报者(Whistleblower)
ناقش المضيف وHarry دورين إضافيين في عملية التحقق: المُتحقق (Verifier) والمُبلّغ (whistleblower). وقد شرحا بالتفصيل مسؤوليات كل دور ومكانته。
مهمة المُتحقِّق هي ضمان صحة نقاط التحقق (Checkpoints)، بينما مهمة المُبلّغ هي ضمان دقة قيام المُتحقِّق بمهامه. يعالج المُبلّغ مشكلة معضلة المُتحقِّق، بما يضمن أن عمل المُتحقِّق صحيح وموثوق. يُدخل المُتحقِّق عن قصد أخطاء في عمله، ودور المُبلّغ هو تحديد تلك الأخطاء وإظهارها، وبالتالي ضمان تكامل عملية التحقق.
يتعمد المُتحقق إدخال أخطاء لاختبار يقظة المُبلّغ والتأكد من فعالية النظام. إذا حدثت أخطاء في العمل، فسوف يكتشف المُتحقق الخطأ ويبلغ المُبلّغ. ثم يتم تسجيل الأخطاء لاحقًا على سلسلة الكتل، ويتم التحقق منها على السلسلة. وبشكل دوري، وبمعدل مرتبط بأمان النظام، يقوم المُتحقق عمدًا بإدخال أخطاء للحفاظ على تفاعل المُبلّغ. إذا اكتشف المُبلّغ مشكلة، فإنه سيشارك في لعبة تُسمى "pinpoint protocol"، حيث يمكنه تضييق نطاق الحساب إلى نقطة محددة في شجرة ميركل (Merkle tree) ضمن المنطقة المعينة من الشبكة العصبية. ثم تُقدّم هذه المعلومات للمحكوم/التحكيم على السلسلة. وهذا نموذج مبسط لعملية المُتحقق والمُبلّغ، حيث سيتم تطويرها وبحثها بشكل أكبر بعد انتهاء مرحلة البذور (seed round).
Gensyn链上网络
ناقش Ben وHarry بالتفصيل كيفية عمل بروتوكول التنسيق في Gensyn على السلسلة وتفاصيل التنفيذ. أولًا، ذكروا عملية بناء كتل الشبكة، والتي تتضمن استخدام رموز الرهان (staking tokens) كجزء من شبكة الرهان. ثم شرحوا العلاقة بين هذه المكونات وبروتوكول Gensyn。
وأوضح Ben أن بروتوكول Gensyn هو إلى حد كبير بروتوكول Substrate من نوع vanilla. فهم يستخدمون آلية توافق Grandpa Babe القائمة على إثبات الحصة (Proof of Stake)، حيث يعمل المُتحققون بالطريقة المعتادة. ومع ذلك، فإن كل مكونات التعلم الآلي التي تم تقديمها سابقًا تُجرى خارج السلسلة، وتشمل أطرافًا مشاركة خارج السلسلة تقوم كل منها بمهمته。
تحصل هذه الأطراف على الحوافز عبر الرهان (staking)، ويمكن ذلك عبر لوحة الرهان في Substrate أو عبر إيداع كمية محددة من التوكنات في العقود الذكية. عندما تتم في النهاية مصادقة عملهم، سيحصلون على مكافآت。
Ben和Harry提到的挑战在于确保质押金额、可能的减持金额和奖励金额之间的平衡,以防止出现懒惰或恶意行为的激励。
此外,他们还讨论了增加举报者会带来的复杂性,但由于规模化计算的需求,他们的存在对于确保验证者的诚实性至关重要。虽然他们不断探索通过零知识证明技术可能消除举报者的方法。他们表示,目前的系统与 lite paper 中描述的相符,但他们正在积极努力简化每个方面。
سأل المضيف عما إذا كان لديهم حل لوجود بيانات متاحة، فشرح Henry أنهم أضافوا فوق substrate طبقة تُسمى proof of availability (POA). تستخدم هذه الطبقة تقنيات مثل كشّف/تصحيح الأخطاء (erasure coding) لمعالجة القيود التي تواجههم في سوق طبقات التخزين الواسع. وأشاروا إلى أنهم مهتمون جدًا بالمطورين الذين قاموا بالفعل بتطبيق حلول مماثلة。
Ben补充说,他们的需求不仅仅涉及到存储训练数据,还包括中间证明数据,这些数据不需要长期存储。例如,在他们完成特定数量的区块发布时,可能只需要保留大约20秒。然而,目前他们在Arweave上支付的存储费用是覆盖数百年的范围,对于这些短期需求来说是不必要的。他们正在寻找一种既具备Arweave的保证和功能,又能以更低的成本满足短期存储需求的解决方案。
Gensyn代币和治理
Ben 解释了 gensyn token 在生态系统中的重要性,它在抵押、惩罚、提供奖励和维护共识等方面起着关键作用。它的主要目的是确保系统的财务合理性和完整性。Ben 还提到了谨慎使用通胀率来支付验证者,并利用博弈论机制。
لقد شددوا على الاستخدام التقني البحت لتوكن Gensyn، وقالوا إنهم سيضمنون تقنيًا توقيت إدخال توكن Gensyn والضرورة لذلك。
Harry 表示他们在深度学习社区中属于少数派,特别是 AI 学者对加密货币相关的广泛怀疑之下。尽管如此,他们意识到了加密货币的技术和意识形态方面的价值。
ومع ذلك، عند بدء تشغيل الشبكة، يتوقعون أن يستخدم معظم مستخدمي التعلم العميق العملات الورقية لإجراء التداول، وسيتم التحويل إلى التوكنات بسلاسة في الخلفية。
من ناحية الإمداد، يشارك العمال والمقدمون بنشاط في تداول التوكنات، كما أنهم تلقوا اهتمامًا من عمال مناجم الإيثيريوم، الذين يمتلكون كميات كبيرة من موارد GPU ويسعون لفرص جديدة。
في هذا السياق، من المهم ضمان إزالة خوف العاملين في مجالي التعلم العميق والتعلم الآلي من مصطلحات العملات المشفرة (مثل التوكنات)، وفصل ذلك عن واجهة تجربة المستخدم. وتقول Gensyn إنها حالة استخدام مثيرة تربط عالَمي Web 2 وWeb 3 معًا، لأنها منطقية اقتصاديًا وتمتلك التكنولوجيا المطلوبة لدعم وجودها。
تبسيط/شرح للذكاء الاصطناعي
الذكاء الاصطناعي، التعلم العميق والتعلم الآلي
شارك Ben وجهة نظره حول تطورات مجال الذكاء الاصطناعي في السنوات الأخيرة. ويرى أنه على الرغم من أن قطاع الذكاء الاصطناعي والتعلم الآلي قد شهد سلسلة من الانفجارات الصغيرة خلال السنوات السبع الماضية، فإن التقدم الحالي يبدو أنه يخلق تأثيرًا حقيقيًا وتطبيقات قيمة يمكن أن يتردد صداها لدى جمهور أوسع. يعد التعلم العميق هو القوة الدافعة الأساسية وراء هذه التغيرات. وتُظهر الشبكات العصبية العميقة قدرتها على تقديم معايير تتجاوز الأساليب التقليدية في رؤية الكمبيوتر. علاوة على ذلك، تسرّع نماذج مثل GPT-3 من هذا التقدم。
قام Harry بشرح الفرق بين الذكاء الاصطناعي والتعلم الآلي والتعلم العميق بشكل إضافي. ويرى أن هذه المصطلحات تُستخدم غالبًا بالتبادل، لكنها مختلفة بشكل واضح. وقد شبّه الأمر بأن AI والتعلم الآلي والتعلم العميق مثل دمى التعشيش الروسية: فـ AI هو الطبقة الخارجية。
بشكل عام، يشير مصطلح الذكاء الاصطناعي إلى جعل البرمجة تقوم بالمهام نيابةً عن الآلة。
أما التعلم الآلي، فقد بدأ يكتسب شعبية في تسعينيات القرن الماضي وبدايات العقد الأول من الألفينات. وهو يستخدم البيانات لتحديد احتمالية اتخاذ القرار، بدلًا من الاعتماد على أنظمة خبراء ذات قواعد if-then。
يُبنى التعلم العميق على أساس التعلم الآلي، لكنه يسمح بنماذج أكثر تعقيدًا。
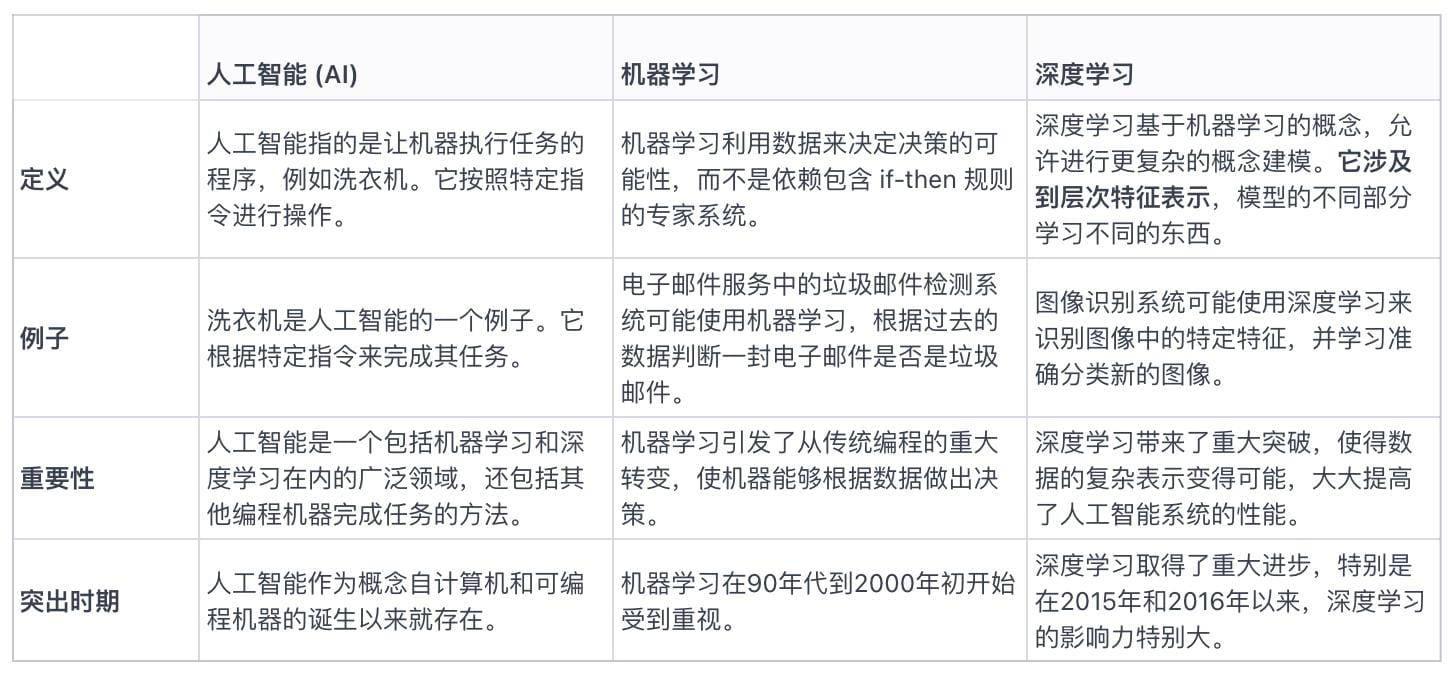
الشكل/الرسم البياني رقم 3: الفرق بين الذكاء الاصطناعي والتعلم الآلي والتعلم العميق
الذكاء الاصطناعي الضيق الاصطناعي، الذكاء العام الاصطناعي، الذكاء الفائق الاصطناعي
في هذا الجزء، ناقش المضيف والضيوف بعمق ثلاثة مجالات رئيسية للذكاء الاصطناعي: الذكاء الاصطناعي الضيق (ANI)، والذكاء العام الاصطناعي (AGI)، والذكاء الفائق الاصطناعي (ASI)。
الذكاء الاصطناعي الضيق الاصطناعي (Artificial Narrow Intelligence, ANI): يتمتع الذكاء الاصطناعي الحالي بدرجة كبيرة بوجوده ضمن هذه المرحلة، حيث تكون الآلة متفوقة جدًا في تنفيذ مهام محددة، مثل اكتشاف نوع معين من السرطان من خلال التعرف على الأنماط في فحوصات طبية。
الذكاء العام الاصطناعي (Artificial General Intelligence, AGI): يشير مصطلح AGI إلى قدرة الآلة على تنفيذ مهام تعتبرها البشر بسيطة نسبيًا، لكنها في أنظمة الحوسبة تمثل تحديًا كبيرًا. فعلى سبيل المثال، أن يتمكّن الجهاز من التنقل بسلاسة في بيئة مزدحمة، مع افتراضات مُدخَلة مُجزَّأة لجميع المدخلات المحيطة، فهذا يعد مثالًا على AGI. يشير AGI إلى أن النموذج أو النظام يمكنه تنفيذ المهام اليومية كما يفعل البشر。
الذكاء الفائق الاصطناعي (Artificial Super Intelligence, ASI): بعد الوصول إلى الذكاء العام الاصطناعي، قد يتطور الجهاز أكثر ليصبح ذكاءً فائقًا. هذا يعني أن الآلة تتجاوز قدرات البشر بفضل تعقيد نماذجها، وزيادة قدراتها الحاسوبية، وعمر غير محدود، وذاكرة مثالية. وغالبًا ما يتم استكشاف هذا المفهوم في أفلام الخيال العلمي والرعب。
كما ذكر الضيفون أن دمج العقل البشري مع الآلات، مثل واجهات الدماغ-الحاسوب، قد يكون طريقًا لتحقيق AGI، لكنه يثير أيضًا سلسلة من القضايا الأخلاقية والآداب。
解开深度学习黑盒:确定性与概率性
وأوضح Ben أن خاصية الصندوق الأسود في نماذج التعلم العميق تُعزى إلى حجمها المطلق. ما زلت تتبع مسارًا عبر سلسلة من نقاط القرار داخل الشبكة. لكن المسار يكون ضخمًا جدًا، ومن الصعب ربط أوزان/معلمات النموذج بالقيم المحددة لها، لأن هذه القيم يتم استخلاصها بعد إدخال ملايين العينات. يمكنك القيام بذلك بدقة: يمكنك تتبع كل تحديث. لكن في النهاية سيكون حجم البيانات التي تنتجها كبيرًا جدًا。
لقد رأى حدوث أمرين:
مع زيادة فهمنا للنماذج التي نبنيها، تختفي جوهرية الصندوق الأسود تدريجيًا. يعد التعلم العميق مجالًا بحثيًا مرّ بمرحلة سريعة ومثيرة، أُجريت فيها تجارب كثيرة لم تكن مدفوعة بالأساس البحثي بقدر ما كانت متمحورة حول معرفة ما الذي يمكن أن نحصل عليه من تلك التجارب. لذلك قمنا بتغذية هذا المجال بكم هائل من البيانات، وتجربة معماريات جديدة، لنرى ما سيحدث، بدلًا من تصميم هذا الشيء انطلاقًا من المبادئ الأساسية مع معرفة دقيقة بكيف يعمل. لذا توجد فترة حماسية حيث كان كل شيء صندوقًا أسود. لكن يعتقد أن هذا النمو السريع بدأ يبطؤ، ونحن نرى الناس يعيدون تقييم تلك المعماريات ويفحصون ويقولون: «لماذا حققت هذه النتيجة أداءً بهذه الطريقة؟ لنغص في الأمر ونجرب أن نبرهن ذلك». لذلك، في نوع من التدرّج، ترفع الستارة。
قد يكون هناك أمر آخر أكثر جدلًا، وهو تحوّل وجهات النظر حول ما إذا كانت أنظمة الحوسبة بحاجة إلى أن تكون حتمية بالكامل، أم أننا يمكننا العيش في عالم احتمالي. نحن كبشر نعيش فعلًا في عالم احتمالي. وقد يكون مثال السيارات ذاتية القيادة أوضح ما يمكن ذكره: عندما نقود سيارة، فإننا نتقبل حدوث أحداث عشوائية، قد تقع بعض الحوادث الصغيرة، وقد تتعطل أنظمة القيادة الذاتية أحيانًا. لكننا لا يمكننا تقبل ذلك، ونقول إن هذه العملية يجب أن تكون حتمية بالكامل. من تحديات صناعة السيارات ذاتية القيادة أنها تفترض أن الناس سيقبلون آليات احتمالية تُطبّق على هذه السيارات، لكن الواقع أن الناس لم يقبلوا. ويرى أن هذا الوضع سيتغير؛ وربما يكون جدليًا—هل سيسمح المجتمع بأن تعيش أنظمة الحوسبة الاحتمالية جنبًا إلى جنب معنا؟ إنه غير متأكد إن كانت هذه الطريق ستنجح، لكنه يعتقد أنها ستحدث。
梯度优化法:深度学习的核心优化方法
梯度优化是深度学习的核心方法之一,它在神经网络训练中起到了关键作用。在神经网络中,一系列层参数实质上就是实数。网络训练涉及的是将这些参数设定为可以让数据正确传递并在网络的最后阶段触发期望输出的实际值。
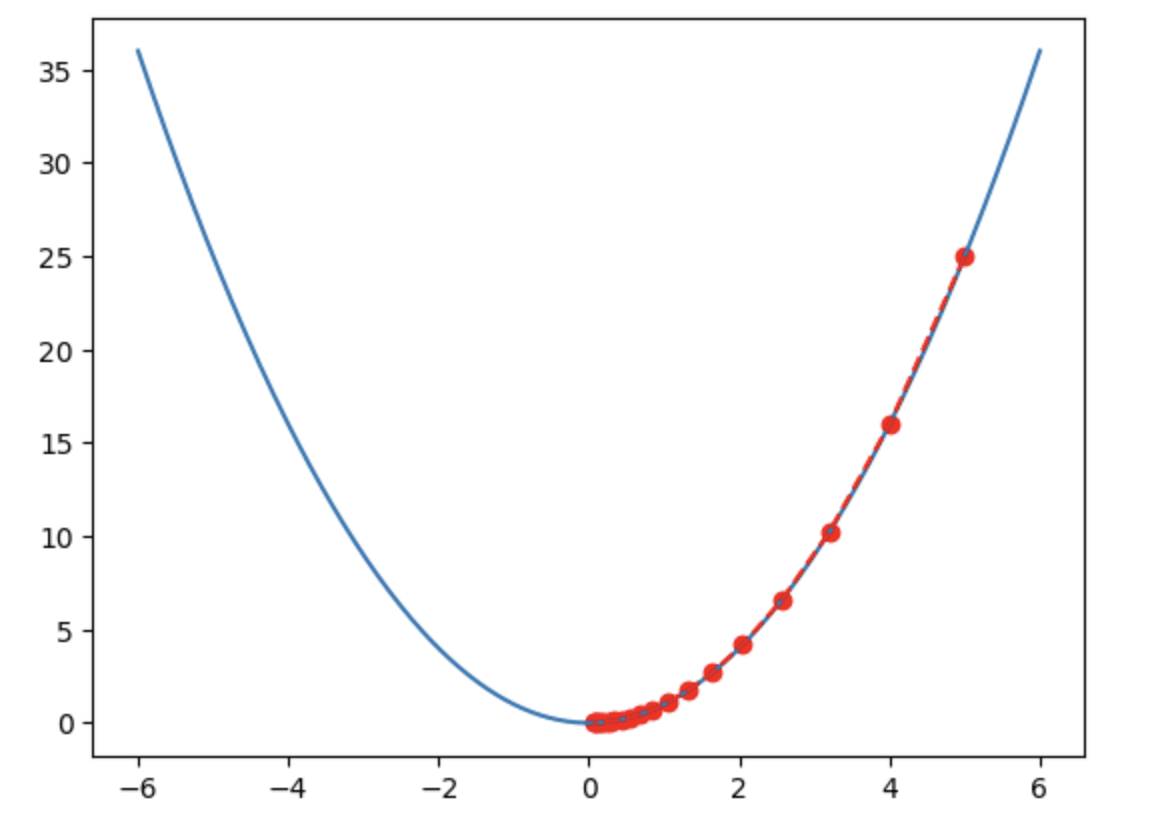
جلبت طرق التحسين المعتمدة على التدرج (gradient-based optimization) تحولًا كبيرًا في مجالات الشبكات العصبية والتعلم العميق. يستخدم هذا النهج التدرج، أي مشتقة معلمات كل طبقة في الشبكة بالنسبة إلى الخطأ. ومن خلال تطبيق قاعدة السلسلة، يمكن عكس انتشار التدرج عبر الشبكة الهرمية بأكملها. وفي هذه العملية، يمكنك تحديد مكانك على سطح الخطأ. يمكن نمذجة الخطأ كسطح في فضاء إقليدي، يبدو كمنطقة مليئة بالارتفاعات والانخفاضات. والهدف من عملية التحسين هو العثور على المنطقة التي تصغر فيها قيمة الخطأ قدر الإمكان。
梯度对于每一层都显示你在这个表面上的位置以及你应该更新参数的方向。你可以利用梯度在这个起伏的表面上导航,找到能够减少误差的方向。步长的大小取决于表面的倾斜程度。如果倾斜得厉害,你就会跳得更远;如果倾斜度不大,你就会跳得更小。本质上,你只是在这个表面上导航,寻找一个凹槽,而梯度可以帮助你确定位置和方向。
这个方法是一个巨大的突破,因为梯度提供了一个清晰的信号和有用的方向,相比于在参数空间中随机跳跃,它能够更有效地指导你知道你在表面的哪个位置,以及你是在山顶上,还是在沟壑中,或者在平坦的区域。
رغم وجود العديد من التقنيات في التعلم العميق التي يمكنها معالجة مشكلة إيجاد الحل الأمثل، فإن واقع العالم الحقيقي يكون غالبًا أكثر تعقيدًا. توجد تقنيات تنظيم (regularization) متعددة تستخدم أثناء تدريب التعلم العميق تجعل الأمر أشبه بالفن أكثر منه علمًا. ولهذا السبب فإن تطبيق التحسين المعتمد على التدرج في الواقع يشبه الفن أكثر من كونه علمًا دقيقًا。
ملخص
تهدف Gensyn إلى بناء أكبر نظام لموارد الحوسبة الخاصة بالتعلم الآلي عالميًا، بحيث يمكنها الاستفادة من الموارد المعطلة أو غير المُستغلة بالكامل، مثل الهواتف الذكية وأجهزة الكمبيوتر الشخصية وغيرها。
在机器学习和区块链的语境下,账本保存的记录通常是计算结果,也就是我们已经通过机器学习处理过的数据状态。这个状态可以是:“这波数据我已经机器学习了,有效,发生时间为X年X月”。这个记录的主要目标是表达结果状态,而不是详述计算过程。
وفي هذا الإطار، تؤدي سلسلة الكتل دورًا مهمًا:
توفر سلسلة الكتل طريقة لتسجيل حالة البيانات والنتائج. يضمن تصميمها صحة البيانات، ويمنع التلاعب والإنكار。
داخل سلسلة الكتل توجد آليات تحفيز اقتصادية يمكنها تنسيق سلوك مختلف الأدوار في شبكة الحوسبة، مثل الأدوار الأربعة المذكورة: المُقدّم، العامل، المُتحقق والمُبلّغ。
من خلال مسحنا لسوق الحوسبة السحابية الحالية، وجدنا أن الحوسبة السحابية ليست بلا قيمة إطلاقًا، بل إن كل نوع من أنواع الحوسبة لديه مشكلاته الخاصة. يمكن للحوسبة اللامركزية عبر سلسلة الكتل أن تلعب دورًا في بعض السيناريوهات، لكنها لا تستطيع استبدال الحوسبة السحابية التقليدية بشكل شامل؛ بمعنى أن سلسلة الكتل ليست حلاً شاملًا لكل شيء。
أخيرًا، يمكن اعتبار الذكاء الاصطناعي شكلاً من أشكال الإنتاجية. ومع ذلك، فإن كيفية تنظيم وتدريب الذكاء الاصطناعي بفعالية تقع ضمن مجال علاقات الإنتاج. ويشمل ذلك التعاون والمجموعات المخصصة من المهام (crowdsourcing) وعوامل الحوافز وغيرها. وفي هذا الصدد، يوفر Web 3.0 عددًا كبيرًا من الحلول والسيناريوهات المحتملة。
因此,我们可以理解为,区块链与AI的结合,特别是在数据和模型的共享、计算资源的协调和结果的验证等方面,为解决AI的训练和使用过程中的一些问题提供了新的可能性。
اقتباس
1. https://docs.gensyn.ai/litepaper/
2. https://a16zcrypto.com/posts/announcement/investing-in-gensyn/