
#depin
depin
3.7M مشاهدات
13,167 يقومون بالنقاش
رائج
جديد
·
--
عرض الترجمة
$GLM DePIN и AI-вычисления: какие перспективы у $GLM ?
Пока розничные трейдеры гоняются за дневным шумом мемкоинов, в секторе децентрализованной вычислительной инфраструктуры (DePIN) постепенно формируется глобальный фундаментальный сдвиг.
Ключевые драйверы роста:
Глобальный дефицит GPU/CPU: Бум нейросетей и ИИ-моделей создал колоссальный дефицит вычислительных мощностей. Децентрализованные сети — это единственная дешёвая и масштабируемая альтернатива централизованным облачным гигантам.
Сигнал институционального спроса: Суточные всплески ставок в Earn (периодически превышающие 40% APR) — четкий маркер того, что крупным игрокам не хватает свободной ликвидности в монете.
Накопление на старшем таймфрейме: На недельном графике монета находится в районе исторической базы ($0.0850–$0.1000). Продавцы выдохлись, а объем предложения на биржах сжат.
Настоящие бычьи циклы зарождаются не на пике всеобщего FOMO, а в фазе длительной тихой консолидации. Сектор DePIN остается одним из главных нарративов предстоящего альтсезона.
Как думаете: DePIN станет главным трендом этого цикла или уступит место другим секторам? 👇
#GLM #DePIN #BinanceSquare #CryptoAnalysis
$GLM DePIN и AI-вычисления: какие перспективы у $GLM ?
Пока розничные трейдеры гоняются за дневным шумом мемкоинов, в секторе децентрализованной вычислительной инфраструктуры (DePIN) постепенно формируется глобальный фундаментальный сдвиг.
Ключевые драйверы роста:
Глобальный дефицит GPU/CPU: Бум нейросетей и ИИ-моделей создал колоссальный дефицит вычислительных мощностей. Децентрализованные сети — это единственная дешёвая и масштабируемая альтернатива централизованным облачным гигантам.
Сигнал институционального спроса: Суточные всплески ставок в Earn (периодически превышающие 40% APR) — четкий маркер того, что крупным игрокам не хватает свободной ликвидности в монете.
Накопление на старшем таймфрейме: На недельном графике монета находится в районе исторической базы ($0.0850–$0.1000). Продавцы выдохлись, а объем предложения на биржах сжат.
Настоящие бычьи циклы зарождаются не на пике всеобщего FOMO, а в фазе длительной тихой консолидации. Сектор DePIN остается одним из главных нарративов предстоящего альтсезона.
Как думаете: DePIN станет главным трендом этого цикла или уступит место другим секторам? 👇
#GLM #DePIN #BinanceSquare #CryptoAnalysis
Пока розничные трейдеры гоняются за дневным шумом мемкоинов, в секторе децентрализованной вычислительной инфраструктуры (DePIN) постепенно формируется глобальный фундаментальный сдвиг.
Ключевые драйверы роста:
Глобальный дефицит GPU/CPU: Бум нейросетей и ИИ-моделей создал колоссальный дефицит вычислительных мощностей. Децентрализованные сети — это единственная дешёвая и масштабируемая альтернатива централизованным облачным гигантам.
Сигнал институционального спроса: Суточные всплески ставок в Earn (периодически превышающие 40% APR) — четкий маркер того, что крупным игрокам не хватает свободной ликвидности в монете.
Накопление на старшем таймфрейме: На недельном графике монета находится в районе исторической базы ($0.0850–$0.1000). Продавцы выдохлись, а объем предложения на биржах сжат.
Настоящие бычьи циклы зарождаются не на пике всеобщего FOMO, а в фазе длительной тихой консолидации. Сектор DePIN остается одним из главных нарративов предстоящего альтсезона.
Как думаете: DePIN станет главным трендом этого цикла или уступит место другим секторам? 👇
#GLM #DePIN #BinanceSquare #CryptoAnalysis
1
31
$CP (CP) قصة البنية التحتية اللامركزية للذكاء الاصطناعي. وافد جديد يخلق ضجة على Binance Alpha. Cluster Protocol (CP) ليس توكنًا ميمّيًا. يركز Cluster Protocol (CP) على البنية التحتية اللامركزية للذكاء الاصطناعي وإثبات الحوسبة. يحاول Cluster Protocol (CP) الجمع بين تقنية البلوك تشين والحوسبة ونماذج الذكاء الاصطناعي. يدفع الذكاء الاصطناعي الطلب على قوة الحوسبة. والسؤال المليون دولار هو: هل يمكن للشبكات اللامركزية أن تستحوذ على جزء من هذا الطلب؟
لدى Cluster Protocol (CP) قيمة سوقية تبلغ 18.15 مليون دولار. يتداول حاليًا 1.376 مليار توكن CP. الحد الأقصى للمعروض هو 5 مليارات توكن CP.
أعلى سعر وصل إليه Cluster Protocol (CP) على الإطلاق كان حوالي 0.199 دولار. وهذا يترك مجالًا كبيرًا لتحقيق مكاسب.. قد تكون الأصول في المراحل المبكرة شديدة التذبذب. فيما يلي سيناريوهات تقييم. عند 0.05 دولار لكل توكن يكون التقييم المخفف حوالي 250 مليون دولار. عند 0.10 دولار لكل توكن يكون 500 مليون دولار. عند 0.20 دولار لكل توكن يكون 1 مليار دولار. عند 0.50 دولار لكل توكن يكون حوالي 2.5 مليار دولار. عند 1.00 دولار لكل توكن يكون 5 مليارات دولار. هذه الأرقام هي سيناريوهات وليست أهدافًا للسعر. للحفاظ على تقييمات مرتفعة يجب أن يمتلك Cluster Protocol (CP) نشاطًا قويًا لدى المطورين، وتطويرًا مفيدًا، واستخدامًا فعّالًا للشبكة، وسيولة جيدة، ونظامًا بيئيًا نشطًا.
أسهل القضايا لمعالجتها واضحة. Cluster Protocol (CP) هو أصل تشفيري في مرحلة مبكرة. الذكاء الاصطناعي اللامركزي مجال تنافسي. إجمالي المعروض من توكنات CP أكبر بكثير من التوكنات التي تتداول حاليًا.. #Binance Alpha لا يعني تلقائيًا إدراجًا مستقبليًا في Binance Spot.
السبب البسيط هو أن الذكاء الاصطناعي يحتاج إلى قوة حوسبة. اللامركزية خيار واحد. يريد Cluster Protocol (CP) أن يفعل كلا الأمرين.. التكنولوجيا وحدها لا تكفي. الاعتماد مهم.
#CP #Cluster #Binance #DePIN
$CP (CP) قصة البنية التحتية اللامركزية للذكاء الاصطناعي. وافد جديد يخلق ضجة على Binance Alpha. Cluster Protocol (CP) ليس توكنًا ميمّيًا. يركز Cluster Protocol (CP) على البنية التحتية اللامركزية للذكاء الاصطناعي وإثبات الحوسبة. يحاول Cluster Protocol (CP) الجمع بين تقنية البلوك تشين والحوسبة ونماذج الذكاء الاصطناعي. يدفع الذكاء الاصطناعي الطلب على قوة الحوسبة. والسؤال المليون دولار هو: هل يمكن للشبكات اللامركزية أن تستحوذ على جزء من هذا الطلب؟
لدى Cluster Protocol (CP) قيمة سوقية تبلغ 18.15 مليون دولار. يتداول حاليًا 1.376 مليار توكن CP. الحد الأقصى للمعروض هو 5 مليارات توكن CP.
أعلى سعر وصل إليه Cluster Protocol (CP) على الإطلاق كان حوالي 0.199 دولار. وهذا يترك مجالًا كبيرًا لتحقيق مكاسب.. قد تكون الأصول في المراحل المبكرة شديدة التذبذب. فيما يلي سيناريوهات تقييم. عند 0.05 دولار لكل توكن يكون التقييم المخفف حوالي 250 مليون دولار. عند 0.10 دولار لكل توكن يكون 500 مليون دولار. عند 0.20 دولار لكل توكن يكون 1 مليار دولار. عند 0.50 دولار لكل توكن يكون حوالي 2.5 مليار دولار. عند 1.00 دولار لكل توكن يكون 5 مليارات دولار. هذه الأرقام هي سيناريوهات وليست أهدافًا للسعر. للحفاظ على تقييمات مرتفعة يجب أن يمتلك Cluster Protocol (CP) نشاطًا قويًا لدى المطورين، وتطويرًا مفيدًا، واستخدامًا فعّالًا للشبكة، وسيولة جيدة، ونظامًا بيئيًا نشطًا.
أسهل القضايا لمعالجتها واضحة. Cluster Protocol (CP) هو أصل تشفيري في مرحلة مبكرة. الذكاء الاصطناعي اللامركزي مجال تنافسي. إجمالي المعروض من توكنات CP أكبر بكثير من التوكنات التي تتداول حاليًا.. #Binance Alpha لا يعني تلقائيًا إدراجًا مستقبليًا في Binance Spot.
السبب البسيط هو أن الذكاء الاصطناعي يحتاج إلى قوة حوسبة. اللامركزية خيار واحد. يريد Cluster Protocol (CP) أن يفعل كلا الأمرين.. التكنولوجيا وحدها لا تكفي. الاعتماد مهم.
#CP #Cluster #Binance #DePIN
لدى Cluster Protocol (CP) قيمة سوقية تبلغ 18.15 مليون دولار. يتداول حاليًا 1.376 مليار توكن CP. الحد الأقصى للمعروض هو 5 مليارات توكن CP.
أعلى سعر وصل إليه Cluster Protocol (CP) على الإطلاق كان حوالي 0.199 دولار. وهذا يترك مجالًا كبيرًا لتحقيق مكاسب.. قد تكون الأصول في المراحل المبكرة شديدة التذبذب. فيما يلي سيناريوهات تقييم. عند 0.05 دولار لكل توكن يكون التقييم المخفف حوالي 250 مليون دولار. عند 0.10 دولار لكل توكن يكون 500 مليون دولار. عند 0.20 دولار لكل توكن يكون 1 مليار دولار. عند 0.50 دولار لكل توكن يكون حوالي 2.5 مليار دولار. عند 1.00 دولار لكل توكن يكون 5 مليارات دولار. هذه الأرقام هي سيناريوهات وليست أهدافًا للسعر. للحفاظ على تقييمات مرتفعة يجب أن يمتلك Cluster Protocol (CP) نشاطًا قويًا لدى المطورين، وتطويرًا مفيدًا، واستخدامًا فعّالًا للشبكة، وسيولة جيدة، ونظامًا بيئيًا نشطًا.
أسهل القضايا لمعالجتها واضحة. Cluster Protocol (CP) هو أصل تشفيري في مرحلة مبكرة. الذكاء الاصطناعي اللامركزي مجال تنافسي. إجمالي المعروض من توكنات CP أكبر بكثير من التوكنات التي تتداول حاليًا.. #Binance Alpha لا يعني تلقائيًا إدراجًا مستقبليًا في Binance Spot.
السبب البسيط هو أن الذكاء الاصطناعي يحتاج إلى قوة حوسبة. اللامركزية خيار واحد. يريد Cluster Protocol (CP) أن يفعل كلا الأمرين.. التكنولوجيا وحدها لا تكفي. الاعتماد مهم.
#CP #Cluster #Binance #DePIN
279
·
--
صاعد
$GLM DePIN و الحوسبة بالذكاء الاصطناعي: ماذا يظهر على الإطار الزمني الأكبر $GLM؟
في حين أن الشريط المحلي مزدحم بالضجيج حول الاهتزازات الدقيقة، تُظهر الرسوم البيانية الأكبر صورة مختلفة تمامًا.
حقائق من الإطار الزمني الأكبر:
القاعدة العالمية: يتم تداول العملة قرب $0.1160، مباشرة عند كتلة القاع التاريخي ($0.0850–$0.1000).
اختبار المتوسطات الرئيسية: اقترب السعر بشدة من 1D EMA 21 ($0.1160)، مع انضغاط تدريجي قبل 1D EMA 50 ($0.1520).
RSI محايد: على الفاصل الأسبوعي، أعاد المؤشر ضبط كل حالة التشبع الشرائي الناتجة عن الاندفاعات السابقة، مُشكّلًا منصة لتراكم طويل الأمد جديد.
انضغاط التقلبات: بعد الهبوط من القمم المحلية، انخفض المعروض في السوق وتقلص الحجم إلى أدنى المستويات.
الحركات الحقيقية في العملات البديلة ذات الأساس القوي (قطاع DePIN/AI) لا تُحضَّر بيوم واحد. التراكم عند القاع — دائمًا عملية هادئة وبطيئة ومتشعبة.
ما رأيكم: هل سنرى خروجًا من هذه القاعدة هذا الخريف أم سيتأخر التراكم؟ 👇
#GLMUSDT #DePIN #BinanceSquareTalks #CryptoAnalysis #Trading #AI
$GLM DePIN و الحوسبة بالذكاء الاصطناعي: ماذا يظهر على الإطار الزمني الأكبر $GLM ؟
في حين أن الشريط المحلي مزدحم بالضجيج حول الاهتزازات الدقيقة، تُظهر الرسوم البيانية الأكبر صورة مختلفة تمامًا.
حقائق من الإطار الزمني الأكبر:
القاعدة العالمية: يتم تداول العملة قرب $0.1160، مباشرة عند كتلة القاع التاريخي ($0.0850–$0.1000).
اختبار المتوسطات الرئيسية: اقترب السعر بشدة من 1D EMA 21 ($0.1160)، مع انضغاط تدريجي قبل 1D EMA 50 ($0.1520).
RSI محايد: على الفاصل الأسبوعي، أعاد المؤشر ضبط كل حالة التشبع الشرائي الناتجة عن الاندفاعات السابقة، مُشكّلًا منصة لتراكم طويل الأمد جديد.
انضغاط التقلبات: بعد الهبوط من القمم المحلية، انخفض المعروض في السوق وتقلص الحجم إلى أدنى المستويات.
الحركات الحقيقية في العملات البديلة ذات الأساس القوي (قطاع DePIN/AI) لا تُحضَّر بيوم واحد. التراكم عند القاع — دائمًا عملية هادئة وبطيئة ومتشعبة.
ما رأيكم: هل سنرى خروجًا من هذه القاعدة هذا الخريف أم سيتأخر التراكم؟ 👇
#GLMUSDT #DePIN #BinanceSquareTalks #CryptoAnalysis #Trading #AI
في حين أن الشريط المحلي مزدحم بالضجيج حول الاهتزازات الدقيقة، تُظهر الرسوم البيانية الأكبر صورة مختلفة تمامًا.
حقائق من الإطار الزمني الأكبر:
القاعدة العالمية: يتم تداول العملة قرب $0.1160، مباشرة عند كتلة القاع التاريخي ($0.0850–$0.1000).
اختبار المتوسطات الرئيسية: اقترب السعر بشدة من 1D EMA 21 ($0.1160)، مع انضغاط تدريجي قبل 1D EMA 50 ($0.1520).
RSI محايد: على الفاصل الأسبوعي، أعاد المؤشر ضبط كل حالة التشبع الشرائي الناتجة عن الاندفاعات السابقة، مُشكّلًا منصة لتراكم طويل الأمد جديد.
انضغاط التقلبات: بعد الهبوط من القمم المحلية، انخفض المعروض في السوق وتقلص الحجم إلى أدنى المستويات.
الحركات الحقيقية في العملات البديلة ذات الأساس القوي (قطاع DePIN/AI) لا تُحضَّر بيوم واحد. التراكم عند القاع — دائمًا عملية هادئة وبطيئة ومتشعبة.
ما رأيكم: هل سنرى خروجًا من هذه القاعدة هذا الخريف أم سيتأخر التراكم؟ 👇
#GLMUSDT #DePIN #BinanceSquareTalks #CryptoAnalysis #Trading #AI
1
134
·
--
سوق العملات المشفرة في تطور مستمر، ويظل المستثمرون الأذكياء دائمًا على أهبة الاستعداد بحثًا عن المشاريع التي ترسّخ التمويل اللامركزي بالمنفعة الواقعية. ومن بين هذه المشاريع التي تبني أساسها بهدوء هو Standard Protocol، ويمثّله الرمز STND. دعونا نتعمق في ما يجعل هذا المشروع مميزًا في المشهد الحالي للسوق.
يضع Standard Protocol نفسه عند تقاطع شبكات البنية التحتية المادية اللامركزية (DePIN) ومعايير بيانات الويب3. كان معروفًا في الأصل بأسلوبه الابتكاري تجاه العملات المستقرة المضمونة وآليات إعادة التوزيع (rebase)، وقد وسّع المشروع رؤيته. والآن يهدف إلى معالجة عنق زجاجة رئيسي في Web3: افتقار البيانات المعيارية والموثوقة وبنية السيولة إلى التوحيد عبر النظم البيئية متعددة السلاسل.
لماذا يكتسب STND زخمًا الآن؟ تكمن الإجابة في التحول السردي الضخم نحو DePIN والأصول الواقعية (RWA). يتحرك المستثمرون بعيدًا عن المضاربة البحتة ويطالبون بمشاريع تمتلك منفعة ملموسة. يوفر Standard Protocol إطارًا للتطبيقات اللامركزية لتأمين أصول البيانات وقابليتها للمشاركة وقيمتها. ومن خلال ذلك، يسهل تنفيذ العمليات بين السلاسل بسلاسة ويقلل من التفتت الذي غالبًا ما يبتلي أسواق DeFi.
من منظور السوق، يمثل STND أصلًا منخفض القيمة السوقية (low-cap) بإمكانات صعودية غير متناظرة وعالية، خصوصًا مع سعي السوق الأوسع إلى الاستثمارات البنيوية ذات التقييم غير المبالغ فيه. يوفّر تكامله مع منظومات كبرى مثل Polkadot وEthereum ممرًا تقنيًا قويًا للاستمرارية. بالإضافة إلى ذلك، تضمن تركيزه على الحوكمة بقيادة المجتمع أن تتكيف الشبكة مباشرة مع احتياجات المستخدمين.
بينما نتجه إلى مرحلة سوق انتقائية للغاية، تستحق بروتوكولات البنية التحتية مثل Standard أن تبقى ضمن قائمة المراقبة. قد لا تلتقط عناوين يومية مثل عملات الميم، لكنها تبني الطرق السريعة التي ستسير عليها دورة الصعود التالية.
ما رأيك في STND؟ هل تمثل DePIN السردية السائدة في هذه الدورة؟ أخبرنا في التعليقات أدناه.
#STND #DePIN #CryptoAnalysis
سوق العملات المشفرة في تطور مستمر، ويظل المستثمرون الأذكياء دائمًا على أهبة الاستعداد بحثًا عن المشاريع التي ترسّخ التمويل اللامركزي بالمنفعة الواقعية. ومن بين هذه المشاريع التي تبني أساسها بهدوء هو Standard Protocol، ويمثّله الرمز STND. دعونا نتعمق في ما يجعل هذا المشروع مميزًا في المشهد الحالي للسوق.
يضع Standard Protocol نفسه عند تقاطع شبكات البنية التحتية المادية اللامركزية (DePIN) ومعايير بيانات الويب3. كان معروفًا في الأصل بأسلوبه الابتكاري تجاه العملات المستقرة المضمونة وآليات إعادة التوزيع (rebase)، وقد وسّع المشروع رؤيته. والآن يهدف إلى معالجة عنق زجاجة رئيسي في Web3: افتقار البيانات المعيارية والموثوقة وبنية السيولة إلى التوحيد عبر النظم البيئية متعددة السلاسل.
لماذا يكتسب STND زخمًا الآن؟ تكمن الإجابة في التحول السردي الضخم نحو DePIN والأصول الواقعية (RWA). يتحرك المستثمرون بعيدًا عن المضاربة البحتة ويطالبون بمشاريع تمتلك منفعة ملموسة. يوفر Standard Protocol إطارًا للتطبيقات اللامركزية لتأمين أصول البيانات وقابليتها للمشاركة وقيمتها. ومن خلال ذلك، يسهل تنفيذ العمليات بين السلاسل بسلاسة ويقلل من التفتت الذي غالبًا ما يبتلي أسواق DeFi.
من منظور السوق، يمثل STND أصلًا منخفض القيمة السوقية (low-cap) بإمكانات صعودية غير متناظرة وعالية، خصوصًا مع سعي السوق الأوسع إلى الاستثمارات البنيوية ذات التقييم غير المبالغ فيه. يوفّر تكامله مع منظومات كبرى مثل Polkadot وEthereum ممرًا تقنيًا قويًا للاستمرارية. بالإضافة إلى ذلك، تضمن تركيزه على الحوكمة بقيادة المجتمع أن تتكيف الشبكة مباشرة مع احتياجات المستخدمين.
بينما نتجه إلى مرحلة سوق انتقائية للغاية، تستحق بروتوكولات البنية التحتية مثل Standard أن تبقى ضمن قائمة المراقبة. قد لا تلتقط عناوين يومية مثل عملات الميم، لكنها تبني الطرق السريعة التي ستسير عليها دورة الصعود التالية.
ما رأيك في STND؟ هل تمثل DePIN السردية السائدة في هذه الدورة؟ أخبرنا في التعليقات أدناه.
#STND #DePIN #CryptoAnalysis
يضع Standard Protocol نفسه عند تقاطع شبكات البنية التحتية المادية اللامركزية (DePIN) ومعايير بيانات الويب3. كان معروفًا في الأصل بأسلوبه الابتكاري تجاه العملات المستقرة المضمونة وآليات إعادة التوزيع (rebase)، وقد وسّع المشروع رؤيته. والآن يهدف إلى معالجة عنق زجاجة رئيسي في Web3: افتقار البيانات المعيارية والموثوقة وبنية السيولة إلى التوحيد عبر النظم البيئية متعددة السلاسل.
لماذا يكتسب STND زخمًا الآن؟ تكمن الإجابة في التحول السردي الضخم نحو DePIN والأصول الواقعية (RWA). يتحرك المستثمرون بعيدًا عن المضاربة البحتة ويطالبون بمشاريع تمتلك منفعة ملموسة. يوفر Standard Protocol إطارًا للتطبيقات اللامركزية لتأمين أصول البيانات وقابليتها للمشاركة وقيمتها. ومن خلال ذلك، يسهل تنفيذ العمليات بين السلاسل بسلاسة ويقلل من التفتت الذي غالبًا ما يبتلي أسواق DeFi.
من منظور السوق، يمثل STND أصلًا منخفض القيمة السوقية (low-cap) بإمكانات صعودية غير متناظرة وعالية، خصوصًا مع سعي السوق الأوسع إلى الاستثمارات البنيوية ذات التقييم غير المبالغ فيه. يوفّر تكامله مع منظومات كبرى مثل Polkadot وEthereum ممرًا تقنيًا قويًا للاستمرارية. بالإضافة إلى ذلك، تضمن تركيزه على الحوكمة بقيادة المجتمع أن تتكيف الشبكة مباشرة مع احتياجات المستخدمين.
بينما نتجه إلى مرحلة سوق انتقائية للغاية، تستحق بروتوكولات البنية التحتية مثل Standard أن تبقى ضمن قائمة المراقبة. قد لا تلتقط عناوين يومية مثل عملات الميم، لكنها تبني الطرق السريعة التي ستسير عليها دورة الصعود التالية.
ما رأيك في STND؟ هل تمثل DePIN السردية السائدة في هذه الدورة؟ أخبرنا في التعليقات أدناه.
#STND #DePIN #CryptoAnalysis
59
·
--
$GLM DePIN و الحوسبة بالذكاء الاصطناعي: لماذا يتجاهل السوق عجز $GLM ؟
بينما يتسابق التجزئة خلف الميمكوينز، يحدث تحول جوهري في البنية التحتية اللامركزية (DePIN).
الحقائق:
اربح أكثر من 40% APR: ارتفاعات يومية متسارعة في العوائد — علامة على أن صناع السوق يفتقرون بشدة إلى السيولة.
الطلب على القدرة: في ظل طفرة الذكاء الاصطناعي، تصبح وحدات GPU/CPU اللامركزية بديلاً أرخص للسحابة.
التقنية: بعد الزخم، لا ينخفض السعر، بل يخفف ضغط RSI عند الـ EMA الرئيسية (50/200).
تتكوّن التحركات الحقيقية بهدوء، بينما تُضغط دفاتر الأسعار قبل الموجة الثانية. وأولئك الذين يثبتون الأرباح وفقاً للنظام ينتظرون بهدوء لحظة الحسم مع النقد.
شارك رأيك: سكون قبل الانطلاقة أم نطاق جانبي؟ 👇
#GLM #DePIN #BinanceSquare #Crypto
$GLM DePIN و الحوسبة بالذكاء الاصطناعي: لماذا يتجاهل السوق عجز $GLM ؟
بينما يتسابق التجزئة خلف الميمكوينز، يحدث تحول جوهري في البنية التحتية اللامركزية (DePIN).
الحقائق:
اربح أكثر من 40% APR: ارتفاعات يومية متسارعة في العوائد — علامة على أن صناع السوق يفتقرون بشدة إلى السيولة.
الطلب على القدرة: في ظل طفرة الذكاء الاصطناعي، تصبح وحدات GPU/CPU اللامركزية بديلاً أرخص للسحابة.
التقنية: بعد الزخم، لا ينخفض السعر، بل يخفف ضغط RSI عند الـ EMA الرئيسية (50/200).
تتكوّن التحركات الحقيقية بهدوء، بينما تُضغط دفاتر الأسعار قبل الموجة الثانية. وأولئك الذين يثبتون الأرباح وفقاً للنظام ينتظرون بهدوء لحظة الحسم مع النقد.
شارك رأيك: سكون قبل الانطلاقة أم نطاق جانبي؟ 👇
#GLM #DePIN #BinanceSquare #Crypto
بينما يتسابق التجزئة خلف الميمكوينز، يحدث تحول جوهري في البنية التحتية اللامركزية (DePIN).
الحقائق:
اربح أكثر من 40% APR: ارتفاعات يومية متسارعة في العوائد — علامة على أن صناع السوق يفتقرون بشدة إلى السيولة.
الطلب على القدرة: في ظل طفرة الذكاء الاصطناعي، تصبح وحدات GPU/CPU اللامركزية بديلاً أرخص للسحابة.
التقنية: بعد الزخم، لا ينخفض السعر، بل يخفف ضغط RSI عند الـ EMA الرئيسية (50/200).
تتكوّن التحركات الحقيقية بهدوء، بينما تُضغط دفاتر الأسعار قبل الموجة الثانية. وأولئك الذين يثبتون الأرباح وفقاً للنظام ينتظرون بهدوء لحظة الحسم مع النقد.
شارك رأيك: سكون قبل الانطلاقة أم نطاق جانبي؟ 👇
#GLM #DePIN #BinanceSquare #Crypto
1
359
·
--
$RENDER
{future}(RENDERUSDT)
يربط RENDER تقنية البلوك تشين بالحوسبة بتقنية وحدات معالجة رسومية (GPU) لا مركزية. تم تصميم الشبكة لتساعد في توفير موارد حوسبة موزعة للأعباء الرقمية المتطلبة.
مع تزايد بروز الذكاء الاصطناعي والحوسبة عالية الأداء كموضوعات تقنية رئيسية، حازت البنية التحتية لوحدات معالجة رسومية لا مركزية اهتمامًا متزايدًا عبر Web3.
#RENDER #AI #DePIN #BinanceSquare
$RENDER
يربط RENDER تقنية البلوك تشين بالحوسبة بتقنية وحدات معالجة رسومية (GPU) لا مركزية. تم تصميم الشبكة لتساعد في توفير موارد حوسبة موزعة للأعباء الرقمية المتطلبة.
مع تزايد بروز الذكاء الاصطناعي والحوسبة عالية الأداء كموضوعات تقنية رئيسية، حازت البنية التحتية لوحدات معالجة رسومية لا مركزية اهتمامًا متزايدًا عبر Web3.
#RENDER #AI #DePIN #BinanceSquare
يربط RENDER تقنية البلوك تشين بالحوسبة بتقنية وحدات معالجة رسومية (GPU) لا مركزية. تم تصميم الشبكة لتساعد في توفير موارد حوسبة موزعة للأعباء الرقمية المتطلبة.
مع تزايد بروز الذكاء الاصطناعي والحوسبة عالية الأداء كموضوعات تقنية رئيسية، حازت البنية التحتية لوحدات معالجة رسومية لا مركزية اهتمامًا متزايدًا عبر Web3.
#RENDER #AI #DePIN #BinanceSquare
65
·
--
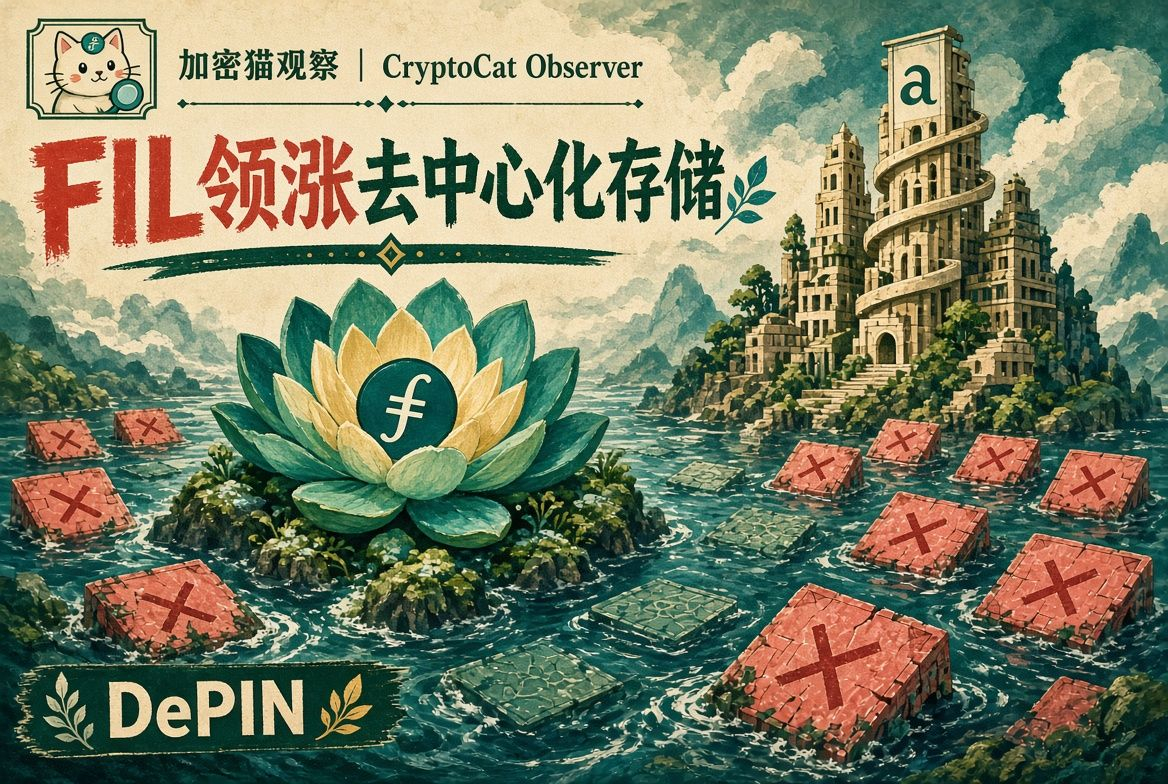
$FIL领涨DePIN،存储板块逆势走强
في 14 سبتمبر، تراجعت أغلب القطاعات في مجال التشفير، بينما استثنيت DePIN وبعض Layer2 بشكل عكسي. سجلت مجموعة DePIN ارتفاعًا خلال 24 ساعة بنحو 3.49%؛ من ضمنها ارتفع $FIL بنحو 21.43%، وارتفع $AR بنحو 9.41%. بلغت القيمة السوقية لقطاع التخزين اللامركزي حوالي 287 مليون دولار أمريكي، مع ارتفاع خلال 24 ساعة بنحو +5.6%. كما تشير نشرة السوق إلى أن $FIL و$AR و$SKL تصدروا الارتفاعات، مع تزايد حجم التداول في $FIL.
وعلى مستوى السردية، يركز السوق على أن تغيّر وتيرة إطلاق الاستحقاق المرتبطة بـ Filecoin بعد 15 أكتوبر قد يؤدي إلى إصدار جديد أو تباطؤ ملحوظ (تشير بعض التحليلات إلى أن سرعة الإصدار قد تنخفض بنحو 75%). كما أن توقعات أرشفة بيانات الذكاء الاصطناعي والتخزين الدائم تدفع الأموال إلى التحول من العملات الرئيسية التي تواجه ضغوطًا إلى مراهنات بيتا على التخزين وDePIN.
يُلاحظ أن بعض الإحصاءات تُظهر أن حجم التداول ما زال أقل من متوسط 30 يومًا، وأن التقلبات على المدى القصير مرتفعة. كما أن تجاوز مستويات مقاومة محورية والثبات فوقها ما يزال يتطلب التحقق من حجم التداول والبيئة الكلية؛ لذا لا يُنصح باعتماد الاستقراء اعتمادًا على ارتفاع يوم واحد فقط.
$FIL $AR
{spot}(FILUSDT)
#DePIN #Filecoin. #去中心化存储
لا يُشكل ذلك نصيحة استثمارية
$FIL 领涨DePIN،存储板块逆势走强
في 14 سبتمبر، تراجعت أغلب القطاعات في مجال التشفير، بينما استثنيت DePIN وبعض Layer2 بشكل عكسي. سجلت مجموعة DePIN ارتفاعًا خلال 24 ساعة بنحو 3.49%؛ من ضمنها ارتفع $FIL بنحو 21.43%، وارتفع $AR بنحو 9.41%. بلغت القيمة السوقية لقطاع التخزين اللامركزي حوالي 287 مليون دولار أمريكي، مع ارتفاع خلال 24 ساعة بنحو +5.6%. كما تشير نشرة السوق إلى أن $FIL و$AR و$SKL تصدروا الارتفاعات، مع تزايد حجم التداول في $FIL .
وعلى مستوى السردية، يركز السوق على أن تغيّر وتيرة إطلاق الاستحقاق المرتبطة بـ Filecoin بعد 15 أكتوبر قد يؤدي إلى إصدار جديد أو تباطؤ ملحوظ (تشير بعض التحليلات إلى أن سرعة الإصدار قد تنخفض بنحو 75%). كما أن توقعات أرشفة بيانات الذكاء الاصطناعي والتخزين الدائم تدفع الأموال إلى التحول من العملات الرئيسية التي تواجه ضغوطًا إلى مراهنات بيتا على التخزين وDePIN.
يُلاحظ أن بعض الإحصاءات تُظهر أن حجم التداول ما زال أقل من متوسط 30 يومًا، وأن التقلبات على المدى القصير مرتفعة. كما أن تجاوز مستويات مقاومة محورية والثبات فوقها ما يزال يتطلب التحقق من حجم التداول والبيئة الكلية؛ لذا لا يُنصح باعتماد الاستقراء اعتمادًا على ارتفاع يوم واحد فقط.
$FIL $AR
#DePIN #Filecoin. #去中心化存储
لا يُشكل ذلك نصيحة استثمارية
في 14 سبتمبر، تراجعت أغلب القطاعات في مجال التشفير، بينما استثنيت DePIN وبعض Layer2 بشكل عكسي. سجلت مجموعة DePIN ارتفاعًا خلال 24 ساعة بنحو 3.49%؛ من ضمنها ارتفع $FIL بنحو 21.43%، وارتفع $AR بنحو 9.41%. بلغت القيمة السوقية لقطاع التخزين اللامركزي حوالي 287 مليون دولار أمريكي، مع ارتفاع خلال 24 ساعة بنحو +5.6%. كما تشير نشرة السوق إلى أن $FIL و$AR و$SKL تصدروا الارتفاعات، مع تزايد حجم التداول في $FIL .
وعلى مستوى السردية، يركز السوق على أن تغيّر وتيرة إطلاق الاستحقاق المرتبطة بـ Filecoin بعد 15 أكتوبر قد يؤدي إلى إصدار جديد أو تباطؤ ملحوظ (تشير بعض التحليلات إلى أن سرعة الإصدار قد تنخفض بنحو 75%). كما أن توقعات أرشفة بيانات الذكاء الاصطناعي والتخزين الدائم تدفع الأموال إلى التحول من العملات الرئيسية التي تواجه ضغوطًا إلى مراهنات بيتا على التخزين وDePIN.
يُلاحظ أن بعض الإحصاءات تُظهر أن حجم التداول ما زال أقل من متوسط 30 يومًا، وأن التقلبات على المدى القصير مرتفعة. كما أن تجاوز مستويات مقاومة محورية والثبات فوقها ما يزال يتطلب التحقق من حجم التداول والبيئة الكلية؛ لذا لا يُنصح باعتماد الاستقراء اعتمادًا على ارتفاع يوم واحد فقط.
$FIL $AR
#DePIN #Filecoin. #去中心化存储
لا يُشكل ذلك نصيحة استثمارية
1
375

{alpha}(560xd955c9ba56fb1ab30e34766e252a97ccce3d31a6)
👀 لماذا لا يتحدث أحد عن $XPIN ؟
تعمل شبكة XPIN على بناء قصة DePIN + AI، وهذا المزيج أصبح أكثر صعوبة في تجاهله. 🔥
لكن إليك السؤال:
هل يمكن لـ XPIN تحويل الضجة إلى تبنٍ حقيقي ومنفعة حقيقية؟ 🤔
أنا أتابع:
🌐 نمو الشبكة
🤖 التكامل مع الذكاء الاصطناعي
📈 نشاط المجتمع
🚀 تطوير النظام البيئي
أنا لا أقول إن $XPIN سيتعرض لضخ.
أنا أقول إن هذا مشروع يستحق المتابعة عن كثب. 👀
هل بحثت عن XPIN بالفعل، أم أنه ما زال خارج نطاق اهتمامك؟
#XPIN #XPINNetwork #DePIN #AImodel #crypto
👀 لماذا لا يتحدث أحد عن $XPIN ؟
تعمل شبكة XPIN على بناء قصة DePIN + AI، وهذا المزيج أصبح أكثر صعوبة في تجاهله. 🔥
لكن إليك السؤال:
هل يمكن لـ XPIN تحويل الضجة إلى تبنٍ حقيقي ومنفعة حقيقية؟ 🤔
أنا أتابع:
🌐 نمو الشبكة
🤖 التكامل مع الذكاء الاصطناعي
📈 نشاط المجتمع
🚀 تطوير النظام البيئي
أنا لا أقول إن $XPIN سيتعرض لضخ.
أنا أقول إن هذا مشروع يستحق المتابعة عن كثب. 👀
هل بحثت عن XPIN بالفعل، أم أنه ما زال خارج نطاق اهتمامك؟
#XPIN #XPINNetwork #DePIN #AImodel #crypto
تعمل شبكة XPIN على بناء قصة DePIN + AI، وهذا المزيج أصبح أكثر صعوبة في تجاهله. 🔥
لكن إليك السؤال:
هل يمكن لـ XPIN تحويل الضجة إلى تبنٍ حقيقي ومنفعة حقيقية؟ 🤔
أنا أتابع:
🌐 نمو الشبكة
🤖 التكامل مع الذكاء الاصطناعي
📈 نشاط المجتمع
🚀 تطوير النظام البيئي
أنا لا أقول إن $XPIN سيتعرض لضخ.
أنا أقول إن هذا مشروع يستحق المتابعة عن كثب. 👀
هل بحثت عن XPIN بالفعل، أم أنه ما زال خارج نطاق اهتمامك؟
#XPIN #XPINNetwork #DePIN #AImodel #crypto
1
277
·
--
مقالة
أين يتم تخزين البيانات التي تُدرِّب الذكاء الاصطناعي؟في كل مرة نتفاعل فيها مع نموذج ذكاء اصطناعي، فإنه يقوم بمعالجة المعلومات وتوليدها ويُنتج غيغابايت من البيانات في الوقت الحقيقي. $بحلول عام 2026، وصلت كتلة البيانات المطلوبة لتدريب النماذج اللغوية الكبيرة والأنظمة التوليدية إلى أحجام هائلة. ومع ذلك، توجد مسألة حاسمة لا يسأل عنها سوى القليل:
أين يتم حفظ كل تلك المعلومات فعليًا ومن يتحكم في هذه البنية التحتية؟
حاليًا، يتمركز الجزء الأكبر بكثير من سعة التخزين والحوسبة في العالم لدى حفنة من عمالقة التكنولوجيا. وإذا ظلت البنية التحتية التي تدعم الذكاء الاصطناعي تحت سيطرة ثلاث أو أربع شركات، فإننا نواجه مخاطر جسيمة تتمثل في انقطاعات واسعة النطاق بسبب أعطال مركزية، ومخاطر الرقابة على المعلومات، وتكاليف توسّع غير مستدامة بالنسبة للمطوّرين المستقلين.
أين يتم تخزين البيانات التي تُدرِّب الذكاء الاصطناعي؟
في كل مرة نتفاعل فيها مع نموذج ذكاء اصطناعي، فإنه يقوم بمعالجة المعلومات وتوليدها ويُنتج غيغابايت من البيانات في الوقت الحقيقي. $بحلول عام 2026، وصلت كتلة البيانات المطلوبة لتدريب النماذج اللغوية الكبيرة والأنظمة التوليدية إلى أحجام هائلة. ومع ذلك، توجد مسألة حاسمة لا يسأل عنها سوى القليل:
أين يتم حفظ كل تلك المعلومات فعليًا ومن يتحكم في هذه البنية التحتية؟
حاليًا، يتمركز الجزء الأكبر بكثير من سعة التخزين والحوسبة في العالم لدى حفنة من عمالقة التكنولوجيا. وإذا ظلت البنية التحتية التي تدعم الذكاء الاصطناعي تحت سيطرة ثلاث أو أربع شركات، فإننا نواجه مخاطر جسيمة تتمثل في انقطاعات واسعة النطاق بسبب أعطال مركزية، ومخاطر الرقابة على المعلومات، وتكاليف توسّع غير مستدامة بالنسبة للمطوّرين المستقلين.
أين يتم حفظ كل تلك المعلومات فعليًا ومن يتحكم في هذه البنية التحتية؟
حاليًا، يتمركز الجزء الأكبر بكثير من سعة التخزين والحوسبة في العالم لدى حفنة من عمالقة التكنولوجيا. وإذا ظلت البنية التحتية التي تدعم الذكاء الاصطناعي تحت سيطرة ثلاث أو أربع شركات، فإننا نواجه مخاطر جسيمة تتمثل في انقطاعات واسعة النطاق بسبب أعطال مركزية، ومخاطر الرقابة على المعلومات، وتكاليف توسّع غير مستدامة بالنسبة للمطوّرين المستقلين.
1
79
·
--
من يدعم الذكاء الاصطناعي من وراء الكواليس؟ @fluence
أمرٌ واحد أراه مثيرًا للاهتمام حول وكلاء الذكاء الاصطناعي هو أن التأخير لا يكون دائمًا سببه النموذج نفسه.
يمكن للوكيل إجراء عدة استدعاءات لأدوات، واسترجاع الحالة، وتشغيل عمليات التحقق، وتحديث الذاكرة، ثم تكرار الحلقة عدة مرات. قد تبدو عدة أجزاء من الملي ثانية من تأخير المعالج في كل خطوة غير مهمة بحد ذاتها، لكن مع مرورها عبر سير العمل كاملًا، يمكن أن تتراكم تلك التأخيرات وتدفع الطلب إلى ما بعد موعده النهائي.
هنا تصبح البنية التحتية أكثر أهمية مما قد يبدو في البداية.
بالنسبة لأحمال عمل الذكاء الاصطناعي، فإن متوسط الأداء ليس دائمًا كافيًا. قد يظهر التحدي الحقيقي عندما يتسبب التنافس على وحدة المعالجة المركزية في تأخيرات صغيرة عبر مراحل كثيرة.
وهذا يجعل تخصيص موارد حسابية مخصصة خيارًا مثيرًا للاهتمام للأحمال التي تهمها إمكانية الحصول على أداء يمكن التنبؤ به.
تعمل Fluence على معالجة هذا من جانب الحوسبة اللامركزية، ما يتيح للمطورين الوصول إلى موارد CPU مخصصة للأحمال التي تحتاج إلى سعة أكثر اتساقًا.
أعتقد أن هذا سيصبح أكثر أهمية مع انتقال وكلاء الذكاء الاصطناعي من التجارب البسيطة إلى بيئات الإنتاج. عندما يتولى الوكيل عشرات الخطوات، فإن تقليل التباين في كل مرحلة يمكن أن يحدث أثرًا أكبر بكثير على تجربة المستخدم النهائية.
السؤال الذي أراقبه بسيط: مع تعقُّد أحمال عمل الوكلاء، هل ستصبح الحوسبة القابلة للتنبؤ بنفس أهمية القدرة الخام على الحوسبة؟
https://fluence.ai/
#Fluence #AI #DePIN
من يدعم الذكاء الاصطناعي من وراء الكواليس؟ @Fluence
أمرٌ واحد أراه مثيرًا للاهتمام حول وكلاء الذكاء الاصطناعي هو أن التأخير لا يكون دائمًا سببه النموذج نفسه.
يمكن للوكيل إجراء عدة استدعاءات لأدوات، واسترجاع الحالة، وتشغيل عمليات التحقق، وتحديث الذاكرة، ثم تكرار الحلقة عدة مرات. قد تبدو عدة أجزاء من الملي ثانية من تأخير المعالج في كل خطوة غير مهمة بحد ذاتها، لكن مع مرورها عبر سير العمل كاملًا، يمكن أن تتراكم تلك التأخيرات وتدفع الطلب إلى ما بعد موعده النهائي.
هنا تصبح البنية التحتية أكثر أهمية مما قد يبدو في البداية.
بالنسبة لأحمال عمل الذكاء الاصطناعي، فإن متوسط الأداء ليس دائمًا كافيًا. قد يظهر التحدي الحقيقي عندما يتسبب التنافس على وحدة المعالجة المركزية في تأخيرات صغيرة عبر مراحل كثيرة.
وهذا يجعل تخصيص موارد حسابية مخصصة خيارًا مثيرًا للاهتمام للأحمال التي تهمها إمكانية الحصول على أداء يمكن التنبؤ به.
تعمل Fluence على معالجة هذا من جانب الحوسبة اللامركزية، ما يتيح للمطورين الوصول إلى موارد CPU مخصصة للأحمال التي تحتاج إلى سعة أكثر اتساقًا.
أعتقد أن هذا سيصبح أكثر أهمية مع انتقال وكلاء الذكاء الاصطناعي من التجارب البسيطة إلى بيئات الإنتاج. عندما يتولى الوكيل عشرات الخطوات، فإن تقليل التباين في كل مرحلة يمكن أن يحدث أثرًا أكبر بكثير على تجربة المستخدم النهائية.
السؤال الذي أراقبه بسيط: مع تعقُّد أحمال عمل الوكلاء، هل ستصبح الحوسبة القابلة للتنبؤ بنفس أهمية القدرة الخام على الحوسبة؟
https://fluence.ai/
#Fluence #AI #DePIN
أمرٌ واحد أراه مثيرًا للاهتمام حول وكلاء الذكاء الاصطناعي هو أن التأخير لا يكون دائمًا سببه النموذج نفسه.
يمكن للوكيل إجراء عدة استدعاءات لأدوات، واسترجاع الحالة، وتشغيل عمليات التحقق، وتحديث الذاكرة، ثم تكرار الحلقة عدة مرات. قد تبدو عدة أجزاء من الملي ثانية من تأخير المعالج في كل خطوة غير مهمة بحد ذاتها، لكن مع مرورها عبر سير العمل كاملًا، يمكن أن تتراكم تلك التأخيرات وتدفع الطلب إلى ما بعد موعده النهائي.
هنا تصبح البنية التحتية أكثر أهمية مما قد يبدو في البداية.
بالنسبة لأحمال عمل الذكاء الاصطناعي، فإن متوسط الأداء ليس دائمًا كافيًا. قد يظهر التحدي الحقيقي عندما يتسبب التنافس على وحدة المعالجة المركزية في تأخيرات صغيرة عبر مراحل كثيرة.
وهذا يجعل تخصيص موارد حسابية مخصصة خيارًا مثيرًا للاهتمام للأحمال التي تهمها إمكانية الحصول على أداء يمكن التنبؤ به.
تعمل Fluence على معالجة هذا من جانب الحوسبة اللامركزية، ما يتيح للمطورين الوصول إلى موارد CPU مخصصة للأحمال التي تحتاج إلى سعة أكثر اتساقًا.
أعتقد أن هذا سيصبح أكثر أهمية مع انتقال وكلاء الذكاء الاصطناعي من التجارب البسيطة إلى بيئات الإنتاج. عندما يتولى الوكيل عشرات الخطوات، فإن تقليل التباين في كل مرحلة يمكن أن يحدث أثرًا أكبر بكثير على تجربة المستخدم النهائية.
السؤال الذي أراقبه بسيط: مع تعقُّد أحمال عمل الوكلاء، هل ستصبح الحوسبة القابلة للتنبؤ بنفس أهمية القدرة الخام على الحوسبة؟
https://fluence.ai/
#Fluence #AI #DePIN
33
·
--
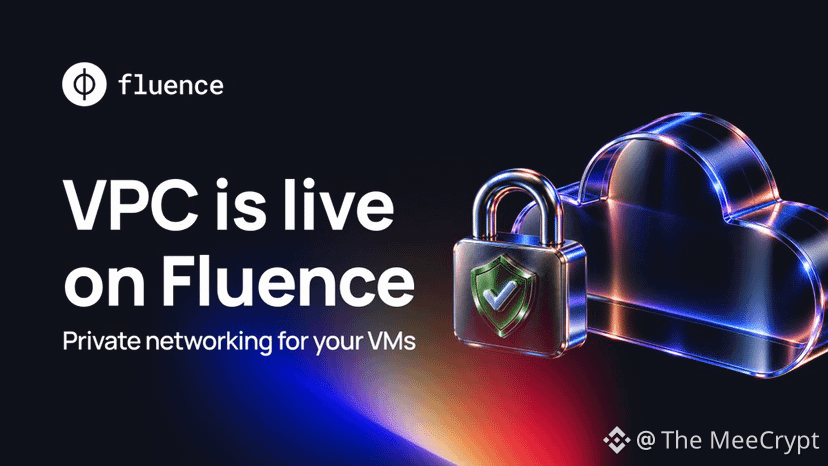
@fluence VPC سيعني الإطلاق المباشر خطوة مهمة في نظام Fluence البيئي.
https://fluence.ai/
تتيح بنية VPC الجديدة للمطوّرين تشغيل عدة أجهزة افتراضية (VMs) مع شبكة خاصة ومجموعات أمان وتحكّم في الخروج (egress) وعناوين IP عامة اختيارية وcloud-init. وبعبارة بسيطة، تجعل Fluence أكثر ملاءمة لتشغيل تطبيقات حقيقية مع عمل خدمات مختلفة معًا بشكل آمن.
ومن منظور $FLT، أرى أن الأمور تصبح مثيرة للاهتمام هنا.
ميزة بنية تحتية جديدة لا تعني تلقائيًا أن سعر FLT سيرتفع. السؤال الأكبر هو ما إذا كانت VPC ستساعد Fluence على جذب المزيد من المطوّرين والأحمال (workloads) والشركات.
إذا زاد التبنّي، فقد يتم نشر المزيد من الحوسبة عبر الشبكة، ما يخلق طلبًا أساسيًا أقوى وربما يحسّن الأساسيات التي تدعم FLT.
لذا أنا أراقب الاستخدام أكثر من الإعلان نفسه. إذا استمرت Fluence في إضافة بنية تحتية عملية وتحولت هذه الميزات إلى نشاط شبكي فعلي، فأعتقد أن ذلك قد يصبح محفزًا إيجابيًا لـ FLT مع مرور الوقت.
بالنسبة لي، الفرضية بسيطة: بنية تحتية أفضل → مزيد من حالات الاستخدام → مزيد من نشاط الشبكة → وربما أساسيات أقوى لـ FLT.
#DePIN #AI #Web3
@Fluence VPC سيعني الإطلاق المباشر خطوة مهمة في نظام Fluence البيئي.
https://fluence.ai/
تتيح بنية VPC الجديدة للمطوّرين تشغيل عدة أجهزة افتراضية (VMs) مع شبكة خاصة ومجموعات أمان وتحكّم في الخروج (egress) وعناوين IP عامة اختيارية وcloud-init. وبعبارة بسيطة، تجعل Fluence أكثر ملاءمة لتشغيل تطبيقات حقيقية مع عمل خدمات مختلفة معًا بشكل آمن.
ومن منظور $FLT، أرى أن الأمور تصبح مثيرة للاهتمام هنا.
ميزة بنية تحتية جديدة لا تعني تلقائيًا أن سعر FLT سيرتفع. السؤال الأكبر هو ما إذا كانت VPC ستساعد Fluence على جذب المزيد من المطوّرين والأحمال (workloads) والشركات.
إذا زاد التبنّي، فقد يتم نشر المزيد من الحوسبة عبر الشبكة، ما يخلق طلبًا أساسيًا أقوى وربما يحسّن الأساسيات التي تدعم FLT.
لذا أنا أراقب الاستخدام أكثر من الإعلان نفسه. إذا استمرت Fluence في إضافة بنية تحتية عملية وتحولت هذه الميزات إلى نشاط شبكي فعلي، فأعتقد أن ذلك قد يصبح محفزًا إيجابيًا لـ FLT مع مرور الوقت.
بالنسبة لي، الفرضية بسيطة: بنية تحتية أفضل → مزيد من حالات الاستخدام → مزيد من نشاط الشبكة → وربما أساسيات أقوى لـ FLT.
#DePIN #AI #Web3
https://fluence.ai/
تتيح بنية VPC الجديدة للمطوّرين تشغيل عدة أجهزة افتراضية (VMs) مع شبكة خاصة ومجموعات أمان وتحكّم في الخروج (egress) وعناوين IP عامة اختيارية وcloud-init. وبعبارة بسيطة، تجعل Fluence أكثر ملاءمة لتشغيل تطبيقات حقيقية مع عمل خدمات مختلفة معًا بشكل آمن.
ومن منظور $FLT، أرى أن الأمور تصبح مثيرة للاهتمام هنا.
ميزة بنية تحتية جديدة لا تعني تلقائيًا أن سعر FLT سيرتفع. السؤال الأكبر هو ما إذا كانت VPC ستساعد Fluence على جذب المزيد من المطوّرين والأحمال (workloads) والشركات.
إذا زاد التبنّي، فقد يتم نشر المزيد من الحوسبة عبر الشبكة، ما يخلق طلبًا أساسيًا أقوى وربما يحسّن الأساسيات التي تدعم FLT.
لذا أنا أراقب الاستخدام أكثر من الإعلان نفسه. إذا استمرت Fluence في إضافة بنية تحتية عملية وتحولت هذه الميزات إلى نشاط شبكي فعلي، فأعتقد أن ذلك قد يصبح محفزًا إيجابيًا لـ FLT مع مرور الوقت.
بالنسبة لي، الفرضية بسيطة: بنية تحتية أفضل → مزيد من حالات الاستخدام → مزيد من نشاط الشبكة → وربما أساسيات أقوى لـ FLT.
#DePIN #AI #Web3
67
·
--
🎯 شبكة أقمار صناعية بقيمة 10 مليارات دولار، سيشتعل حماس DePIN من جديد
📰 Space42 تتعاون مع Viasat لتأسيس Equatys، حيث يساهم كل طرف بـ 400 مليون دولار لبناء منصة اتصالات فضاء-أرض، ثم يتم دعوة طرف ثالث للاستثمار بـ 200 مليون دولار لاحقًا، مع خطط لـ 60 مدارًا و2800 قمر صناعي
💬 مشاركة البنية التحتية هي المثال الحي لـ DePIN. عندما تكون إشارات الأرض غير كافية للوصول إلى البحر أو الصحاري، فهذه بالضبط هي ساحة المعركة الحقيقية التي يمكن لعُقد السلسلة (on-chain) أن تقاسم فيها الكعكة
🏷️ #DePIN #卫星互联网 #Space42 #Viasat #Web3基建
🎯 شبكة أقمار صناعية بقيمة 10 مليارات دولار، سيشتعل حماس DePIN من جديد
📰 Space42 تتعاون مع Viasat لتأسيس Equatys، حيث يساهم كل طرف بـ 400 مليون دولار لبناء منصة اتصالات فضاء-أرض، ثم يتم دعوة طرف ثالث للاستثمار بـ 200 مليون دولار لاحقًا، مع خطط لـ 60 مدارًا و2800 قمر صناعي
💬 مشاركة البنية التحتية هي المثال الحي لـ DePIN. عندما تكون إشارات الأرض غير كافية للوصول إلى البحر أو الصحاري، فهذه بالضبط هي ساحة المعركة الحقيقية التي يمكن لعُقد السلسلة (on-chain) أن تقاسم فيها الكعكة
🏷️ #DePIN #卫星互联网 #Space42 #Viasat #Web3基建
📰 Space42 تتعاون مع Viasat لتأسيس Equatys، حيث يساهم كل طرف بـ 400 مليون دولار لبناء منصة اتصالات فضاء-أرض، ثم يتم دعوة طرف ثالث للاستثمار بـ 200 مليون دولار لاحقًا، مع خطط لـ 60 مدارًا و2800 قمر صناعي
💬 مشاركة البنية التحتية هي المثال الحي لـ DePIN. عندما تكون إشارات الأرض غير كافية للوصول إلى البحر أو الصحاري، فهذه بالضبط هي ساحة المعركة الحقيقية التي يمكن لعُقد السلسلة (on-chain) أن تقاسم فيها الكعكة
🏷️ #DePIN #卫星互联网 #Space42 #Viasat #Web3基建
5

·
--
تمت الإضافة للتو $FIL حوالي 0.812 دولار. أنا أتابع هذا المستوى لأن سرد شبكة Filecoin الخاصة بالتخزين اللامركزي لا يزال ذا صلة قوية، مع استمرار نمو الطلب على البنية التحتية للبيانات.
ما يثير اهتمامي أكثر هو دور الشبكة في تخزين البيانات واسترجاعها عبر سوق لا مركزي، مع تزايد التقاطع بين التخزين وWeb3 وبنية تحتية للذكاء الاصطناعي.
إذا بدأ المشترون في الدخول بحجم تداول أقوى، فقد يكون لدى FIL مجال لحركة تعافٍ قوية.
TP: 0.92–1.05
#fil #Filecoin #DecentralizedStorage #DePIN
$FIL
{future}(FILUSDT)
تمت الإضافة للتو $FIL حوالي 0.812 دولار. أنا أتابع هذا المستوى لأن سرد شبكة Filecoin الخاصة بالتخزين اللامركزي لا يزال ذا صلة قوية، مع استمرار نمو الطلب على البنية التحتية للبيانات.
ما يثير اهتمامي أكثر هو دور الشبكة في تخزين البيانات واسترجاعها عبر سوق لا مركزي، مع تزايد التقاطع بين التخزين وWeb3 وبنية تحتية للذكاء الاصطناعي.
إذا بدأ المشترون في الدخول بحجم تداول أقوى، فقد يكون لدى FIL مجال لحركة تعافٍ قوية.
TP: 0.92–1.05
#fil #Filecoin #DecentralizedStorage #DePIN
$FIL
ما يثير اهتمامي أكثر هو دور الشبكة في تخزين البيانات واسترجاعها عبر سوق لا مركزي، مع تزايد التقاطع بين التخزين وWeb3 وبنية تحتية للذكاء الاصطناعي.
إذا بدأ المشترون في الدخول بحجم تداول أقوى، فقد يكون لدى FIL مجال لحركة تعافٍ قوية.
TP: 0.92–1.05
#fil #Filecoin #DecentralizedStorage #DePIN
$FIL
3
214
#opticalcommsstocksrallyover3%
عصب ثورة الذكاء الاصطناعي ليس مجرد السيليكون—بل الزجاج. 🌐
ارتفعت أسهم الاتصالات الضوئية مثل Corning وCoherent وCiena مؤخرًا بأكثر من 3%، ما يشير إلى تحول كبير في قطاع البنية التحتية. يُعزى هذا الارتفاع إلى موجة ضخمة من استثمارات مراكز بيانات الذكاء الاصطناعي وتحديثات توقعات مؤسساتية حديثة لوحدات الاتصالات البصرية عالية السرعة. للتعامل مع أحمال حوسبة الذكاء الاصطناعي الهائلة، تحتاج الشبكات إلى نطاق ترددي لا يمكن أن توفره إلا الألياف.
بالنسبة لسوق العملات المشفرة، فإن هذا الارتفاع التقليدي في العتاد يؤكد أطروحة محورية: طبقة البنية التحتية المادية بالغة الأهمية. فهي تعكس مباشرة الزخم الذي نتابعه في DePIN (الشبكات اللامركزية للبنية التحتية المادية)، إذ يتسابق قطاعا Web2 وWeb3 على وضع الأسس العتادية للذكاء الاصطناعي اللامركزي.
كيف تموضع نفسك للاستفادة من طفرة البنية التحتية للذكاء الاصطناعي؟
👇 أخبرني عبر التصويت أدناه!
#DePIN #AIInfrastructure #CryptoMacro
$NEAR
{future}(NEARUSDT)
$TAO
{future}(TAOUSDT)
$RENDER
{future}(RENDERUSDT)
#opticalcommsstocksrallyover3%
عصب ثورة الذكاء الاصطناعي ليس مجرد السيليكون—بل الزجاج. 🌐
ارتفعت أسهم الاتصالات الضوئية مثل Corning وCoherent وCiena مؤخرًا بأكثر من 3%، ما يشير إلى تحول كبير في قطاع البنية التحتية. يُعزى هذا الارتفاع إلى موجة ضخمة من استثمارات مراكز بيانات الذكاء الاصطناعي وتحديثات توقعات مؤسساتية حديثة لوحدات الاتصالات البصرية عالية السرعة. للتعامل مع أحمال حوسبة الذكاء الاصطناعي الهائلة، تحتاج الشبكات إلى نطاق ترددي لا يمكن أن توفره إلا الألياف.
بالنسبة لسوق العملات المشفرة، فإن هذا الارتفاع التقليدي في العتاد يؤكد أطروحة محورية: طبقة البنية التحتية المادية بالغة الأهمية. فهي تعكس مباشرة الزخم الذي نتابعه في DePIN (الشبكات اللامركزية للبنية التحتية المادية)، إذ يتسابق قطاعا Web2 وWeb3 على وضع الأسس العتادية للذكاء الاصطناعي اللامركزي.
كيف تموضع نفسك للاستفادة من طفرة البنية التحتية للذكاء الاصطناعي؟
👇 أخبرني عبر التصويت أدناه!
#DePIN #AIInfrastructure #CryptoMacro
$NEAR
$TAO
$RENDER
عصب ثورة الذكاء الاصطناعي ليس مجرد السيليكون—بل الزجاج. 🌐
ارتفعت أسهم الاتصالات الضوئية مثل Corning وCoherent وCiena مؤخرًا بأكثر من 3%، ما يشير إلى تحول كبير في قطاع البنية التحتية. يُعزى هذا الارتفاع إلى موجة ضخمة من استثمارات مراكز بيانات الذكاء الاصطناعي وتحديثات توقعات مؤسساتية حديثة لوحدات الاتصالات البصرية عالية السرعة. للتعامل مع أحمال حوسبة الذكاء الاصطناعي الهائلة، تحتاج الشبكات إلى نطاق ترددي لا يمكن أن توفره إلا الألياف.
بالنسبة لسوق العملات المشفرة، فإن هذا الارتفاع التقليدي في العتاد يؤكد أطروحة محورية: طبقة البنية التحتية المادية بالغة الأهمية. فهي تعكس مباشرة الزخم الذي نتابعه في DePIN (الشبكات اللامركزية للبنية التحتية المادية)، إذ يتسابق قطاعا Web2 وWeb3 على وضع الأسس العتادية للذكاء الاصطناعي اللامركزي.
كيف تموضع نفسك للاستفادة من طفرة البنية التحتية للذكاء الاصطناعي؟
👇 أخبرني عبر التصويت أدناه!
#DePIN #AIInfrastructure #CryptoMacro
$NEAR
$TAO
$RENDER

246
·
--
في المشهد المتطور للبنية التحتية المادية اللامركزية، ما تزال الشبكات التي تنسق الموارد في العالم الحقيقي تُظهر فائدة ملموسة تتجاوز السرد. إذما تتولى الحساسات وعرض النطاق والحوسبة تنسيقًا على السلسلة، يبدأ رأس المال في الاعتراف بقيمة تتجسد على أرض الواقع. وإذ يتردد صدى موجات البنية التحتية لعام 2021 التي كافأت التنفيذ العملي، يحمل هذا الفصل احتمالًا بنسبة 64% بنموٍ مستقر خلال الموسم إذا استمرت مؤشرات التبنّي وتكاملات الشراكات في التضاعف.
$FIL $RENDER #RadaRI106 #CoinVahini #DePIN #Infrastructure
في المشهد المتطور للبنية التحتية المادية اللامركزية، ما تزال الشبكات التي تنسق الموارد في العالم الحقيقي تُظهر فائدة ملموسة تتجاوز السرد. إذما تتولى الحساسات وعرض النطاق والحوسبة تنسيقًا على السلسلة، يبدأ رأس المال في الاعتراف بقيمة تتجسد على أرض الواقع. وإذ يتردد صدى موجات البنية التحتية لعام 2021 التي كافأت التنفيذ العملي، يحمل هذا الفصل احتمالًا بنسبة 64% بنموٍ مستقر خلال الموسم إذا استمرت مؤشرات التبنّي وتكاملات الشراكات في التضاعف.
$FIL $RENDER #RadaRI106 #CoinVahini #DePIN #Infrastructure
$FIL $RENDER #RadaRI106 #CoinVahini #DePIN #Infrastructure
1
378

·
--
عندما تكون السوق مزدحمة بالحركة، أتمنى في المقابل أن أتحدث عن مشروع من مسار قديم شبه غير مطروح للنقاش.
يعمل $STORJ في مجال التخزين السحابي اللامركزي: تُشفَّر الملفات، ثم تُقسَّم إلى شرائح وتنتشر عبر عقد حول العالم. جوهر الفكرة هو تحويل سعة القرص ومساحة التخزين غير المستخدمة إلى قيمة اقتصادية، وهو ضمن فئة DePIN ومن أوائل المشاركين في قطاع التخزين.
هناك عدة بيانات تستحق الانتباه: السعر الحالي يقارب 0.067 دولار، والقيمة السوقية أقل من 29 مليون دولار، بينما تبلغ قيمة التداول خلال 24 ساعة نحو 18 مليون دولار. معدل الدوران ليس منخفضًا، ما يشير إلى أن السيولة والتداولات ما زالت تتحرك، وأن المشروع ليس منسيًا بالكامل؛ لكن من الواضح أن حماس السرد/الخطاب التسويقي قد تراجع بشكل ملحوظ.
يُعد التخزين اتجاهًا من بين القلائل في عالم التشفير التي لديها احتياج حقيقي—فكمية البيانات تنمو على المدى الطويل، وتكاليف خدمات السحابة المركزية تبقى مرتفعة، والمنطق ظل صحيحًا دائمًا. لكن الواقع هو أن المنافسة في هذا المسار شديدة، مع ضغط كبير من قبل الشركات الرائدة. تسعى Storj إلى إعادة تسعير نفسها، وفي النهاية لا بد أن يعتمد ذلك على نمو حجم التخزين، وعدد العملاء المدفوعين، والإيرادات الفعلية—وليس مجرد تكرار القصة القديمة مرة أخرى.
تعني القيمة السوقية الصغيرة وجود مرونة، لكنها تعني أيضًا وجود مخاطر. ففي مرحلة لا يناقش فيها أحد تقريبًا، يكون الأنسب إدراج المشروع ضمن قائمة المراقبة وتتبع صبرًا، بدلًا من التسرع في اتخاذ قرار شراء/بيع. الانتظار حتى تظهر إشارات قوية من الأساسيات أو حتى تؤكد المؤشرات/تبدلات القطاعات (دوران رؤوس الأموال بين القطاعات)، ليس متأخرًا أبدًا.
#DePIN #去中心化存储 #Storj
عندما تكون السوق مزدحمة بالحركة، أتمنى في المقابل أن أتحدث عن مشروع من مسار قديم شبه غير مطروح للنقاش.
يعمل $STORJ في مجال التخزين السحابي اللامركزي: تُشفَّر الملفات، ثم تُقسَّم إلى شرائح وتنتشر عبر عقد حول العالم. جوهر الفكرة هو تحويل سعة القرص ومساحة التخزين غير المستخدمة إلى قيمة اقتصادية، وهو ضمن فئة DePIN ومن أوائل المشاركين في قطاع التخزين.
هناك عدة بيانات تستحق الانتباه: السعر الحالي يقارب 0.067 دولار، والقيمة السوقية أقل من 29 مليون دولار، بينما تبلغ قيمة التداول خلال 24 ساعة نحو 18 مليون دولار. معدل الدوران ليس منخفضًا، ما يشير إلى أن السيولة والتداولات ما زالت تتحرك، وأن المشروع ليس منسيًا بالكامل؛ لكن من الواضح أن حماس السرد/الخطاب التسويقي قد تراجع بشكل ملحوظ.
يُعد التخزين اتجاهًا من بين القلائل في عالم التشفير التي لديها احتياج حقيقي—فكمية البيانات تنمو على المدى الطويل، وتكاليف خدمات السحابة المركزية تبقى مرتفعة، والمنطق ظل صحيحًا دائمًا. لكن الواقع هو أن المنافسة في هذا المسار شديدة، مع ضغط كبير من قبل الشركات الرائدة. تسعى Storj إلى إعادة تسعير نفسها، وفي النهاية لا بد أن يعتمد ذلك على نمو حجم التخزين، وعدد العملاء المدفوعين، والإيرادات الفعلية—وليس مجرد تكرار القصة القديمة مرة أخرى.
تعني القيمة السوقية الصغيرة وجود مرونة، لكنها تعني أيضًا وجود مخاطر. ففي مرحلة لا يناقش فيها أحد تقريبًا، يكون الأنسب إدراج المشروع ضمن قائمة المراقبة وتتبع صبرًا، بدلًا من التسرع في اتخاذ قرار شراء/بيع. الانتظار حتى تظهر إشارات قوية من الأساسيات أو حتى تؤكد المؤشرات/تبدلات القطاعات (دوران رؤوس الأموال بين القطاعات)، ليس متأخرًا أبدًا.
#DePIN #去中心化存储 #Storj
يعمل $STORJ في مجال التخزين السحابي اللامركزي: تُشفَّر الملفات، ثم تُقسَّم إلى شرائح وتنتشر عبر عقد حول العالم. جوهر الفكرة هو تحويل سعة القرص ومساحة التخزين غير المستخدمة إلى قيمة اقتصادية، وهو ضمن فئة DePIN ومن أوائل المشاركين في قطاع التخزين.
هناك عدة بيانات تستحق الانتباه: السعر الحالي يقارب 0.067 دولار، والقيمة السوقية أقل من 29 مليون دولار، بينما تبلغ قيمة التداول خلال 24 ساعة نحو 18 مليون دولار. معدل الدوران ليس منخفضًا، ما يشير إلى أن السيولة والتداولات ما زالت تتحرك، وأن المشروع ليس منسيًا بالكامل؛ لكن من الواضح أن حماس السرد/الخطاب التسويقي قد تراجع بشكل ملحوظ.
يُعد التخزين اتجاهًا من بين القلائل في عالم التشفير التي لديها احتياج حقيقي—فكمية البيانات تنمو على المدى الطويل، وتكاليف خدمات السحابة المركزية تبقى مرتفعة، والمنطق ظل صحيحًا دائمًا. لكن الواقع هو أن المنافسة في هذا المسار شديدة، مع ضغط كبير من قبل الشركات الرائدة. تسعى Storj إلى إعادة تسعير نفسها، وفي النهاية لا بد أن يعتمد ذلك على نمو حجم التخزين، وعدد العملاء المدفوعين، والإيرادات الفعلية—وليس مجرد تكرار القصة القديمة مرة أخرى.
تعني القيمة السوقية الصغيرة وجود مرونة، لكنها تعني أيضًا وجود مخاطر. ففي مرحلة لا يناقش فيها أحد تقريبًا، يكون الأنسب إدراج المشروع ضمن قائمة المراقبة وتتبع صبرًا، بدلًا من التسرع في اتخاذ قرار شراء/بيع. الانتظار حتى تظهر إشارات قوية من الأساسيات أو حتى تؤكد المؤشرات/تبدلات القطاعات (دوران رؤوس الأموال بين القطاعات)، ليس متأخرًا أبدًا.
#DePIN #去中心化存储 #Storj
58
·
--
صاعد
🟧👉 الإفصاح: هذا المنشور ( ✍️ نص + 🖼️ صور ) مُولَّد بالذكاء الاصطناعي.
🚀 يتصاعد نشاط نظام البث اللامركزي مع نشاط حقيقي على الشبكة 🔥.
1️⃣ يتوسع بسرعة الطلب على غاز السلسلة (on-chain) مع $TFUEL powers لتوصيل الفيديو والعقود الذكية ⚡.
2️⃣ تستمر عقد الحافة التابعة للمؤسسات في معالجة نطاق ترددي موزّع هائل بينما تحرق $TFUEL 🌐.
3️⃣ يلاحظ مراقبو السوق مناطق تجميع تتشكل عبر دفاتر أوامر البورصات لـ $TFUEL 📈.
{spot}(TFUELUSDT)
#TFUEL #Crypto #Altcoins #Binance #DePIN .
🟥👉 تذكير: ليس 🚫 نصيحة مالية (NFA)، من فضلك 🙏 قم بإجراء بحثك الخاص (DYOR).
🟧👉 الإفصاح: هذا المنشور ( ✍️ نص + 🖼️ صور ) مُولَّد بالذكاء الاصطناعي.
🚀 يتصاعد نشاط نظام البث اللامركزي مع نشاط حقيقي على الشبكة 🔥.
1️⃣ يتوسع بسرعة الطلب على غاز السلسلة (on-chain) مع $TFUEL powers لتوصيل الفيديو والعقود الذكية ⚡.
2️⃣ تستمر عقد الحافة التابعة للمؤسسات في معالجة نطاق ترددي موزّع هائل بينما تحرق $TFUEL 🌐.
3️⃣ يلاحظ مراقبو السوق مناطق تجميع تتشكل عبر دفاتر أوامر البورصات لـ $TFUEL 📈.
#TFUEL #Crypto #Altcoins #Binance #DePIN .
🟥👉 تذكير: ليس 🚫 نصيحة مالية (NFA)، من فضلك 🙏 قم بإجراء بحثك الخاص (DYOR).
🚀 يتصاعد نشاط نظام البث اللامركزي مع نشاط حقيقي على الشبكة 🔥.
1️⃣ يتوسع بسرعة الطلب على غاز السلسلة (on-chain) مع $TFUEL powers لتوصيل الفيديو والعقود الذكية ⚡.
2️⃣ تستمر عقد الحافة التابعة للمؤسسات في معالجة نطاق ترددي موزّع هائل بينما تحرق $TFUEL 🌐.
3️⃣ يلاحظ مراقبو السوق مناطق تجميع تتشكل عبر دفاتر أوامر البورصات لـ $TFUEL 📈.
#TFUEL #Crypto #Altcoins #Binance #DePIN .
🟥👉 تذكير: ليس 🚫 نصيحة مالية (NFA)، من فضلك 🙏 قم بإجراء بحثك الخاص (DYOR).

23
·
--
هل ستقود شبكات البنية التحتية المادية اللامركزية (DePIN) دورة الازدهار (Bull Run) القادمة في عالم العملات المشفرة؟ 🌐⚡
مع تطور تقنية البلوك تشين بما يتجاوز التطبيقات المالية البحتة، تبرز DePIN بسرعة كأحد أكثر القطاعات الواعدة في Web3. لكن ما الذي يجعل DePIN قادرة على إحداث نقلة نوعية لاعتمادها السائد؟
تستفيد DePIN من الحوافز القائمة على الرموز لبناء وصيانة البنية التحتية المادية الواقعية—من شبكات لاسلكية لامركزية ومجموعات الحوسبة إلى شبكات الطاقة الشمسية وحلول التخزين. ومن خلال تحويل مساهمة الأجهزة إلى رموز، فإنها تُقلّل تكاليف رأس المال وتُزعزع هيمنة الشركات العملاقة المركزية التقليدية.
ومن خلال الربط بين الرموز الرقمية والمنفعة الواقعية، توفر DePIN قيمة اقتصادية ملموسة تمتد بعيداً عن مجرد التداول المضاربي.
$RNDR $FIL #DePIN #Web3 #CryptoInnovation #CoinVahini
هل ستقود شبكات البنية التحتية المادية اللامركزية (DePIN) دورة الازدهار (Bull Run) القادمة في عالم العملات المشفرة؟ 🌐⚡
مع تطور تقنية البلوك تشين بما يتجاوز التطبيقات المالية البحتة، تبرز DePIN بسرعة كأحد أكثر القطاعات الواعدة في Web3. لكن ما الذي يجعل DePIN قادرة على إحداث نقلة نوعية لاعتمادها السائد؟
تستفيد DePIN من الحوافز القائمة على الرموز لبناء وصيانة البنية التحتية المادية الواقعية—من شبكات لاسلكية لامركزية ومجموعات الحوسبة إلى شبكات الطاقة الشمسية وحلول التخزين. ومن خلال تحويل مساهمة الأجهزة إلى رموز، فإنها تُقلّل تكاليف رأس المال وتُزعزع هيمنة الشركات العملاقة المركزية التقليدية.
ومن خلال الربط بين الرموز الرقمية والمنفعة الواقعية، توفر DePIN قيمة اقتصادية ملموسة تمتد بعيداً عن مجرد التداول المضاربي.
$RNDR $FIL #DePIN #Web3 #CryptoInnovation #CoinVahini
مع تطور تقنية البلوك تشين بما يتجاوز التطبيقات المالية البحتة، تبرز DePIN بسرعة كأحد أكثر القطاعات الواعدة في Web3. لكن ما الذي يجعل DePIN قادرة على إحداث نقلة نوعية لاعتمادها السائد؟
تستفيد DePIN من الحوافز القائمة على الرموز لبناء وصيانة البنية التحتية المادية الواقعية—من شبكات لاسلكية لامركزية ومجموعات الحوسبة إلى شبكات الطاقة الشمسية وحلول التخزين. ومن خلال تحويل مساهمة الأجهزة إلى رموز، فإنها تُقلّل تكاليف رأس المال وتُزعزع هيمنة الشركات العملاقة المركزية التقليدية.
ومن خلال الربط بين الرموز الرقمية والمنفعة الواقعية، توفر DePIN قيمة اقتصادية ملموسة تمتد بعيداً عن مجرد التداول المضاربي.
$RNDR $FIL #DePIN #Web3 #CryptoInnovation #CoinVahini
1
253

الركود في السوق لا يعني أنه لا توجد قصة. مشروع Storj العريق في التخزين اللامركزي، والذي بالكاد أحد يذكره مؤخرًا، لكن بيانات التداول على الرسم البياني ليست مملة.
السعر الحالي يقارب 0.0508 دولار، وقيمة السوق حوالي 21.61 مليون دولار فقط، بينما تبلغ قيمة التداول خلال 24 ساعة نحو 11.86 مليون دولار؛ ونسبة دوران يومي إلى قيمة السوق تتجاوز الخمسين بالمئة. الجمع بين صغر قيمة السوق وتعزيز معدل التبادل يعني أن الأسهم منخفضة المستوى كانت تتبادل بهدوء، لكن الحماس لم يعد بعد إلى هذا الأصل.
يقدّم Storj تخزينًا سحابيًا لكائنات مشفّرة بطريقة موزّعة: يساهم مشغلو العقد بمساحة قرص خامل لكسب العوائد، بينما تقوم المؤسسات بتقطيع البيانات وتشفيرها وتخزينها بشكل موزع على عقد حول العالم. وهو يُعد ضمن مسار تخزين DePIN أحد الاتجاهات القليلة التي لديها طلب حقيقي قائم على الدفع.
عندما لا يحظى المشروع بالكثير من النقاش، يكون الوقت مناسبًا لوضعه أولًا في قائمة المراقبة. والتركيز في المرحلة المقبلة على أمرين: هل يمكن أن تستمر أحجام التداول في التوسع؟ ومتى ينتعش السرد العام لقطاع التخزين؟ قبل أن يأتي موجة الصعود، تكون الصبر أهم من ملاحقة الارتفاع.
$STORJ #DePIN #去中心化存储
الركود في السوق لا يعني أنه لا توجد قصة. مشروع Storj العريق في التخزين اللامركزي، والذي بالكاد أحد يذكره مؤخرًا، لكن بيانات التداول على الرسم البياني ليست مملة.
السعر الحالي يقارب 0.0508 دولار، وقيمة السوق حوالي 21.61 مليون دولار فقط، بينما تبلغ قيمة التداول خلال 24 ساعة نحو 11.86 مليون دولار؛ ونسبة دوران يومي إلى قيمة السوق تتجاوز الخمسين بالمئة. الجمع بين صغر قيمة السوق وتعزيز معدل التبادل يعني أن الأسهم منخفضة المستوى كانت تتبادل بهدوء، لكن الحماس لم يعد بعد إلى هذا الأصل.
يقدّم Storj تخزينًا سحابيًا لكائنات مشفّرة بطريقة موزّعة: يساهم مشغلو العقد بمساحة قرص خامل لكسب العوائد، بينما تقوم المؤسسات بتقطيع البيانات وتشفيرها وتخزينها بشكل موزع على عقد حول العالم. وهو يُعد ضمن مسار تخزين DePIN أحد الاتجاهات القليلة التي لديها طلب حقيقي قائم على الدفع.
عندما لا يحظى المشروع بالكثير من النقاش، يكون الوقت مناسبًا لوضعه أولًا في قائمة المراقبة. والتركيز في المرحلة المقبلة على أمرين: هل يمكن أن تستمر أحجام التداول في التوسع؟ ومتى ينتعش السرد العام لقطاع التخزين؟ قبل أن يأتي موجة الصعود، تكون الصبر أهم من ملاحقة الارتفاع.
$STORJ #DePIN #去中心化存储
السعر الحالي يقارب 0.0508 دولار، وقيمة السوق حوالي 21.61 مليون دولار فقط، بينما تبلغ قيمة التداول خلال 24 ساعة نحو 11.86 مليون دولار؛ ونسبة دوران يومي إلى قيمة السوق تتجاوز الخمسين بالمئة. الجمع بين صغر قيمة السوق وتعزيز معدل التبادل يعني أن الأسهم منخفضة المستوى كانت تتبادل بهدوء، لكن الحماس لم يعد بعد إلى هذا الأصل.
يقدّم Storj تخزينًا سحابيًا لكائنات مشفّرة بطريقة موزّعة: يساهم مشغلو العقد بمساحة قرص خامل لكسب العوائد، بينما تقوم المؤسسات بتقطيع البيانات وتشفيرها وتخزينها بشكل موزع على عقد حول العالم. وهو يُعد ضمن مسار تخزين DePIN أحد الاتجاهات القليلة التي لديها طلب حقيقي قائم على الدفع.
عندما لا يحظى المشروع بالكثير من النقاش، يكون الوقت مناسبًا لوضعه أولًا في قائمة المراقبة. والتركيز في المرحلة المقبلة على أمرين: هل يمكن أن تستمر أحجام التداول في التوسع؟ ومتى ينتعش السرد العام لقطاع التخزين؟ قبل أن يأتي موجة الصعود، تكون الصبر أهم من ملاحقة الارتفاع.
$STORJ #DePIN #去中心化存储
17
سجّل الدخول لاستكشاف المزيد من المُحتوى
انضم إلى مُستخدمي العملات الرقمية حول العالم على Binance Square
⚡️ احصل على أحدث المعلومات المفيدة عن العملات الرقمية.
💬 موثوقة من قبل أكبر منصّة لتداول العملات الرقمية في العالم.
👍 اكتشف الرؤى الحقيقية من صنّاع المُحتوى الموثوقين.
البريد الإلكتروني / رقم الهاتف
المواضيع الرائجة
1
#FedRateWatch
1.1M مشاهدات
5,369 يقومون بالنقاش
2
#ZcashRises6%
2,341 مشاهدات
76 يقومون بالنقاش
3
#XRPSinks10%
653 مشاهدات
55 يقومون بالنقاش
4
#BitcoinETFsShed$450M
34 مشاهدات
22 يقومون بالنقاش
5
#CircleOpensArcMainnet
331 مشاهدات
25 يقومون بالنقاش
6
#ZcashHoldersBackNU7Upgrade
8,569 مشاهدات
207 يقومون بالنقاش
7
#MSTRTradingVolumeSurpassesMorganStanley
12,344 مشاهدات
397 يقومون بالنقاش
8
#BitcoinFalls4%
28,161 مشاهدات
664 يقومون بالنقاش
9
#SKHynixInTalksToMakeMemoryChipsInUS
13,201 مشاهدات
281 يقومون بالنقاش
10
#OpenAIDiscussesNewFundingAt$1.2TValuation
2,999 مشاهدات
46 يقومون بالنقاش