

何比佐治
1.5k منشورات
何比佐治
إبلاغ
حظر المُستخدم
231 تتابع
14.3K+ المتابعون
1.2K+ إعجاب
منشورات
الكل
اقتباسات
Live
·
--
هابط
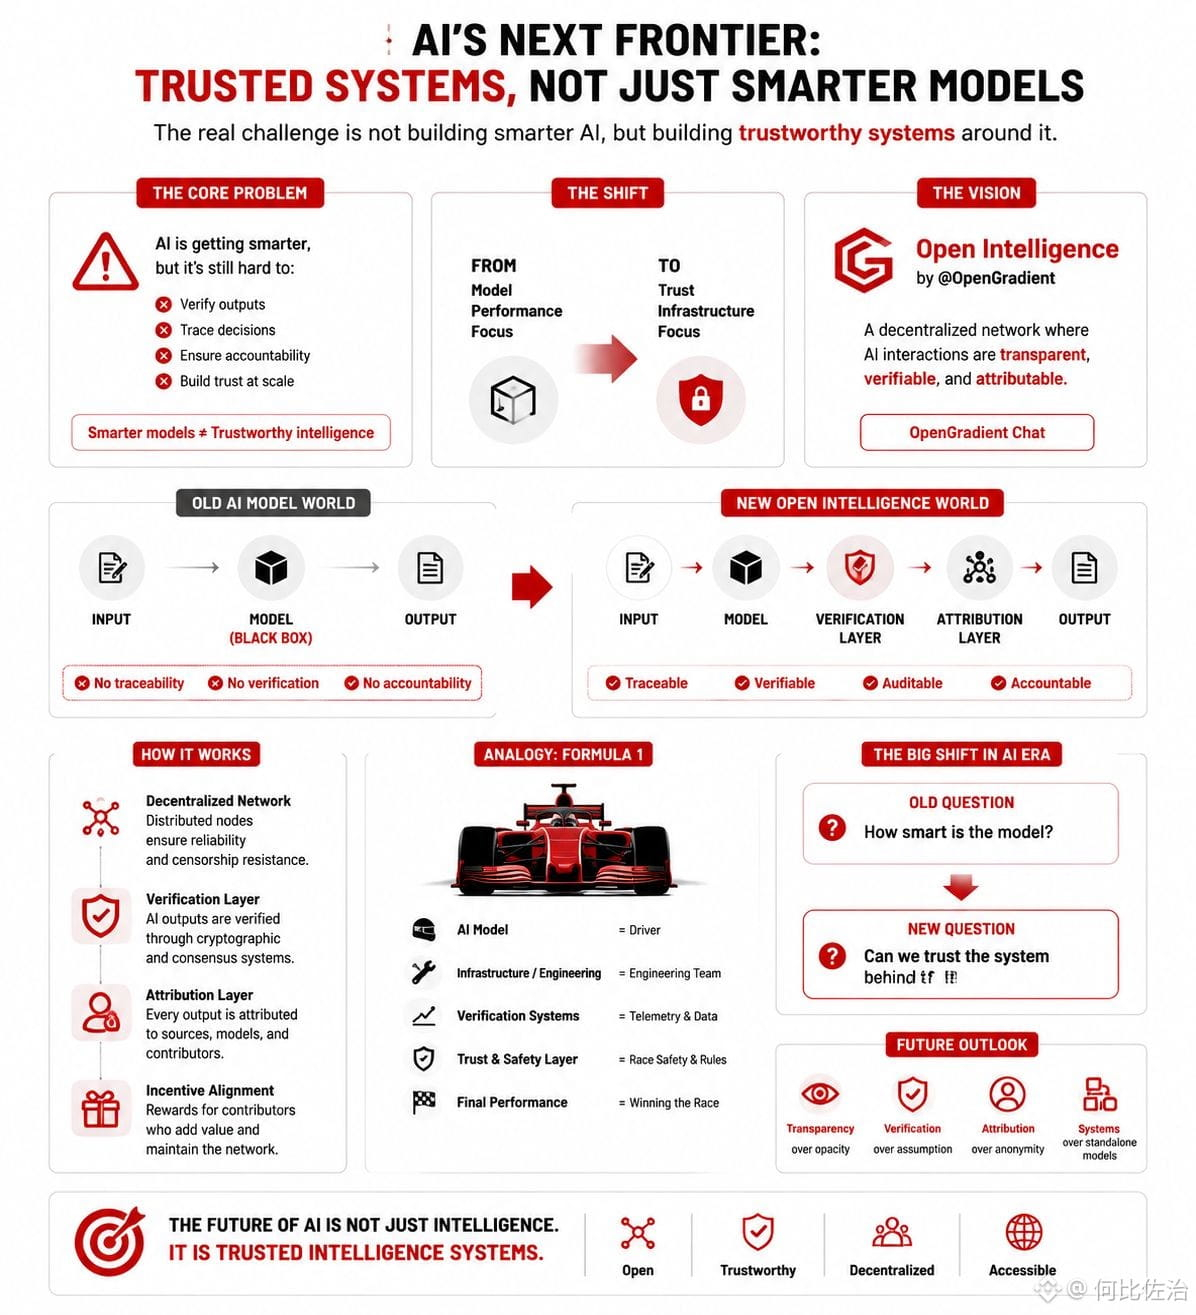
ماذا لو كانت النقطة الحقيقية للذكاء الاصطناعي ليست النماذج الأكثر ذكاءً، بل الأنظمة الموثوقة حولها؟
معظم التركيز ينصب على أداء النموذج، لكن التحدي الحقيقي هو ما إذا كان بإمكاننا فعلاً التحقق مما ينتجه الذكاء الاصطناعي، ونسبته، والثقة به على نطاق واسع.
هذه هي النقطة التي تصبح فيها الأفكار البنية التحتية مهمة.
مشاريع مثل @OpenGradient تستكشف الذكاء المفتوح، حيث لا تقتصر مخرجات الذكاء الاصطناعي على كونها مولدة فقط، بل يمكن تتبعها والتحقق منها ونسبتها عبر شبكة لامركزية من خلال أنظمة مثل OpenGradient Chat.
يمكن استخدام تشبيه سباق الفورمولا 1. السائق يحصل على كل الاهتمام، لكن الأداء يعتمد على بيانات التتبع، وفرق الهندسة، والأنظمة الحقيقية التي تعمل خلف الكواليس.
نماذج الذكاء الاصطناعي هي "السائقون"، لكن البنية التحتية هي ما يحدد الموثوقية والسلامة.
مع توسع الذكاء الاصطناعي في اتخاذ القرارات وحالات الاستخدام في العالم الحقيقي، من المحتمل أن يتحول التركيز من "ما مدى قوة النموذج؟" إلى "ما مدى موثوقية النظام خلفه؟"
هذه هي المناقشة التي تستحق الانتباه.
#OPG $OPG
{spot}(OPGUSDT)
ماذا لو كانت النقطة الحقيقية للذكاء الاصطناعي ليست النماذج الأكثر ذكاءً، بل الأنظمة الموثوقة حولها؟
معظم التركيز ينصب على أداء النموذج، لكن التحدي الحقيقي هو ما إذا كان بإمكاننا فعلاً التحقق مما ينتجه الذكاء الاصطناعي، ونسبته، والثقة به على نطاق واسع.
هذه هي النقطة التي تصبح فيها الأفكار البنية التحتية مهمة.
مشاريع مثل @OpenGradient تستكشف الذكاء المفتوح، حيث لا تقتصر مخرجات الذكاء الاصطناعي على كونها مولدة فقط، بل يمكن تتبعها والتحقق منها ونسبتها عبر شبكة لامركزية من خلال أنظمة مثل OpenGradient Chat.
يمكن استخدام تشبيه سباق الفورمولا 1. السائق يحصل على كل الاهتمام، لكن الأداء يعتمد على بيانات التتبع، وفرق الهندسة، والأنظمة الحقيقية التي تعمل خلف الكواليس.
نماذج الذكاء الاصطناعي هي "السائقون"، لكن البنية التحتية هي ما يحدد الموثوقية والسلامة.
مع توسع الذكاء الاصطناعي في اتخاذ القرارات وحالات الاستخدام في العالم الحقيقي، من المحتمل أن يتحول التركيز من "ما مدى قوة النموذج؟" إلى "ما مدى موثوقية النظام خلفه؟"
هذه هي المناقشة التي تستحق الانتباه.
#OPG $OPG
2
1
147
·
--
صاعد
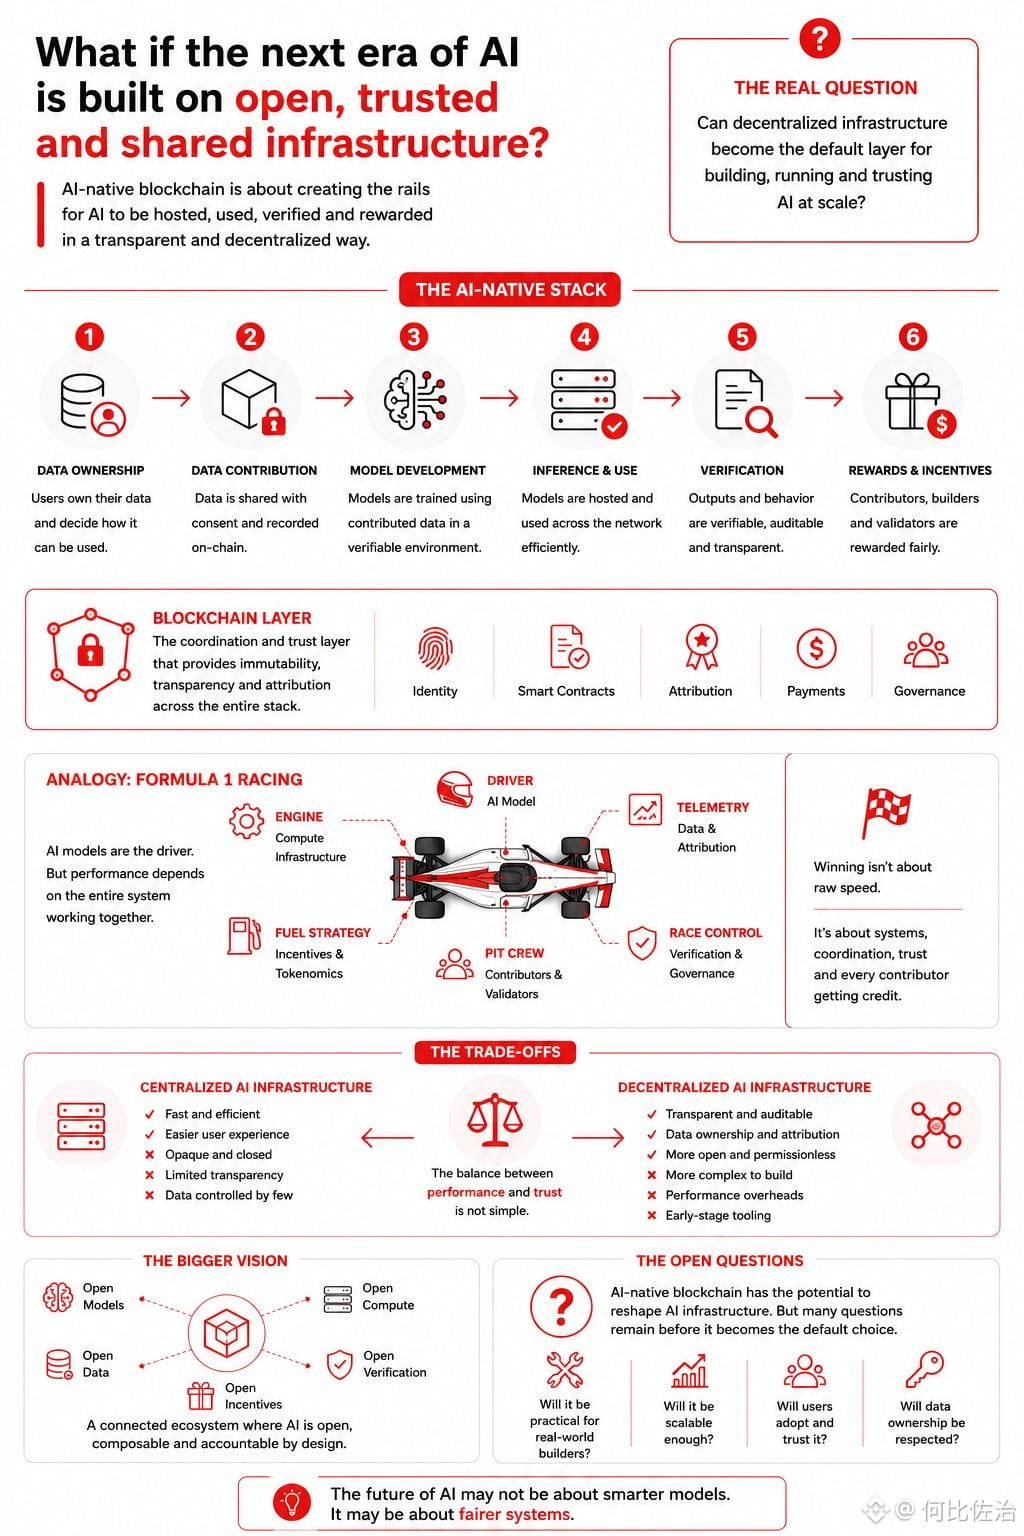
أعتقد أن هذه هي الطريقة الأكثر إثارة للاهتمام للنظر إلى البلوكشينات التي تعتمد على الذكاء الاصطناعي. ليست مجرد شعار تقني آخر، بل هي سؤال حول البنية التحتية.
ما أفهمه من OpenGradient هو أنه يستكشف شبكة يمكن استضافة نماذج الذكاء الاصطناعي عليها، واستخدامها والتحقق منها وتتبعها بطريقة أكثر انفتاحًا.
يذكرني ذلك بفورمولا 1. السيارة تبدو سريعة في يوم السباق، لكن القصة الحقيقية مخفية في المرآب: أجهزة استشعار، مهندسون، استراتيجية الوقود، تيليمتري، واختبارات مستمرة.
الذكاء الاصطناعي مشابه. المخرجات تبدو بسيطة، لكن وراءها نماذج، بيانات، حسابات، أسئلة ملكية، وقضايا ثقة.
قد يساعد البلوكشين من خلال إعطاء أنظمة الذكاء الاصطناعي ذاكرة أوضح. من الذي زود البيانات؟ من الذي نفذ النموذج؟ من الذي يجب أن ينسب إليه الفضل؟ من الذي يحصل على المكافأة؟
هذه ليست أسئلة صغيرة، خاصة مع تحول الذكاء الاصطناعي إلى جزء من الأدوات اليومية.
لكنني أعتقد أن هناك تنازلات صعبة. الذكاء الاصطناعي يحتاج إلى السرعة والنطاق. البلوكشينات تحتاج إلى التحقق والتوافق. هذين العالمين لا يتحركان بشكل طبيعي بنفس الوتيرة.
الفكرة الأكبر ليست استبدال منصات الذكاء الاصطناعي اليوم بين عشية وضحاها.
إنها تسأل ما إذا كانت بنية الذكاء الاصطناعي المستقبلية يمكن أن تكون أكثر شفافية، وأكثر مسؤولية، وأقل اعتمادًا على الأنظمة المغلقة.
السؤال الحقيقي هو ما إذا كان البلوكشين الذي يعتمد على الذكاء الاصطناعي يمكن أن ينتقل من مفهوم ذكي إلى شيء يعتمد عليه الناس فعلاً عندما تكون الثقة مهمة.
@OpenGradient #OPG $OPG
{spot}(OPGUSDT)
أعتقد أن هذه هي الطريقة الأكثر إثارة للاهتمام للنظر إلى البلوكشينات التي تعتمد على الذكاء الاصطناعي. ليست مجرد شعار تقني آخر، بل هي سؤال حول البنية التحتية.
ما أفهمه من OpenGradient هو أنه يستكشف شبكة يمكن استضافة نماذج الذكاء الاصطناعي عليها، واستخدامها والتحقق منها وتتبعها بطريقة أكثر انفتاحًا.
يذكرني ذلك بفورمولا 1. السيارة تبدو سريعة في يوم السباق، لكن القصة الحقيقية مخفية في المرآب: أجهزة استشعار، مهندسون، استراتيجية الوقود، تيليمتري، واختبارات مستمرة.
الذكاء الاصطناعي مشابه. المخرجات تبدو بسيطة، لكن وراءها نماذج، بيانات، حسابات، أسئلة ملكية، وقضايا ثقة.
قد يساعد البلوكشين من خلال إعطاء أنظمة الذكاء الاصطناعي ذاكرة أوضح. من الذي زود البيانات؟ من الذي نفذ النموذج؟ من الذي يجب أن ينسب إليه الفضل؟ من الذي يحصل على المكافأة؟
هذه ليست أسئلة صغيرة، خاصة مع تحول الذكاء الاصطناعي إلى جزء من الأدوات اليومية.
لكنني أعتقد أن هناك تنازلات صعبة. الذكاء الاصطناعي يحتاج إلى السرعة والنطاق. البلوكشينات تحتاج إلى التحقق والتوافق. هذين العالمين لا يتحركان بشكل طبيعي بنفس الوتيرة.
الفكرة الأكبر ليست استبدال منصات الذكاء الاصطناعي اليوم بين عشية وضحاها.
إنها تسأل ما إذا كانت بنية الذكاء الاصطناعي المستقبلية يمكن أن تكون أكثر شفافية، وأكثر مسؤولية، وأقل اعتمادًا على الأنظمة المغلقة.
السؤال الحقيقي هو ما إذا كان البلوكشين الذي يعتمد على الذكاء الاصطناعي يمكن أن ينتقل من مفهوم ذكي إلى شيء يعتمد عليه الناس فعلاً عندما تكون الثقة مهمة.
@OpenGradient #OPG $OPG
3
116
·
--
صاعد
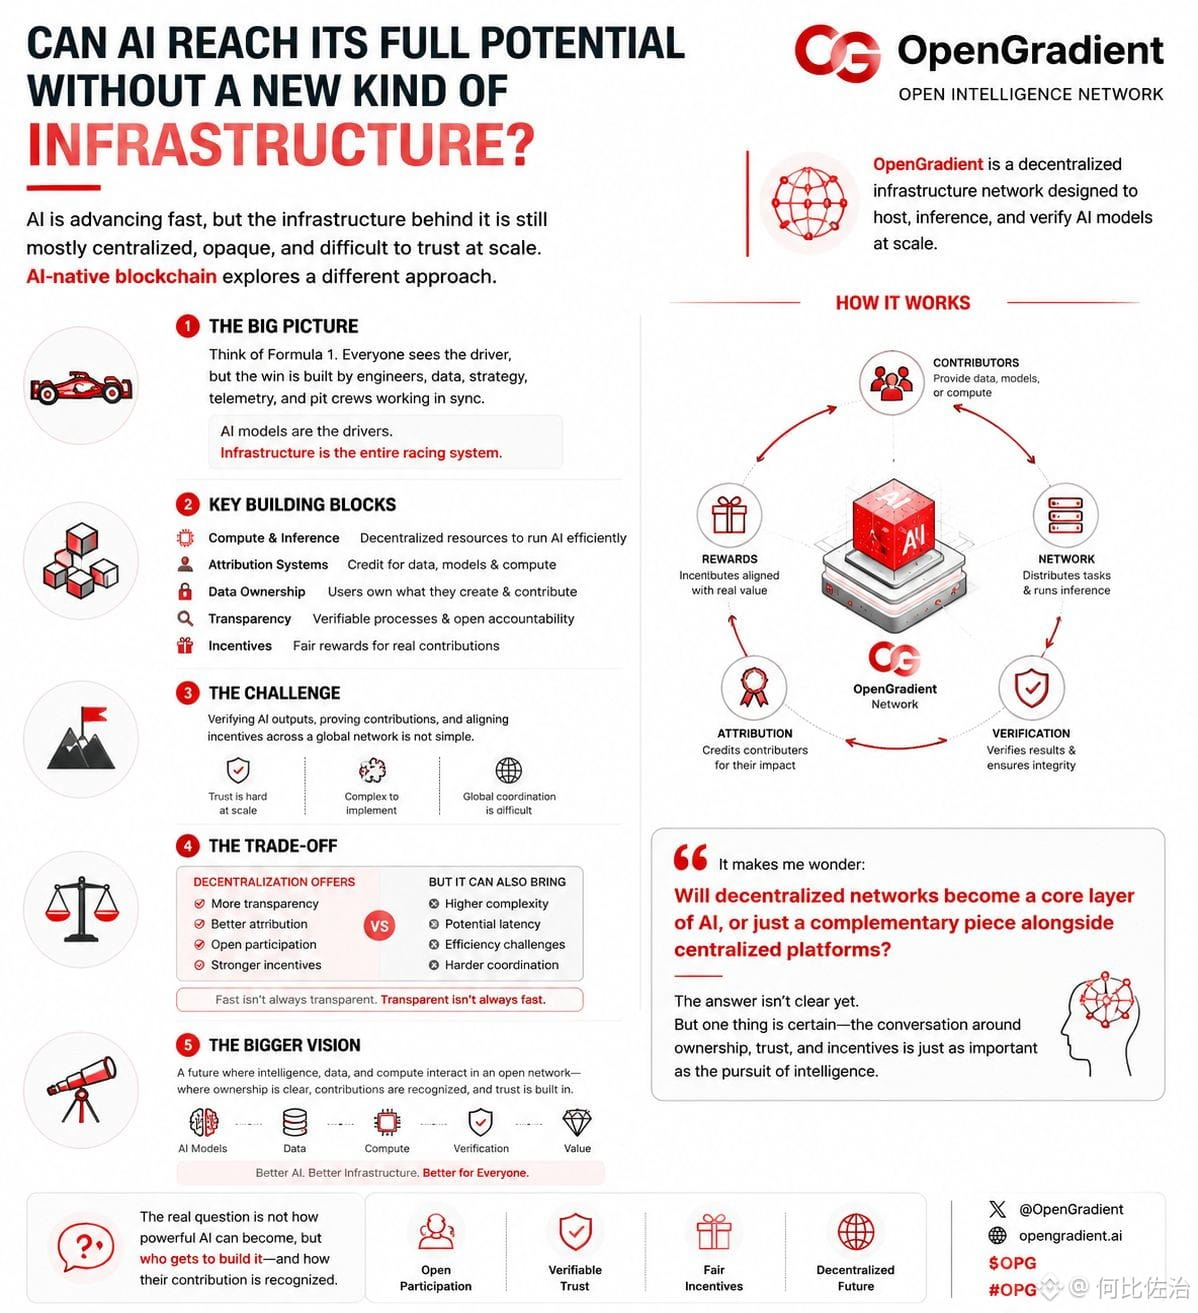
أعتقد أن هذا واحد من أكثر الأسئلة إثارة للاهتمام في الذكاء الاصطناعي في الوقت الحالي.
تركز معظم المناقشات على النماذج، والمعايير، والقدرات. لكن مع تزايد دمج الذكاء الاصطناعي في الحياة اليومية، أظل أتساءل عن الأنظمة التي تدعمه. من يملك البيانات؟ من يحصل على المكافأة لمساهمته في الموارد؟ وكيف نعرف ما الذي يفعله نظام الذكاء الاصطناعي فعلاً خلف الكواليس؟
ما أفهمه هو أن البلوكشين الأصلي للذكاء الاصطناعي يحاول استكشاف هذه الأسئلة بدلاً من مجرد جعل الذكاء الاصطناعي أكبر أو أسرع. الفكرة تبدو أقل حول الضجة وأكثر حول إنشاء بنية تحتية حيث يمكن تتبع العمليات، والنماذج، والمساهمات والتحقق منها بشكل أكثر شفافية.
يذكرني قليلاً بسباقات الفورمولا 1. يرى الناس السائق في يوم السباق، لكن هناك المئات من المهندسين، والفنيين، والأنظمة تعمل في الخلفية. نماذج الذكاء الاصطناعي مشابهة. نلاحظ الناتج، لكن نادراً ما نفكر في البنية التحتية التي جعلت ذلك ممكنًا.
بالطبع، هناك تحديات. المزيد من الشفافية يمكن أن يعني مزيدًا من التعقيد. يبدو أن التخصيص الأفضل رائع، لكن تنفيذه على نطاق واسع ليس سهلاً. ورغم أن اللامركزية يمكن أن تخلق هياكل تحفيزية جديدة، قد لا يكون ذلك دائمًا هو المسار الأكثر كفاءة.
ومع ذلك، يجعلني أتساءل ما إذا كانت مستقبل الذكاء الاصطناعي سيعتمد بقدر ما على الثقة والملكية كما يعتمد على الذكاء نفسه.
مشاريع مثل OpenGradient تستكشف هذا المجال، وسواء أصبحت هذه الأفكار سائدة أم لا، أعتقد أنها تثير أسئلة مهمة حول كيفية تطور بنية الذكاء الاصطناعي.
السؤال الحقيقي ليس فقط مدى قوة الذكاء الاصطناعي، ولكن من يحق له المشاركة في بنائه وكيف يتم الاعتراف بتلك المشاركة.
@OpenGradient
$OPG
#OPG
{spot}(OPGUSDT)
أعتقد أن هذا واحد من أكثر الأسئلة إثارة للاهتمام في الذكاء الاصطناعي في الوقت الحالي.
تركز معظم المناقشات على النماذج، والمعايير، والقدرات. لكن مع تزايد دمج الذكاء الاصطناعي في الحياة اليومية، أظل أتساءل عن الأنظمة التي تدعمه. من يملك البيانات؟ من يحصل على المكافأة لمساهمته في الموارد؟ وكيف نعرف ما الذي يفعله نظام الذكاء الاصطناعي فعلاً خلف الكواليس؟
ما أفهمه هو أن البلوكشين الأصلي للذكاء الاصطناعي يحاول استكشاف هذه الأسئلة بدلاً من مجرد جعل الذكاء الاصطناعي أكبر أو أسرع. الفكرة تبدو أقل حول الضجة وأكثر حول إنشاء بنية تحتية حيث يمكن تتبع العمليات، والنماذج، والمساهمات والتحقق منها بشكل أكثر شفافية.
يذكرني قليلاً بسباقات الفورمولا 1. يرى الناس السائق في يوم السباق، لكن هناك المئات من المهندسين، والفنيين، والأنظمة تعمل في الخلفية. نماذج الذكاء الاصطناعي مشابهة. نلاحظ الناتج، لكن نادراً ما نفكر في البنية التحتية التي جعلت ذلك ممكنًا.
بالطبع، هناك تحديات. المزيد من الشفافية يمكن أن يعني مزيدًا من التعقيد. يبدو أن التخصيص الأفضل رائع، لكن تنفيذه على نطاق واسع ليس سهلاً. ورغم أن اللامركزية يمكن أن تخلق هياكل تحفيزية جديدة، قد لا يكون ذلك دائمًا هو المسار الأكثر كفاءة.
ومع ذلك، يجعلني أتساءل ما إذا كانت مستقبل الذكاء الاصطناعي سيعتمد بقدر ما على الثقة والملكية كما يعتمد على الذكاء نفسه.
مشاريع مثل OpenGradient تستكشف هذا المجال، وسواء أصبحت هذه الأفكار سائدة أم لا، أعتقد أنها تثير أسئلة مهمة حول كيفية تطور بنية الذكاء الاصطناعي.
السؤال الحقيقي ليس فقط مدى قوة الذكاء الاصطناعي، ولكن من يحق له المشاركة في بنائه وكيف يتم الاعتراف بتلك المشاركة.
@OpenGradient
$OPG
#OPG
4
1
91
·
--
هابط
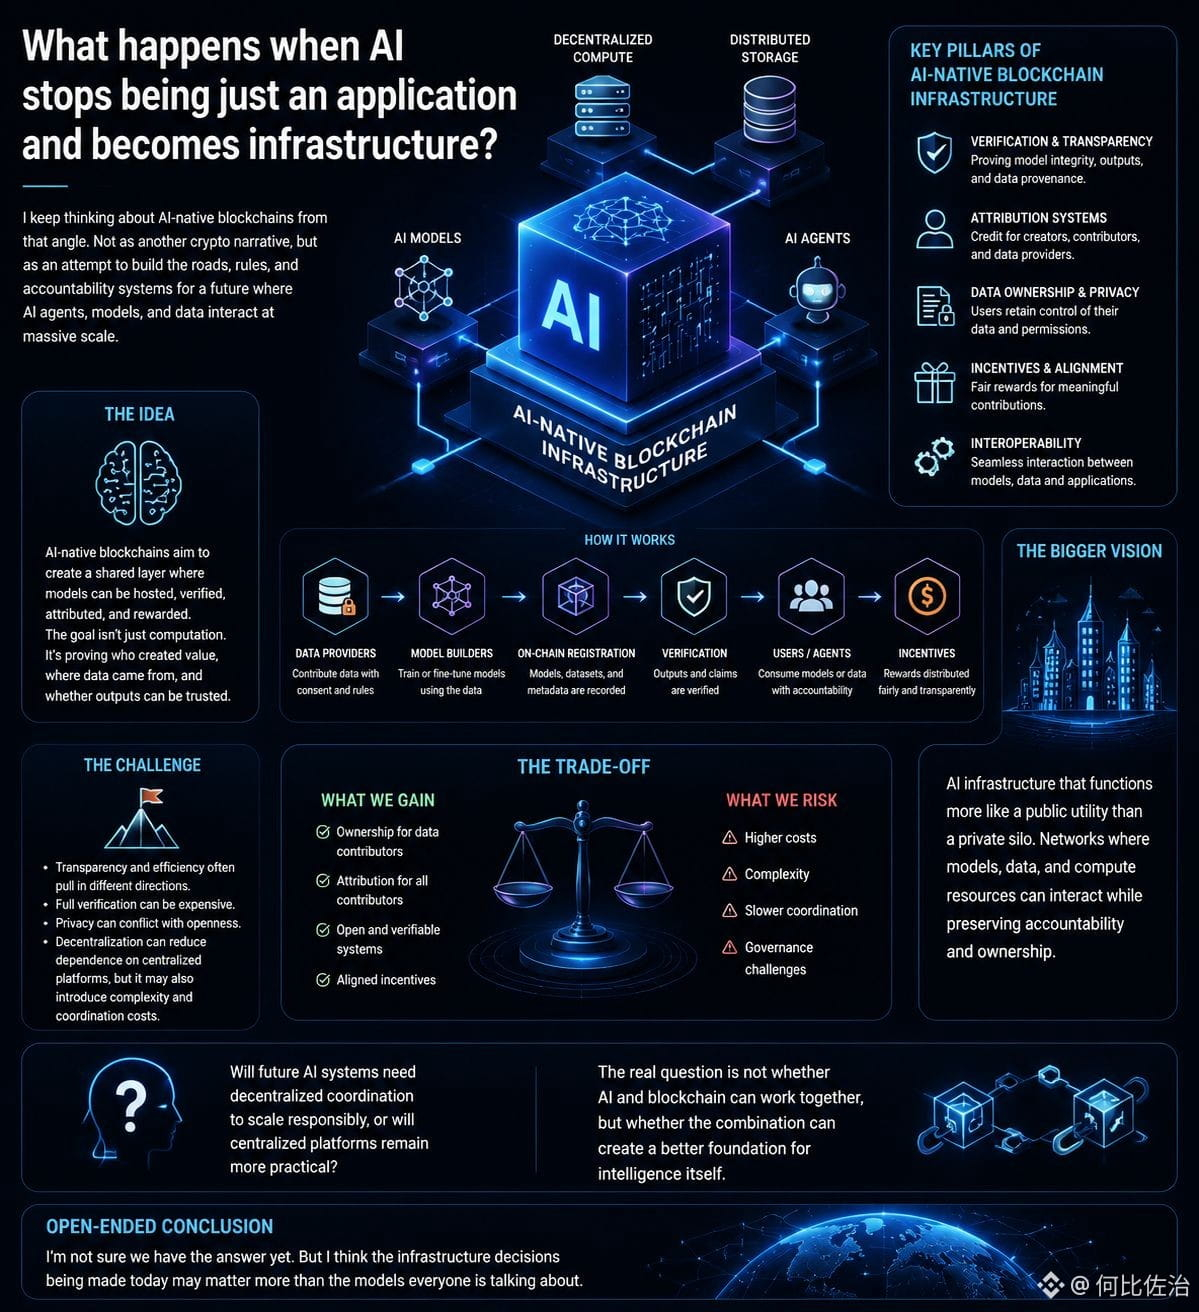
أنا أفكر في بلوكشينات الذكاء الاصطناعي من هذه الزاوية. ليس كحكاية جديدة في عالم الكريبتو، ولكن كمحاولة لبناء الطرق والقوانين وأنظمة المساءلة لمستقبل يتفاعل فيه وكلاء الذكاء الاصطناعي والنماذج والبيانات على نطاق واسع. سباق فورمولا 1 يتبادر إلى ذهني. السيارة الفائزة مهمة، لكن المسار وأنظمة القياس وفرق الصيانة واللوائح والتحقق من الأداء مهمة أيضاً. بدون تلك البنية التحتية، يفقد السباق مصداقيته. قد يكون الذكاء الاصطناعي متوجهاً نحو واقع مشابه. ما أفهمه هو أن بلوكشينات الذكاء الاصطناعي تحاول إنشاء طبقة مشتركة حيث يمكن استضافة النماذج والتحقق منها وإعطائها القيمة والمكافأة. الهدف ليس فقط الحساب. بل إثبات من خلق القيمة، من أين جاءت البيانات، وما إذا كانت المخرجات يمكن الوثوق بها. التحدي هو أن الشفافية والكفاءة غالبًا ما تسحب في اتجاهات مختلفة. التحقق الكامل قد يكون مكلفًا. الخصوصية قد تتعارض مع الانفتاح. يمكن أن يقلل اللامركزية الاعتماد على المنصات المركزية، لكنها قد تُدخل أيضًا تعقيد وتكاليف التنسيق. أعتقد أن المقايضة تستحق الفحص الدقيق. نحتاج إلى حوافز للبناة، وملكية لمساهمي البيانات، وأنظمة نسب لا تختفي خلف منصات الصندوق الأسود. في الوقت نفسه، إضافة بلوكشين إلى الذكاء الاصطناعي لا تحل تلقائيًا مشاكل الثقة أو الجودة أو الحوكمة. الرؤية الأكبر مثيرة للاهتمام: بنية تحتية للذكاء الاصطناعي تعمل أكثر كمنفعة عامة بدلاً من حجرة خاصة. شبكات حيث يمكن للنماذج والبيانات وموارد الحوسبة التفاعل مع الحفاظ على المساءلة والملكية. لكنني أتساءل: هل ستحتاج أنظمة الذكاء الاصطناعي المستقبلية إلى تنسيق لامركزي للتوسع بشكل مسؤول، أم ستظل المنصات المركزية أكثر عملية؟ السؤال الحقيقي ليس ما إذا كان بإمكان الذكاء الاصطناعي والبلوكشين العمل معًا، ولكن ما إذا كانت هذه المجموعة يمكن أن تخلق أساسًا أفضل للذكاء نفسه. لست متأكدًا إذا كان لدينا الإجابة بعد. لكنني أعتقد أن قرارات البنية التحتية التي تُتخذ اليوم قد تكون أكثر أهمية من النماذج التي يتحدث عنها الجميع. @OpenGradient #OPG $OPG
{spot}(OPGUSDT)
أنا أفكر في بلوكشينات الذكاء الاصطناعي من هذه الزاوية. ليس كحكاية جديدة في عالم الكريبتو، ولكن كمحاولة لبناء الطرق والقوانين وأنظمة المساءلة لمستقبل يتفاعل فيه وكلاء الذكاء الاصطناعي والنماذج والبيانات على نطاق واسع. سباق فورمولا 1 يتبادر إلى ذهني. السيارة الفائزة مهمة، لكن المسار وأنظمة القياس وفرق الصيانة واللوائح والتحقق من الأداء مهمة أيضاً. بدون تلك البنية التحتية، يفقد السباق مصداقيته. قد يكون الذكاء الاصطناعي متوجهاً نحو واقع مشابه. ما أفهمه هو أن بلوكشينات الذكاء الاصطناعي تحاول إنشاء طبقة مشتركة حيث يمكن استضافة النماذج والتحقق منها وإعطائها القيمة والمكافأة. الهدف ليس فقط الحساب. بل إثبات من خلق القيمة، من أين جاءت البيانات، وما إذا كانت المخرجات يمكن الوثوق بها. التحدي هو أن الشفافية والكفاءة غالبًا ما تسحب في اتجاهات مختلفة. التحقق الكامل قد يكون مكلفًا. الخصوصية قد تتعارض مع الانفتاح. يمكن أن يقلل اللامركزية الاعتماد على المنصات المركزية، لكنها قد تُدخل أيضًا تعقيد وتكاليف التنسيق. أعتقد أن المقايضة تستحق الفحص الدقيق. نحتاج إلى حوافز للبناة، وملكية لمساهمي البيانات، وأنظمة نسب لا تختفي خلف منصات الصندوق الأسود. في الوقت نفسه، إضافة بلوكشين إلى الذكاء الاصطناعي لا تحل تلقائيًا مشاكل الثقة أو الجودة أو الحوكمة. الرؤية الأكبر مثيرة للاهتمام: بنية تحتية للذكاء الاصطناعي تعمل أكثر كمنفعة عامة بدلاً من حجرة خاصة. شبكات حيث يمكن للنماذج والبيانات وموارد الحوسبة التفاعل مع الحفاظ على المساءلة والملكية. لكنني أتساءل: هل ستحتاج أنظمة الذكاء الاصطناعي المستقبلية إلى تنسيق لامركزي للتوسع بشكل مسؤول، أم ستظل المنصات المركزية أكثر عملية؟ السؤال الحقيقي ليس ما إذا كان بإمكان الذكاء الاصطناعي والبلوكشين العمل معًا، ولكن ما إذا كانت هذه المجموعة يمكن أن تخلق أساسًا أفضل للذكاء نفسه. لست متأكدًا إذا كان لدينا الإجابة بعد. لكنني أعتقد أن قرارات البنية التحتية التي تُتخذ اليوم قد تكون أكثر أهمية من النماذج التي يتحدث عنها الجميع. @OpenGradient #OPG $OPG
3
2
125
·
--
صاعد
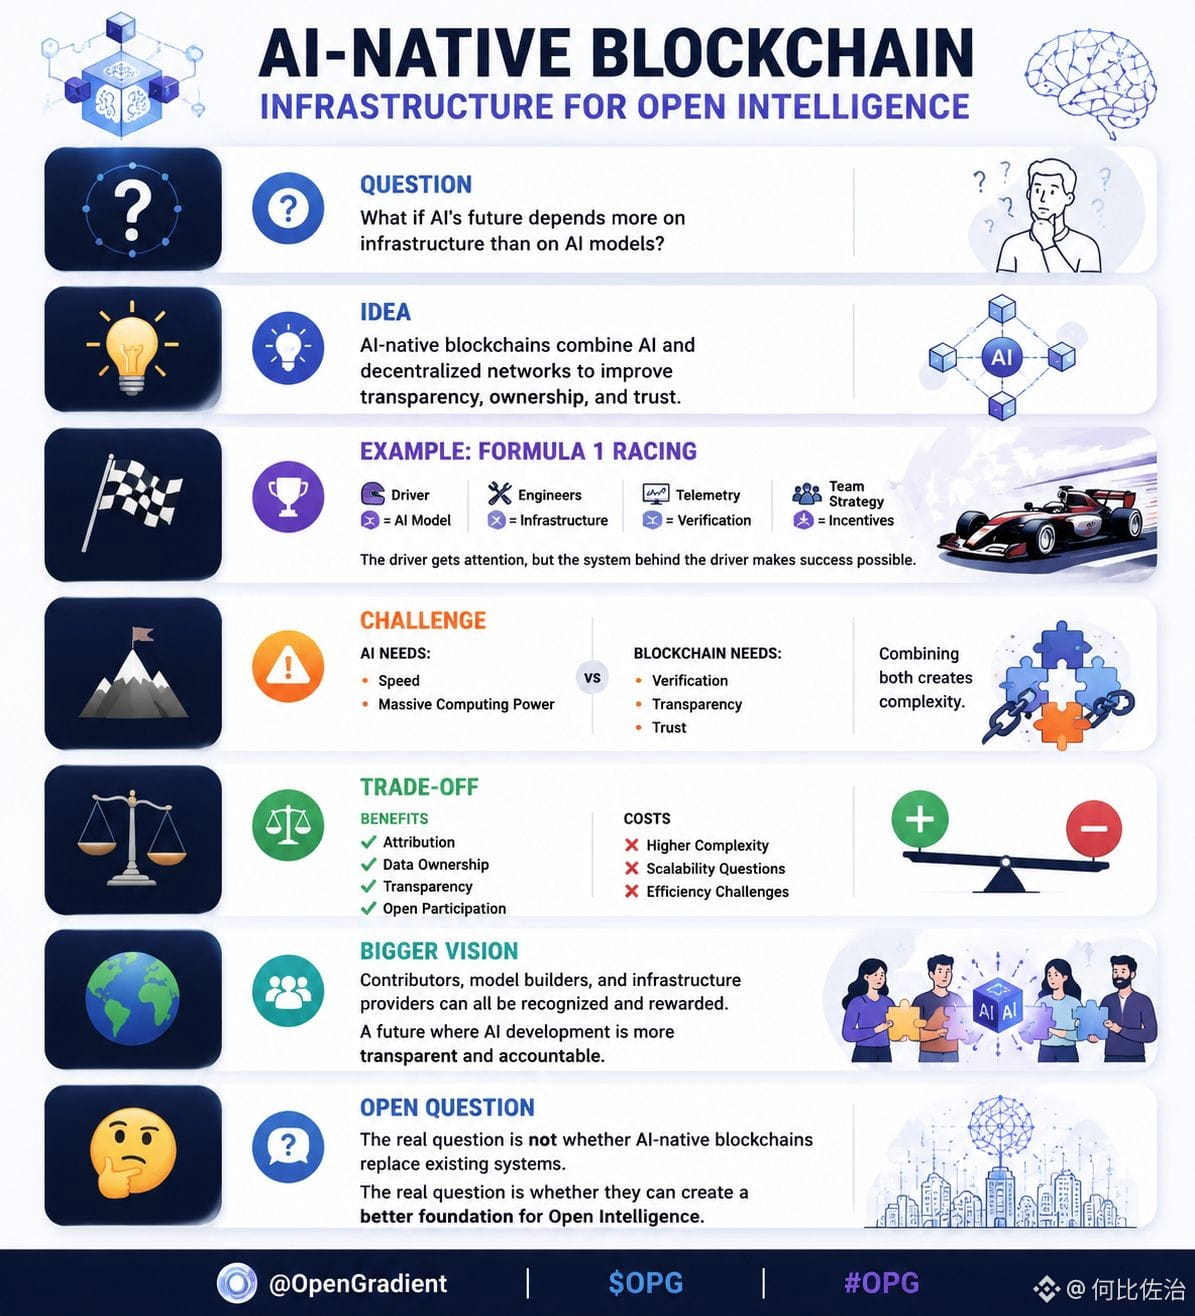
كنت أفكر مؤخرًا في سلاسل الكتل الأصلية للذكاء الاصطناعي، خاصة المشاريع مثل @OpenGradient وكيف تتعامل مع بنية تحتية للذكاء الاصطناعي اللامركزية. ما أفهمه هو أن الهدف ليس مجرد تشغيل نماذج الذكاء الاصطناعي، بل إنشاء أنظمة حيث يمكن أن يحدث الاستضافة، واستنتاج النتائج، والتحقق، والتخصيص بشكل شفاف عبر شبكة بدلاً من داخل بعض المنصات المركزية.
تشبيه سباق الفورمولا 1 يتبادر إلى الذهن. معظم الناس يركزون على السائق، لكن السباقات غالبًا ما تقررها الفرق الهندسية، وأنظمة القياس عن بُعد، وفرق الصيانة التي تعمل خلف الكواليس. قد تكون نماذج الذكاء الاصطناعي هي السائقون، لكن البنية التحتية هي الفريق الذي يجعل كل شيء ممكنًا.
التحدي هو أن الذكاء الاصطناعي وسلاسل الكتل تحل مشاكل مختلفة. يحتاج الذكاء الاصطناعي إلى السرعة والحسابات الضخمة، بينما تعطي سلاسل الكتل الأولوية للتحقق والثقة. الجمع بينهما يخلق خيارات صعبة حول التكلفة والكفاءة وقابلية التوسع.
ومع ذلك، يجعلني أتساءل ما إذا كانت أنظمة التخصيص وطبقات الملكية الشفافة يمكن أن تصبح بنفس أهمية النماذج نفسها. إذا تم التعرف على المساهمين في البيانات، وبناة النماذج، ومقدمي البنية التحتية ومكافأتهم، فقد تبدو الحوافز مختلفة تمامًا عن نظام الذكاء الاصطناعي اليوم.
السؤال الحقيقي ليس ما إذا كانت سلاسل الكتل الأصلية للذكاء الاصطناعي ستحل محل الأنظمة الحالية. بل ما إذا كانت تستطيع إنشاء أساس أكثر شفافية ومسؤولية للذكاء المفتوح. مشاريع مثل @OpenGradient تستكشف هذه الإمكانية، لكن لا تزال هناك العديد من الأسئلة دون إجابات.
أعتقد أن التطور التالي للبنية التحتية للذكاء الاصطناعي سيتم الحكم عليه أقل من حيث الأداء الخام وأكثر من حيث مدى توازنه بين الثقة، والملكية، والحوافز، والانفتاح.
$OPG #OPG
{spot}(OPGUSDT)
كنت أفكر مؤخرًا في سلاسل الكتل الأصلية للذكاء الاصطناعي، خاصة المشاريع مثل @OpenGradient وكيف تتعامل مع بنية تحتية للذكاء الاصطناعي اللامركزية. ما أفهمه هو أن الهدف ليس مجرد تشغيل نماذج الذكاء الاصطناعي، بل إنشاء أنظمة حيث يمكن أن يحدث الاستضافة، واستنتاج النتائج، والتحقق، والتخصيص بشكل شفاف عبر شبكة بدلاً من داخل بعض المنصات المركزية.
تشبيه سباق الفورمولا 1 يتبادر إلى الذهن. معظم الناس يركزون على السائق، لكن السباقات غالبًا ما تقررها الفرق الهندسية، وأنظمة القياس عن بُعد، وفرق الصيانة التي تعمل خلف الكواليس. قد تكون نماذج الذكاء الاصطناعي هي السائقون، لكن البنية التحتية هي الفريق الذي يجعل كل شيء ممكنًا.
التحدي هو أن الذكاء الاصطناعي وسلاسل الكتل تحل مشاكل مختلفة. يحتاج الذكاء الاصطناعي إلى السرعة والحسابات الضخمة، بينما تعطي سلاسل الكتل الأولوية للتحقق والثقة. الجمع بينهما يخلق خيارات صعبة حول التكلفة والكفاءة وقابلية التوسع.
ومع ذلك، يجعلني أتساءل ما إذا كانت أنظمة التخصيص وطبقات الملكية الشفافة يمكن أن تصبح بنفس أهمية النماذج نفسها. إذا تم التعرف على المساهمين في البيانات، وبناة النماذج، ومقدمي البنية التحتية ومكافأتهم، فقد تبدو الحوافز مختلفة تمامًا عن نظام الذكاء الاصطناعي اليوم.
السؤال الحقيقي ليس ما إذا كانت سلاسل الكتل الأصلية للذكاء الاصطناعي ستحل محل الأنظمة الحالية. بل ما إذا كانت تستطيع إنشاء أساس أكثر شفافية ومسؤولية للذكاء المفتوح. مشاريع مثل @OpenGradient تستكشف هذه الإمكانية، لكن لا تزال هناك العديد من الأسئلة دون إجابات.
أعتقد أن التطور التالي للبنية التحتية للذكاء الاصطناعي سيتم الحكم عليه أقل من حيث الأداء الخام وأكثر من حيث مدى توازنه بين الثقة، والملكية، والحوافز، والانفتاح.
$OPG #OPG
98
·
--
صاعد
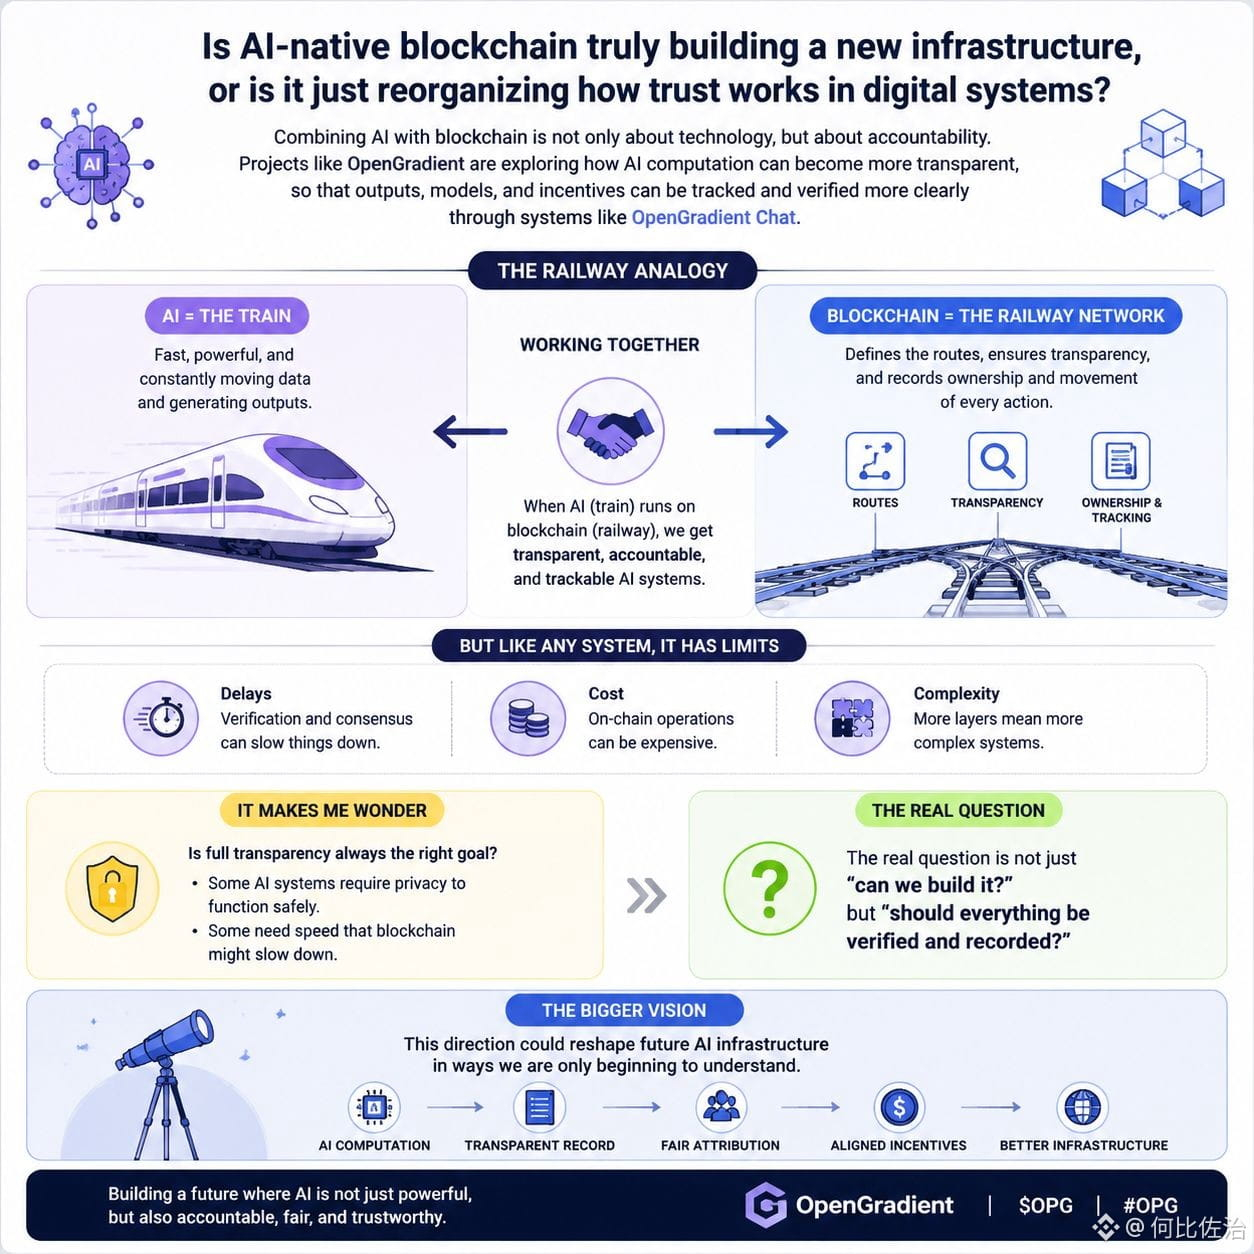
هل تقوم البلوكشين المدعومة بالذكاء الاصطناعي حقًا ببناء بنية تحتية جديدة، أم أنها تعيد تنظيم كيفية عمل الثقة في الأنظمة الرقمية؟
ما أفهمه هو أن دمج الذكاء الاصطناعي مع البلوكشين ليس مجرد تقنية، بل يتعلق بالمساءلة. مشاريع مثل @OpenGradient تستكشف كيف يمكن أن يصبح حساب الذكاء الاصطناعي أكثر شفافية، بحيث يمكن تتبع النتائج والنماذج والحوافز والتحقق منها بشكل أوضح من خلال أنظمة مثل OpenGradient Chat.
أراها مثل نظام السكك الحديدية. الذكاء الاصطناعي هو القطار—سريع، قوي، ويتحرك باستمرار بالبيانات. البلوكشين هو شبكة السكك الحديدية التي تحدد الطرق، وتضمن الشفافية، وتسجيل الملكية والحركة. ولكن مثل أي نظام، يأتي مع حدود مثل التأخيرات، والتكاليف، والتعقيد.
يجعلني أتساءل عما إذا كانت الشفافية الكاملة دائمًا هي الهدف الصحيح. بعض أنظمة الذكاء الاصطناعي تتطلب الخصوصية لتعمل بأمان، بينما يتطلب البعض الآخر سرعة قد تؤخرها البلوكشين.
السؤال الحقيقي ليس فقط "هل يمكننا بناؤها؟" ولكن "هل يجب التحقق من كل شيء وتسجيله؟"
ومع ذلك، أعتقد أن هذا الاتجاه قد يعيد تشكيل بنية الذكاء الاصطناعي المستقبلية بطرق بدأنا فقط في فهمها.
@OpenGradient $OPG #OPG
{spot}(OPGUSDT)
هل تقوم البلوكشين المدعومة بالذكاء الاصطناعي حقًا ببناء بنية تحتية جديدة، أم أنها تعيد تنظيم كيفية عمل الثقة في الأنظمة الرقمية؟
ما أفهمه هو أن دمج الذكاء الاصطناعي مع البلوكشين ليس مجرد تقنية، بل يتعلق بالمساءلة. مشاريع مثل @OpenGradient تستكشف كيف يمكن أن يصبح حساب الذكاء الاصطناعي أكثر شفافية، بحيث يمكن تتبع النتائج والنماذج والحوافز والتحقق منها بشكل أوضح من خلال أنظمة مثل OpenGradient Chat.
أراها مثل نظام السكك الحديدية. الذكاء الاصطناعي هو القطار—سريع، قوي، ويتحرك باستمرار بالبيانات. البلوكشين هو شبكة السكك الحديدية التي تحدد الطرق، وتضمن الشفافية، وتسجيل الملكية والحركة. ولكن مثل أي نظام، يأتي مع حدود مثل التأخيرات، والتكاليف، والتعقيد.
يجعلني أتساءل عما إذا كانت الشفافية الكاملة دائمًا هي الهدف الصحيح. بعض أنظمة الذكاء الاصطناعي تتطلب الخصوصية لتعمل بأمان، بينما يتطلب البعض الآخر سرعة قد تؤخرها البلوكشين.
السؤال الحقيقي ليس فقط "هل يمكننا بناؤها؟" ولكن "هل يجب التحقق من كل شيء وتسجيله؟"
ومع ذلك، أعتقد أن هذا الاتجاه قد يعيد تشكيل بنية الذكاء الاصطناعي المستقبلية بطرق بدأنا فقط في فهمها.
@OpenGradient $OPG #OPG
95
·
--
هابط
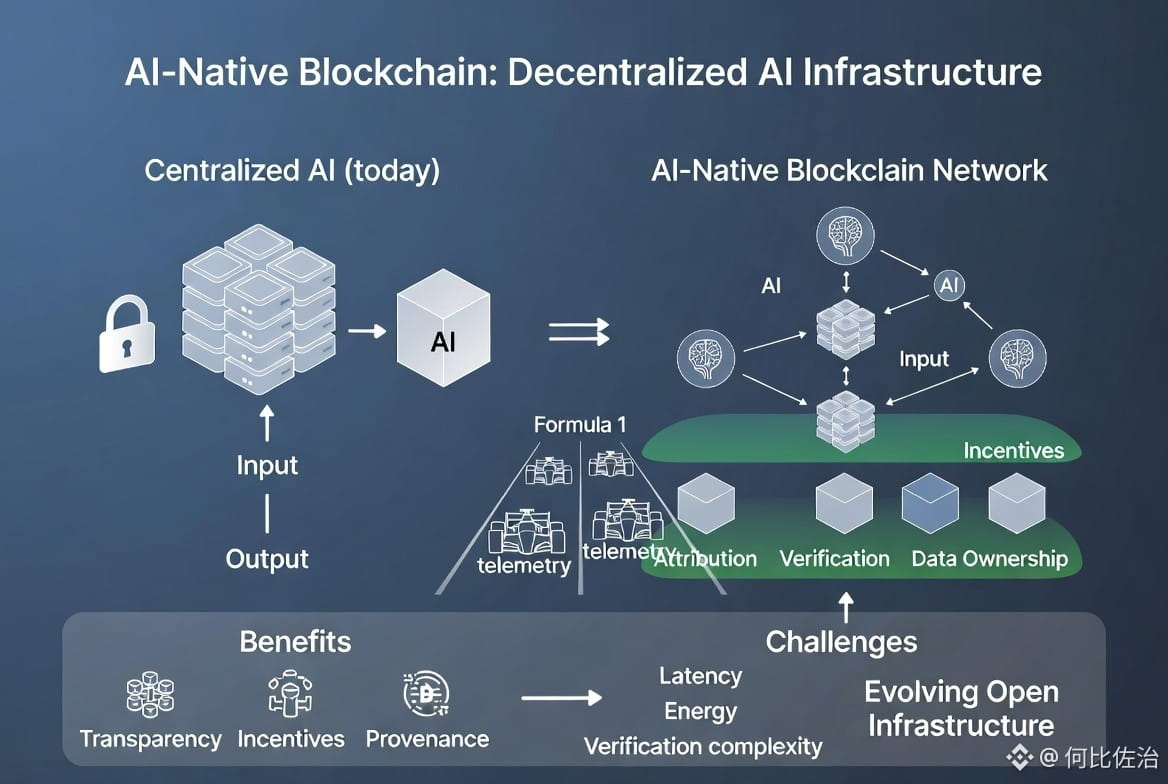
كنت أفكر في أفكار "بلوكتشين-native" مثل @OpenGradient : نظام لامركزي لاستضافة وتشغيل والتحقق من نماذج الذكاء الاصطناعي على السلسلة. الأمر لا يقتصر على إضافة البلوكتشين للذكاء الاصطناعي، بل يتضمن دمجهما بعمق من أجل النسب، ملكية البيانات، والحوافز.
تخيل الفورمولا 1: سيارات تُدفع لحدودها تحت قواعد واضحة، مع بيانات عامة تدفع التقدم الجماعي. هنا، يمكن للنماذج أن "تتسابق" على بنية تحتية مشتركة، مع البلوكتشين الذي يتتبع المساهمات، ويكافئ العمل المفيد، ويتحقق من النتائج.
ما أفهمه هو الجاذبية—مزيد من الشفافية، حوافز أكثر عدلاً، وتقليل الاعتماد على عدد قليل من العملاقين. لكن التحديات حقيقية: استدلال الذكاء الاصطناعي يتطلب طاقة كبيرة؛ لامركزته ينطوي على مخاطر تأخير، هدر الطاقة، والتحقق الصعب للنماذج الكبيرة.
ما هو التبادل؟ المركزية توفر السرعة اليوم، بينما اللامركزية تقدم المرونة لكنها قد تشتت التقدم أو تمكن من أساليب جديدة للعب.
الرؤية الأكبر هي بنية تحتية مفتوحة ومتطورة مع أصول واضحة، مثل المصدر المفتوح القابل للتحقق لكن مع حقوق أقوى. ومع ذلك، السؤال الحقيقي هو ما إذا كان يمكنه سد الفجوة في الأداء مع الأنظمة المركزية بسرعة كافية.
هل يستحق التعقيد؟ أنا متشكك لكنني فضولي. ماذا تعتقد؟
@OpenGradient #OPG $OPG
{spot}(OPGUSDT)
كنت أفكر في أفكار "بلوكتشين-native" مثل @OpenGradient : نظام لامركزي لاستضافة وتشغيل والتحقق من نماذج الذكاء الاصطناعي على السلسلة. الأمر لا يقتصر على إضافة البلوكتشين للذكاء الاصطناعي، بل يتضمن دمجهما بعمق من أجل النسب، ملكية البيانات، والحوافز.
تخيل الفورمولا 1: سيارات تُدفع لحدودها تحت قواعد واضحة، مع بيانات عامة تدفع التقدم الجماعي. هنا، يمكن للنماذج أن "تتسابق" على بنية تحتية مشتركة، مع البلوكتشين الذي يتتبع المساهمات، ويكافئ العمل المفيد، ويتحقق من النتائج.
ما أفهمه هو الجاذبية—مزيد من الشفافية، حوافز أكثر عدلاً، وتقليل الاعتماد على عدد قليل من العملاقين. لكن التحديات حقيقية: استدلال الذكاء الاصطناعي يتطلب طاقة كبيرة؛ لامركزته ينطوي على مخاطر تأخير، هدر الطاقة، والتحقق الصعب للنماذج الكبيرة.
ما هو التبادل؟ المركزية توفر السرعة اليوم، بينما اللامركزية تقدم المرونة لكنها قد تشتت التقدم أو تمكن من أساليب جديدة للعب.
الرؤية الأكبر هي بنية تحتية مفتوحة ومتطورة مع أصول واضحة، مثل المصدر المفتوح القابل للتحقق لكن مع حقوق أقوى. ومع ذلك، السؤال الحقيقي هو ما إذا كان يمكنه سد الفجوة في الأداء مع الأنظمة المركزية بسرعة كافية.
هل يستحق التعقيد؟ أنا متشكك لكنني فضولي. ماذا تعتقد؟
@OpenGradient #OPG $OPG
1
104
·
--
هابط
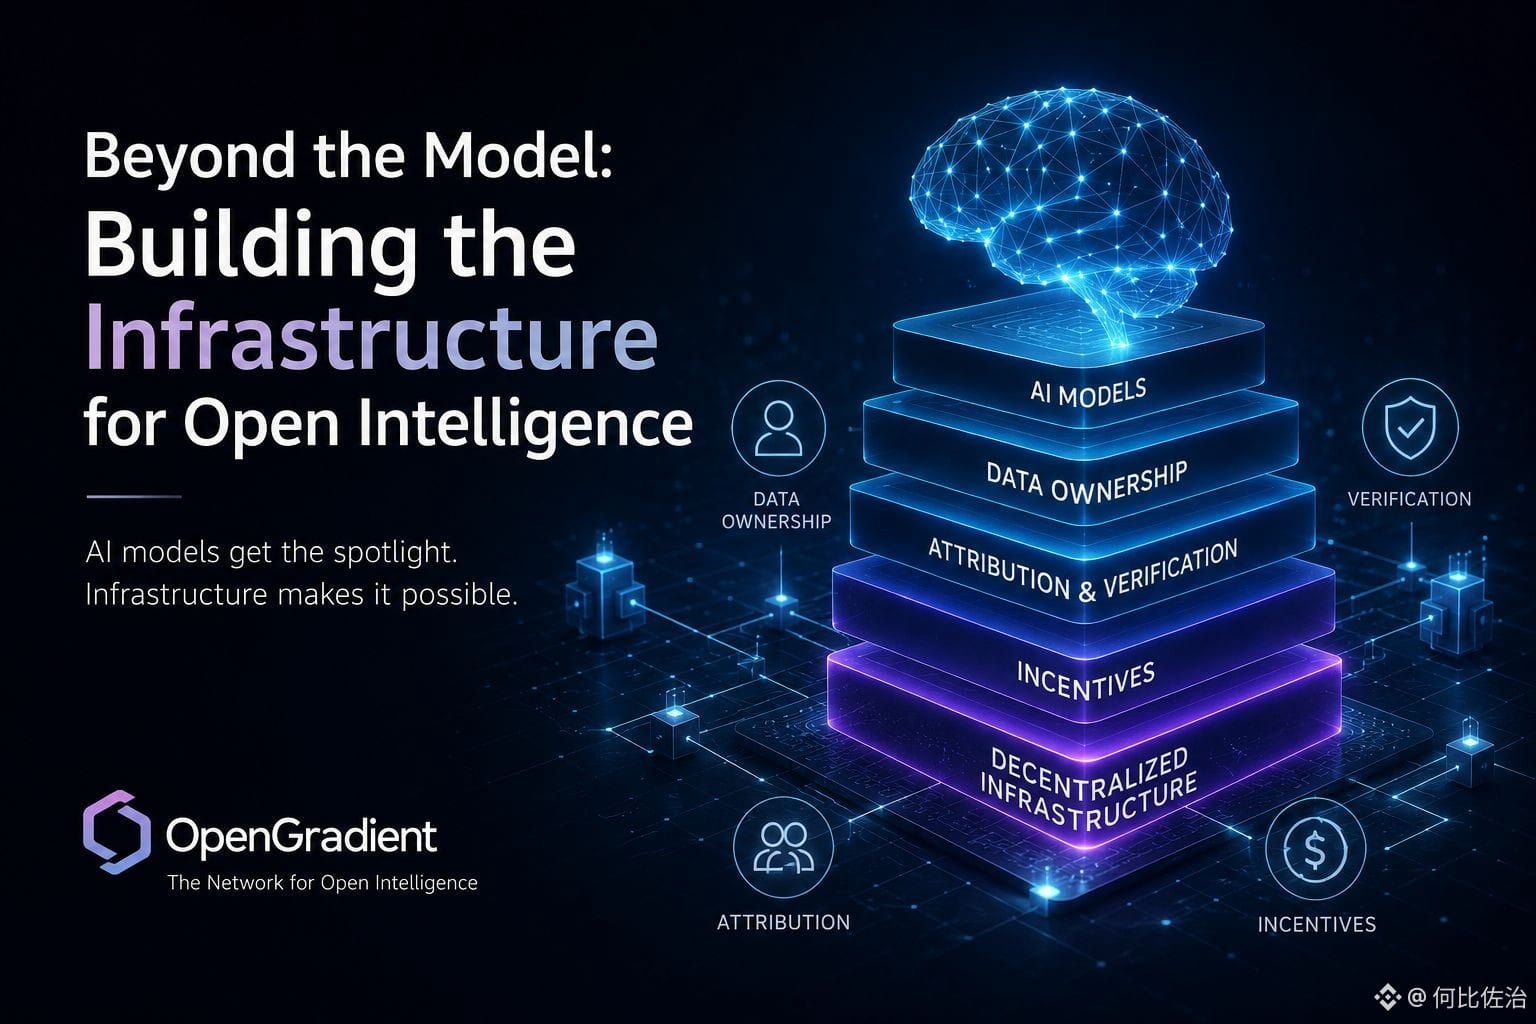
ماذا لو كان مستقبل الذكاء الاصطناعي متشكلاً أكثر من خلال البنية التحتية بدلاً من النماذج؟
أعتقد أن مشاريع مثل @OpenGradient OpenGradient تطرح سؤالاً مثيراً: هل يمكن أن تجعل بلوكتشين حساب الذكاء الاصطناعي، وملكية البيانات، والنسب أكثر شفافية وقابلية للتحقق؟
مثل الفورمولا 1، النجاح ليس فقط حول السائق. المحرك، والتليمتري، وكل الفريق مهمون. في الذكاء الاصطناعي، تحظى النماذج بمعظم الانتباه، لكن البنية التحتية الأساسية غالباً ما تحدد كيف يعمل النظام.
السؤال الحقيقي هو ما إذا كانت بلوكتشين الأصلية للذكاء الاصطناعي يمكن أن تحسن الثقة والشفافية دون إضافة الكثير من التعقيد. الجواب لا يزال غير واضح، لكن مشاريع مثل OpenGradient تساعد في استكشاف كيف يمكن أن يبدو الجيل القادم من بنية الذكاء الاصطناعي.
#OPG
$OPG
{spot}(OPGUSDT)
ماذا لو كان مستقبل الذكاء الاصطناعي متشكلاً أكثر من خلال البنية التحتية بدلاً من النماذج؟
أعتقد أن مشاريع مثل @OpenGradient OpenGradient تطرح سؤالاً مثيراً: هل يمكن أن تجعل بلوكتشين حساب الذكاء الاصطناعي، وملكية البيانات، والنسب أكثر شفافية وقابلية للتحقق؟
مثل الفورمولا 1، النجاح ليس فقط حول السائق. المحرك، والتليمتري، وكل الفريق مهمون. في الذكاء الاصطناعي، تحظى النماذج بمعظم الانتباه، لكن البنية التحتية الأساسية غالباً ما تحدد كيف يعمل النظام.
السؤال الحقيقي هو ما إذا كانت بلوكتشين الأصلية للذكاء الاصطناعي يمكن أن تحسن الثقة والشفافية دون إضافة الكثير من التعقيد. الجواب لا يزال غير واضح، لكن مشاريع مثل OpenGradient تساعد في استكشاف كيف يمكن أن يبدو الجيل القادم من بنية الذكاء الاصطناعي.
#OPG
$OPG
91
·
--
هابط
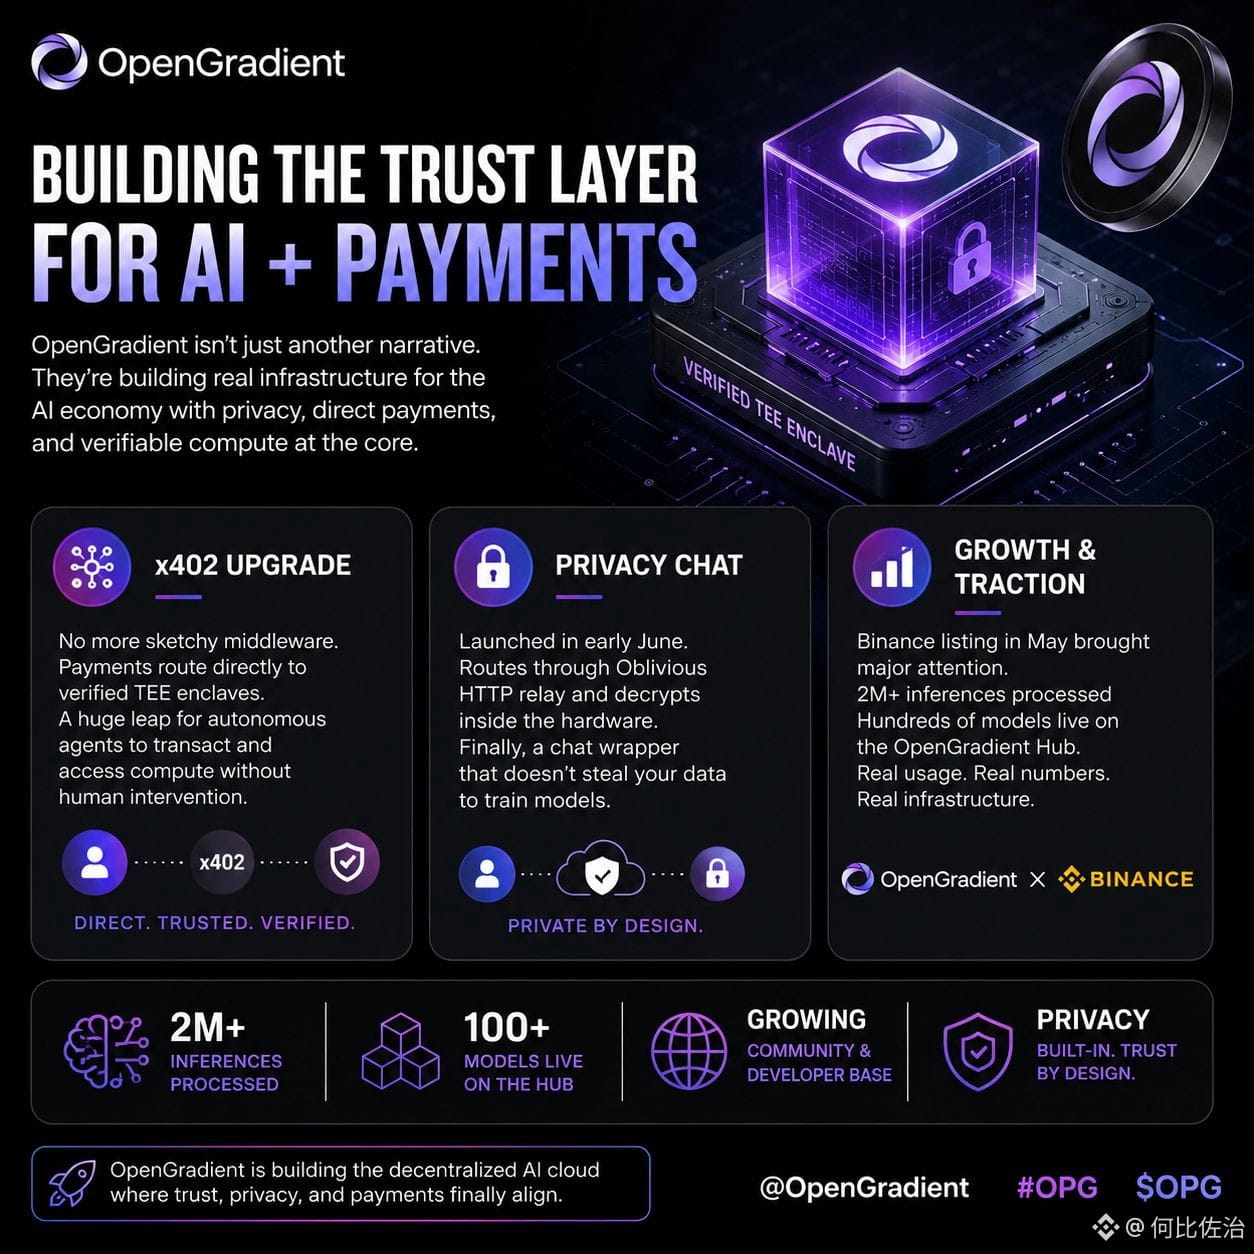
ماذا لو كانت المرحلة التالية من المنافسة في الذكاء الاصطناعي ليست عن بناء نماذج أكبر، بل عن السيطرة على البنية التحتية التي تدعمها؟ هذا هو السؤال الذي كنت أعود إليه أثناء بحثي @OpenGradient
ترقية x402 كانت بارزة لأنها تزيل الاحتكاك بين المدفوعات والحوسبة، مما يسمح للعملاء المستقلين بالتفاعل مباشرة مع مناطق TEE الموثوقة. قد يبدو هذا تقنيًا، لكنه يحل عنق الزجاجة الحقيقي للاقتصادات بين الآلات. يأخذ OpenGradient Chat نهجًا مشابهًا للخصوصية، حيث يجمع بين HTTP غير المرئي مع تنفيذ الأجهزة الآمنة. مع معالجة ملايين الاستدلالات بالفعل، يبدو أن هذا أقل مثل سرد وأكثر مثل بنية تحتية تتشكل بهدوء.
#OPG
$OPG
{future}(OPGUSDT)
ماذا لو كانت المرحلة التالية من المنافسة في الذكاء الاصطناعي ليست عن بناء نماذج أكبر، بل عن السيطرة على البنية التحتية التي تدعمها؟ هذا هو السؤال الذي كنت أعود إليه أثناء بحثي @OpenGradient
ترقية x402 كانت بارزة لأنها تزيل الاحتكاك بين المدفوعات والحوسبة، مما يسمح للعملاء المستقلين بالتفاعل مباشرة مع مناطق TEE الموثوقة. قد يبدو هذا تقنيًا، لكنه يحل عنق الزجاجة الحقيقي للاقتصادات بين الآلات. يأخذ OpenGradient Chat نهجًا مشابهًا للخصوصية، حيث يجمع بين HTTP غير المرئي مع تنفيذ الأجهزة الآمنة. مع معالجة ملايين الاستدلالات بالفعل، يبدو أن هذا أقل مثل سرد وأكثر مثل بنية تحتية تتشكل بهدوء.
#OPG
$OPG
1
2
136
·
--
هابط
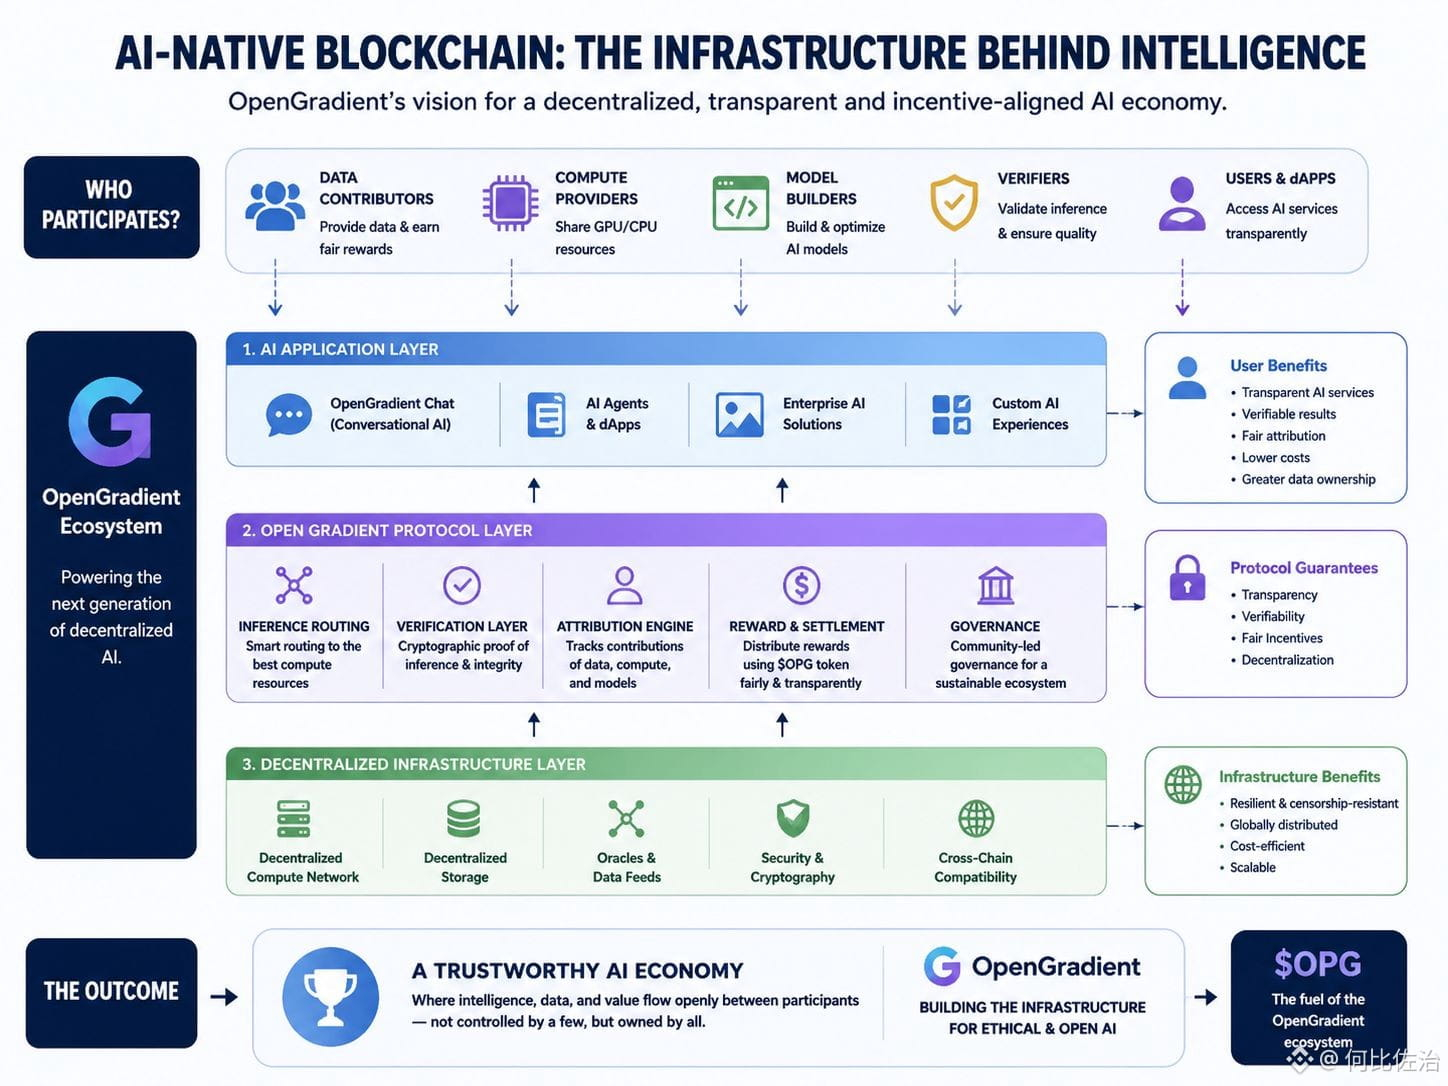
ماذا لو كانت أكبر تحديات الذكاء الاصطناعي ليست في بناء نماذج أذكى، بل في إنشاء نظام موثوق حولها؟
لقد كنت أستكشف @OpenGradient ورؤيتها للذكاء المفتوح. ما يبرز هو التركيز على البنية التحتية بدلاً من مجرد أداء النموذج. من خلال OpenGradient Chat، يمكن أن تصبح التفاعلات مع الذكاء الاصطناعي أكثر شفافية وقابلية للتحقق وتحديد الهوية عبر شبكة لامركزية.
تشبيه مفيد هو سباق الفورمولا 1. سائق السيارة يحصل على الأضواء، لكن النجاح يعتمد على المهندسين وأنظمة القياس والبنية التحتية خلف الكواليس. الذكاء الاصطناعي مشابه. النماذج تجذب الانتباه، لكن البنية التحتية الأساسية غالبًا ما تحدد قابلية التوسع والموثوقية والثقة.
السؤال المثير هو ما إذا كانت الشبكات الذكية اللامركزية يمكن أن توازن بين الشفافية وسهولة الاستخدام. يبدو أن تحديد الهوية والتحقق ومحاذاة الحوافز واعدة، لكن التنفيذ سيكون الاختبار الحقيقي.
مع تطور الذكاء الاصطناعي، أعتقد أن المحادثات ستتحول بشكل متزايد من النماذج وحدها إلى الأنظمة التي تستضيف وتتحقق وتوزع الذكاء. لهذا السبب، مشاريع مثل @OpenGradient تستحق المتابعة.
$OPG #OPG
{spot}(OPGUSDT)
ماذا لو كانت أكبر تحديات الذكاء الاصطناعي ليست في بناء نماذج أذكى، بل في إنشاء نظام موثوق حولها؟
لقد كنت أستكشف @OpenGradient ورؤيتها للذكاء المفتوح. ما يبرز هو التركيز على البنية التحتية بدلاً من مجرد أداء النموذج. من خلال OpenGradient Chat، يمكن أن تصبح التفاعلات مع الذكاء الاصطناعي أكثر شفافية وقابلية للتحقق وتحديد الهوية عبر شبكة لامركزية.
تشبيه مفيد هو سباق الفورمولا 1. سائق السيارة يحصل على الأضواء، لكن النجاح يعتمد على المهندسين وأنظمة القياس والبنية التحتية خلف الكواليس. الذكاء الاصطناعي مشابه. النماذج تجذب الانتباه، لكن البنية التحتية الأساسية غالبًا ما تحدد قابلية التوسع والموثوقية والثقة.
السؤال المثير هو ما إذا كانت الشبكات الذكية اللامركزية يمكن أن توازن بين الشفافية وسهولة الاستخدام. يبدو أن تحديد الهوية والتحقق ومحاذاة الحوافز واعدة، لكن التنفيذ سيكون الاختبار الحقيقي.
مع تطور الذكاء الاصطناعي، أعتقد أن المحادثات ستتحول بشكل متزايد من النماذج وحدها إلى الأنظمة التي تستضيف وتتحقق وتوزع الذكاء. لهذا السبب، مشاريع مثل @OpenGradient تستحق المتابعة.
$OPG #OPG
1
1
124
·
--
صاعد
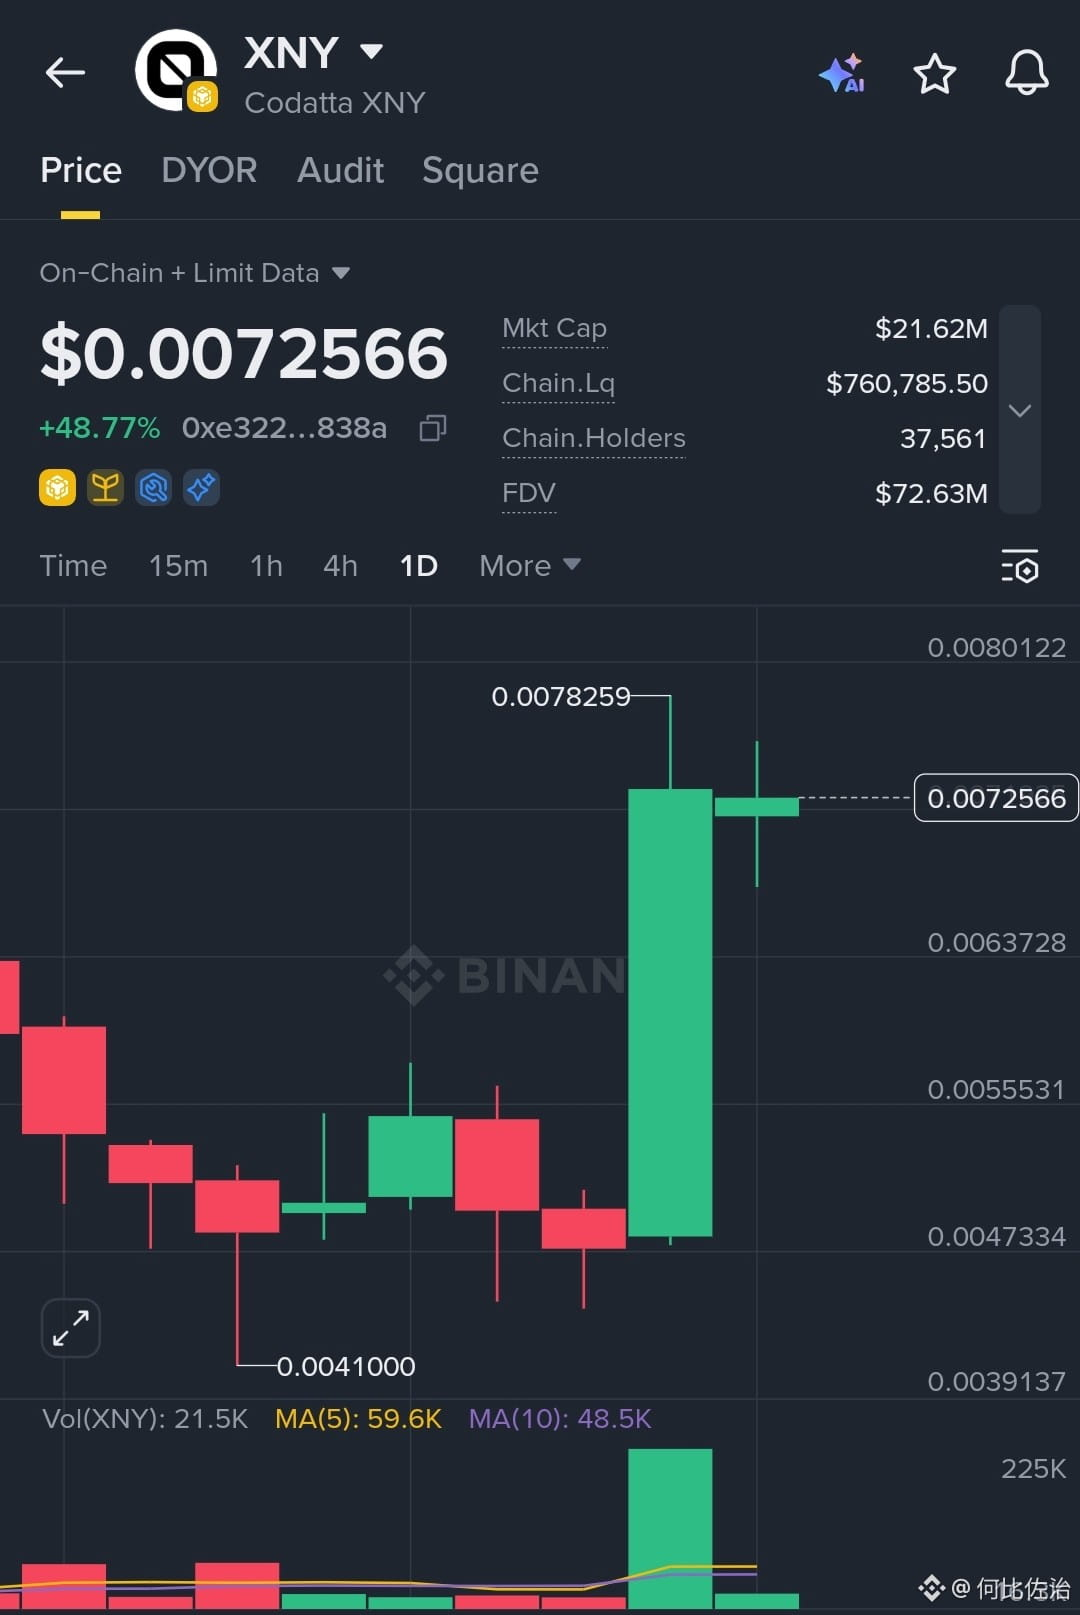
$XNY من بروتوكول بيانات Codatta AI زادت بنسبة تقارب 50%، مما يبرز الاهتمام بملكية البيانات والحقوق الملكية للمبدعين. على المدى القصير، الأمور متقلبة ولكن هناك مجال للتحرك في سياق إيجابي لسير السرد حول الذكاء الاصطناعي. الأفق الأطول يبدو واعدًا إذا تمكنوا من تحويل بيانات المستخدم إلى أصول موحدة.
بالنسبة لـ $XNY:
نقطة الدخول على التراجعات إلى 0.0065.
النقطة المستهدفة 1: 0.009 | النقطة المستهدفة 2: 0.012
أمر وقف الخسارة: 0.0052
#TradebStocks
#WorldCupOpening2026
#TrumpSignalsUSNearIranDeal
{alpha}(560xe3225e11cab122f1a126a28997788e5230838ab9)
$XNY من بروتوكول بيانات Codatta AI زادت بنسبة تقارب 50%، مما يبرز الاهتمام بملكية البيانات والحقوق الملكية للمبدعين. على المدى القصير، الأمور متقلبة ولكن هناك مجال للتحرك في سياق إيجابي لسير السرد حول الذكاء الاصطناعي. الأفق الأطول يبدو واعدًا إذا تمكنوا من تحويل بيانات المستخدم إلى أصول موحدة.
بالنسبة لـ $XNY:
نقطة الدخول على التراجعات إلى 0.0065.
النقطة المستهدفة 1: 0.009 | النقطة المستهدفة 2: 0.012
أمر وقف الخسارة: 0.0052
#TradebStocks
#WorldCupOpening2026
#TrumpSignalsUSNearIranDeal
بالنسبة لـ $XNY:
نقطة الدخول على التراجعات إلى 0.0065.
النقطة المستهدفة 1: 0.009 | النقطة المستهدفة 2: 0.012
أمر وقف الخسارة: 0.0052
#TradebStocks
#WorldCupOpening2026
#TrumpSignalsUSNearIranDeal
143
·
--
صاعد
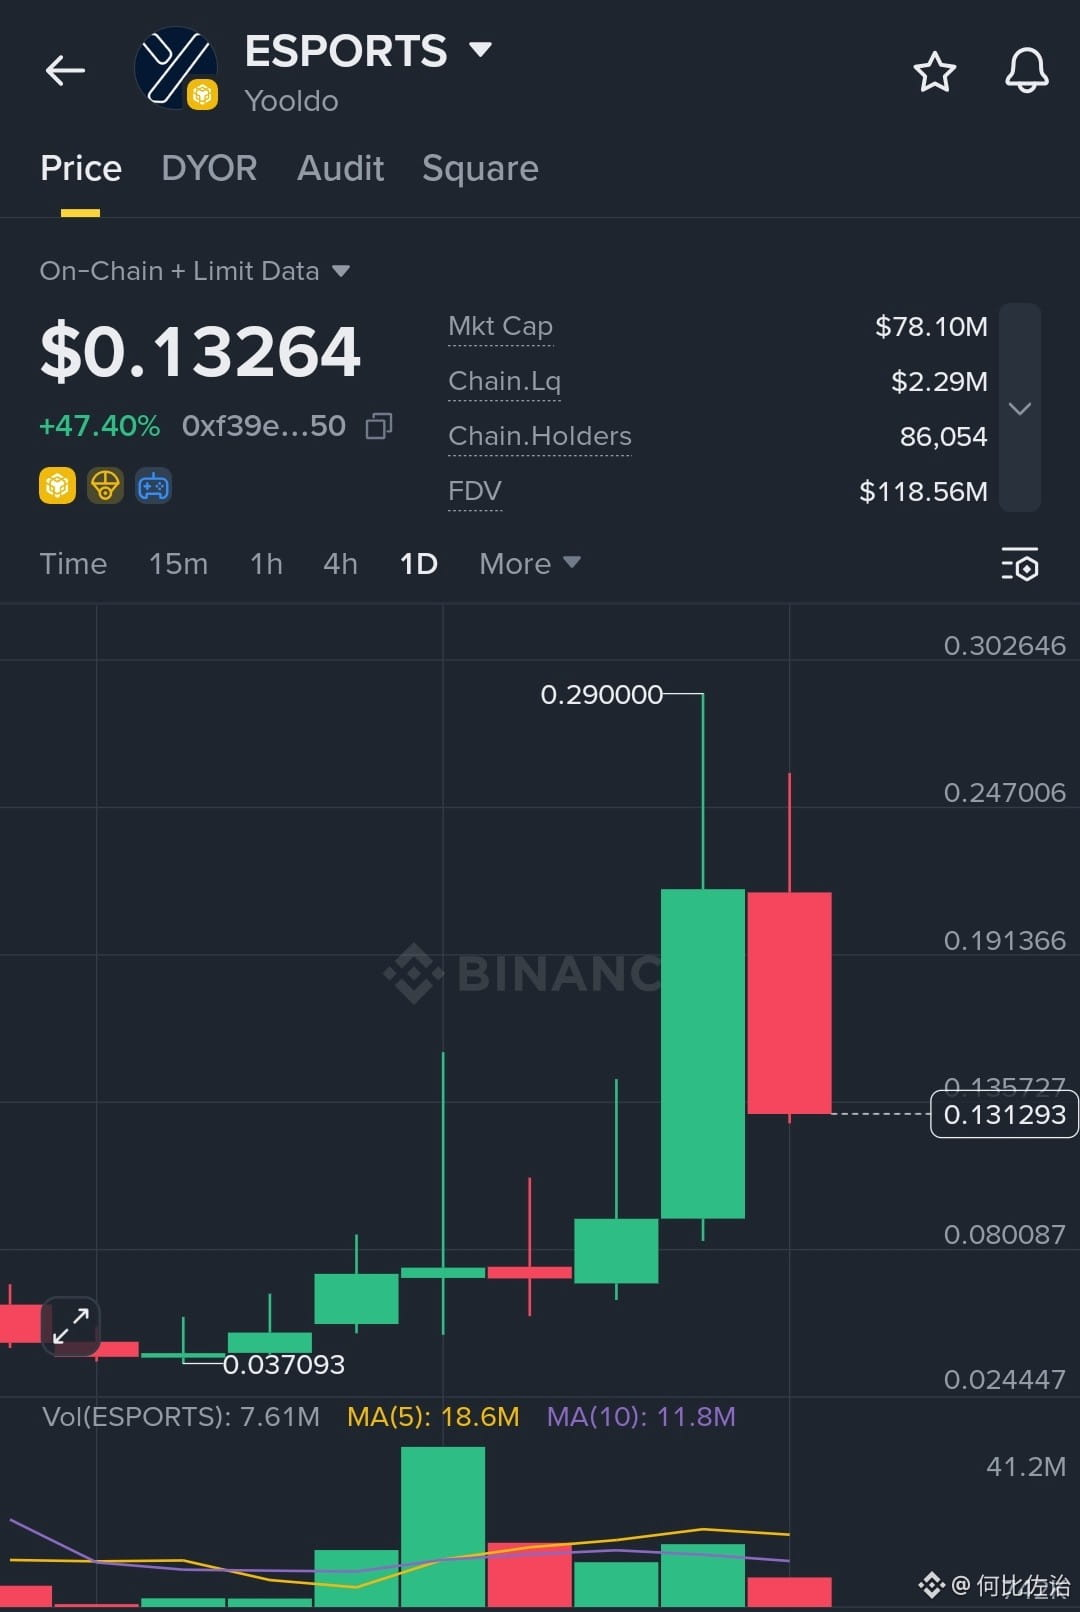
في قطاع الألعاب، $ESPORTS ارتفع بنسبة +50% مع مشاركة قوية. تركيز منصة Yooldo على البطولات القائمة على المهارات، والـ NFTs، والمكافآت الشفافة يضعها في موقع جيد في انتعاش ألعاب Web3. على المدى القصير، تستفيد من تدوير القطاع. على المدى الطويل، يمكن أن يدعم تزايد تفاعل اللاعبين والشراكات اتجاهًا صعوديًا على مدى عدة أرباع.
بالنسبة لـ $ESPORTS:
منطقة EP الحالية.
TP1: 0.18 | TP2: 0.22
SL: 0.105
{alpha}(560xf39e4b21c84e737df08e2c3b32541d856f508e48)
في قطاع الألعاب، $ESPORTS ارتفع بنسبة +50% مع مشاركة قوية. تركيز منصة Yooldo على البطولات القائمة على المهارات، والـ NFTs، والمكافآت الشفافة يضعها في موقع جيد في انتعاش ألعاب Web3. على المدى القصير، تستفيد من تدوير القطاع. على المدى الطويل، يمكن أن يدعم تزايد تفاعل اللاعبين والشراكات اتجاهًا صعوديًا على مدى عدة أرباع.
بالنسبة لـ $ESPORTS :
منطقة EP الحالية.
TP1: 0.18 | TP2: 0.22
SL: 0.105
بالنسبة لـ $ESPORTS :
منطقة EP الحالية.
TP1: 0.18 | TP2: 0.22
SL: 0.105
184
·
--
صاعد
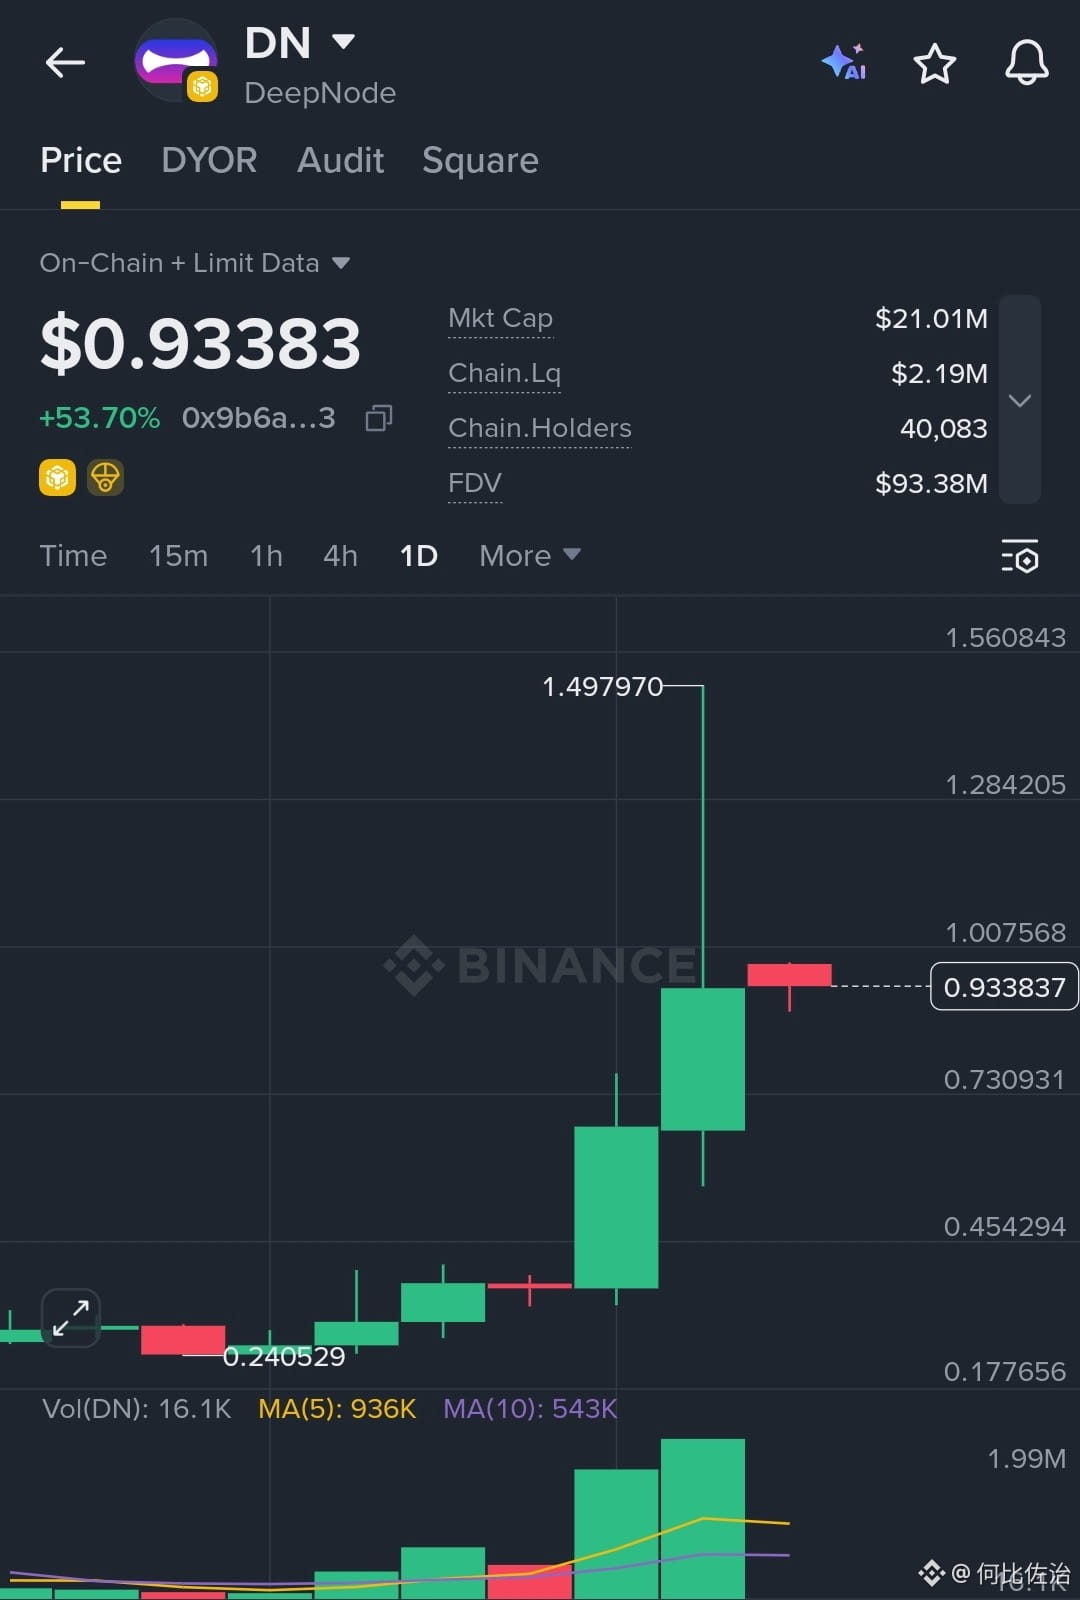
$DN هو متحرك آخر يحقق +53% على حجم تداول معقول. هذا المشروع ينحت مكانه في البنية التحتية اللامركزية. يبدو أن حركة السعر على المدى القريب إيجابية للحصول على مزيد من المكاسب إذا استمر الشعور العام إيجابي. على مدار الأشهر القادمة، سيكون التنفيذ على خارطة الطريق الخاصة بهم مفتاحًا للحفاظ على المكاسب.
بالنسبة لـ $DN:
EP عند الانخفاضات نحو 0.85.
TP1: 1.15 | TP2: 1.45
SL: 0.72
#SPCXxIPOCampaignOnBinanceWallet
#TrumpSignalsUSNearIranDeal
#WorldCupOpening2026
$DN هو متحرك آخر يحقق +53% على حجم تداول معقول. هذا المشروع ينحت مكانه في البنية التحتية اللامركزية. يبدو أن حركة السعر على المدى القريب إيجابية للحصول على مزيد من المكاسب إذا استمر الشعور العام إيجابي. على مدار الأشهر القادمة، سيكون التنفيذ على خارطة الطريق الخاصة بهم مفتاحًا للحفاظ على المكاسب.
بالنسبة لـ $DN :
EP عند الانخفاضات نحو 0.85.
TP1: 1.15 | TP2: 1.45
SL: 0.72
#SPCXxIPOCampaignOnBinanceWallet
#TrumpSignalsUSNearIranDeal
#WorldCupOpening2026
بالنسبة لـ $DN :
EP عند الانخفاضات نحو 0.85.
TP1: 1.15 | TP2: 1.45
SL: 0.72
#SPCXxIPOCampaignOnBinanceWallet
#TrumpSignalsUSNearIranDeal
#WorldCupOpening2026
317
·
--
صاعد
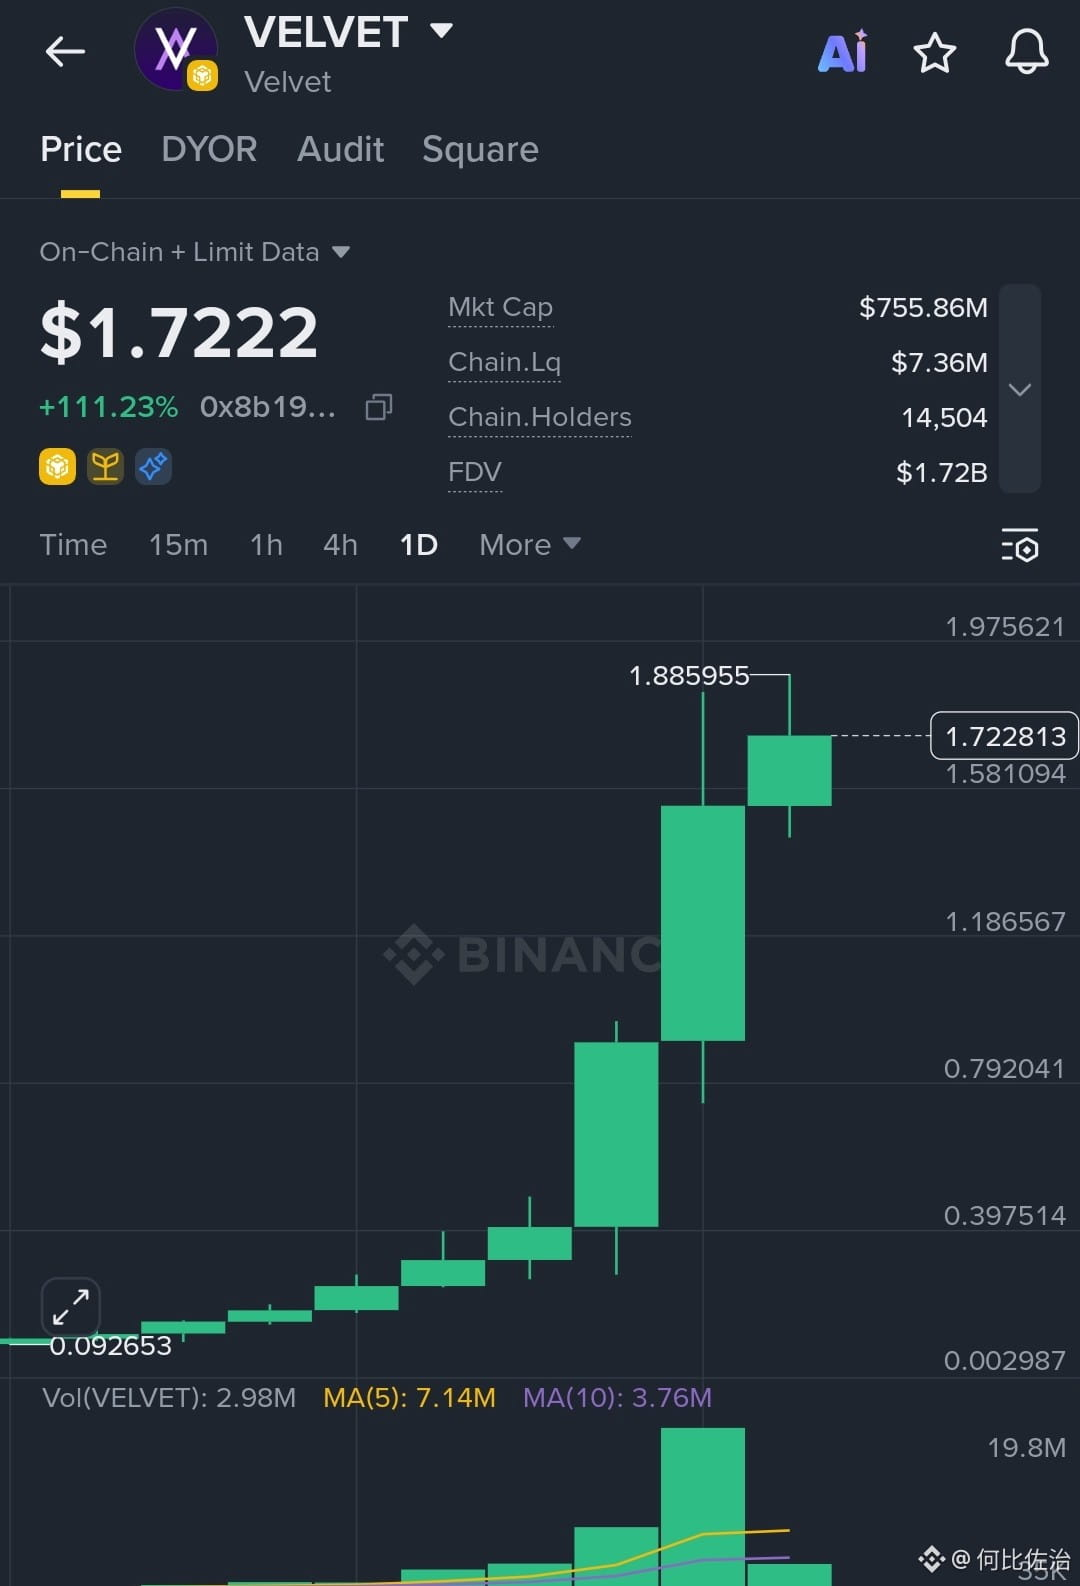
$VELVET يبرز بارتفاعه المذهل +110% وحجم تداول قوي قدره 21 مليون دولار. كنظام تشغيل DeFi من الجيل التالي يركز على أدوات متكاملة ومتعددة السلاسل وميزات مدفوعة بالذكاء الاصطناعي، فإنه يجذب اهتماماً حقيقياً في الاستخدام. على المدى القصير، لا يزال الزخم صعودياً فوق المستويات الحالية مع إمكانية الاستمرار إذا احتفظ بالاختراق الأخير. على المدى الطويل، يمكن أن يؤدي الاعتماد الناجح على خزائنه وحوكته إلى دفع إعادة تقييم مهمة مع توسع نشاط DeFi.
بالنسبة لـ $VELVET:
EP حول المستويات الحالية.
TP1: 2.15-2.30 | TP2: 2.80+
SL: 1.45
#TradebStocks
#WorldCupOpening2026
#TrumpSignalsUSNearIranDeal
$VELVET يبرز بارتفاعه المذهل +110% وحجم تداول قوي قدره 21 مليون دولار. كنظام تشغيل DeFi من الجيل التالي يركز على أدوات متكاملة ومتعددة السلاسل وميزات مدفوعة بالذكاء الاصطناعي، فإنه يجذب اهتماماً حقيقياً في الاستخدام. على المدى القصير، لا يزال الزخم صعودياً فوق المستويات الحالية مع إمكانية الاستمرار إذا احتفظ بالاختراق الأخير. على المدى الطويل، يمكن أن يؤدي الاعتماد الناجح على خزائنه وحوكته إلى دفع إعادة تقييم مهمة مع توسع نشاط DeFi.
بالنسبة لـ $VELVET :
EP حول المستويات الحالية.
TP1: 2.15-2.30 | TP2: 2.80+
SL: 1.45
#TradebStocks
#WorldCupOpening2026
#TrumpSignalsUSNearIranDeal
بالنسبة لـ $VELVET :
EP حول المستويات الحالية.
TP1: 2.15-2.30 | TP2: 2.80+
SL: 1.45
#TradebStocks
#WorldCupOpening2026
#TrumpSignalsUSNearIranDeal
377
·
--
🎙️ لنشارك في بناء ساحة بينانس|يوم الجمعة، السوق لا يزال في كندل أخضر، هل هناك صفقات شورت؟ دعونا نتحدث
إنهاء
04 ساعة 47 دقيقة 18 ثانية
7.1k
32
35
·
--
صاعد
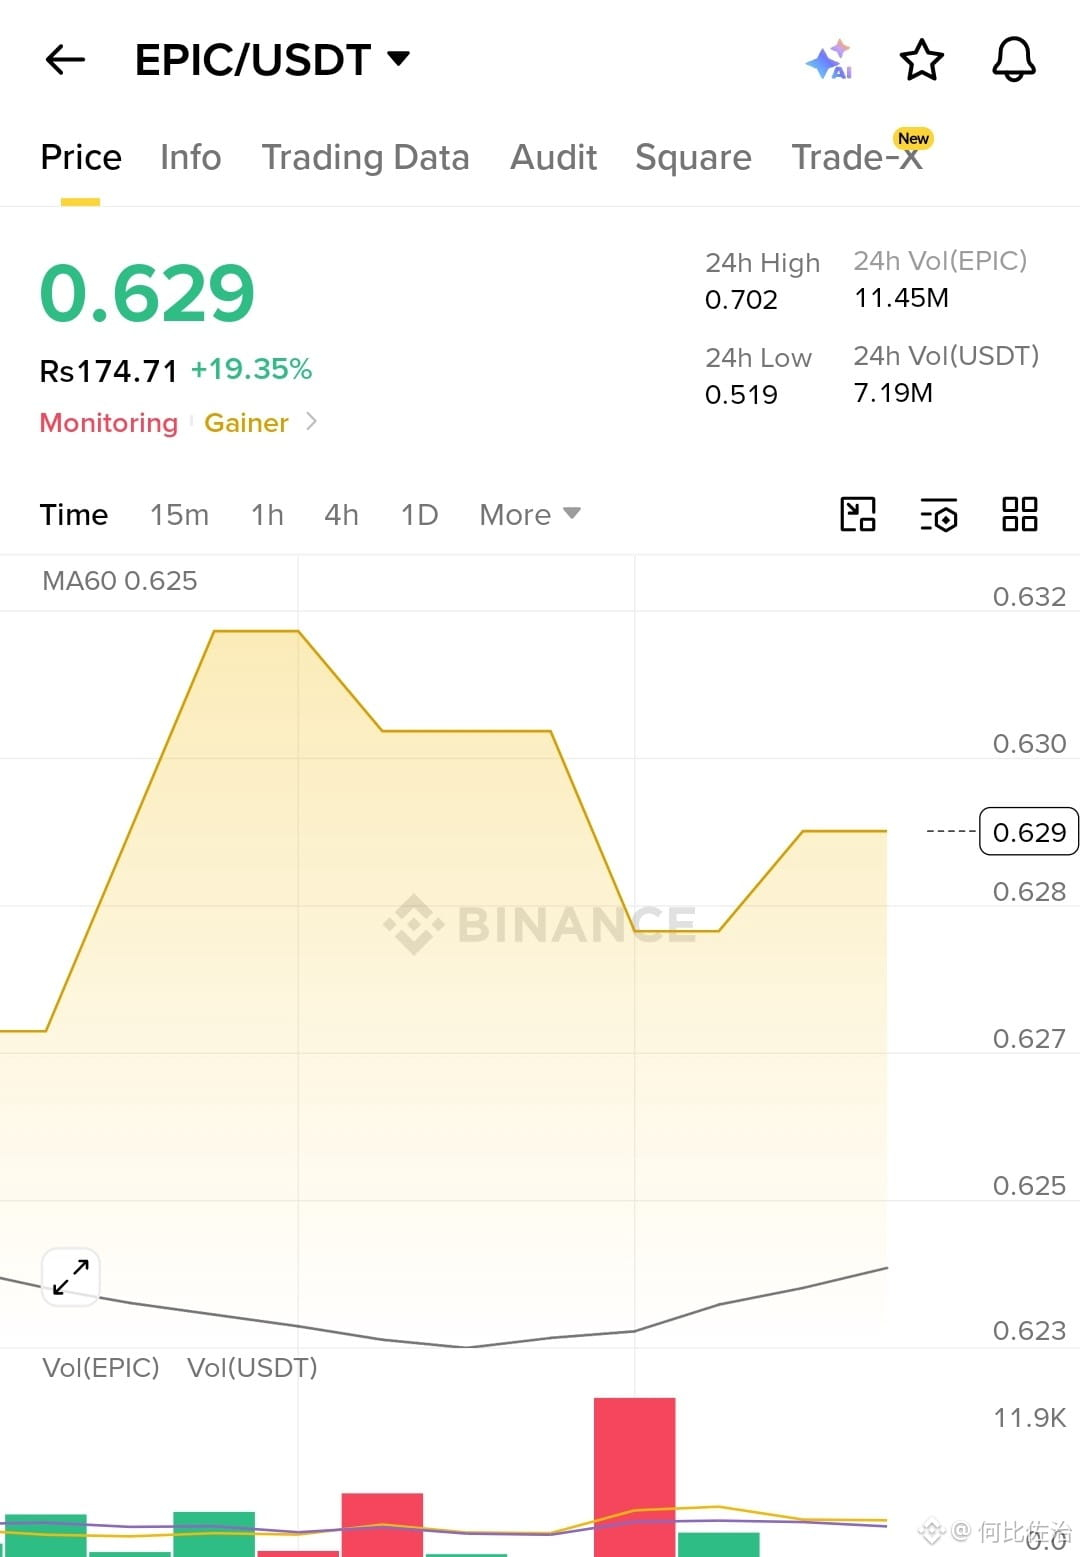
$EPIC يعرض قوة نسبية قوية مقارنة بالعديد من الأصول المتوسطة. حجم تداول مستمر يمكن أن يدعم مزيد من الارتفاع في الجلسات القادمة.
EP: 0.6100 - 0.6300
TP: 0.7000 - 0.7600
SL: 0.5750
#TradebStocks
#SPCXxIPOCampaignOnBinanceWallet
#WorldCupOpening2026
{spot}(EPICUSDT)
$EPIC يعرض قوة نسبية قوية مقارنة بالعديد من الأصول المتوسطة. حجم تداول مستمر يمكن أن يدعم مزيد من الارتفاع في الجلسات القادمة.
EP: 0.6100 - 0.6300
TP: 0.7000 - 0.7600
SL: 0.5750
#TradebStocks
#SPCXxIPOCampaignOnBinanceWallet
#WorldCupOpening2026
EP: 0.6100 - 0.6300
TP: 0.7000 - 0.7600
SL: 0.5750
#TradebStocks
#SPCXxIPOCampaignOnBinanceWallet
#WorldCupOpening2026
112
·
--
صاعد
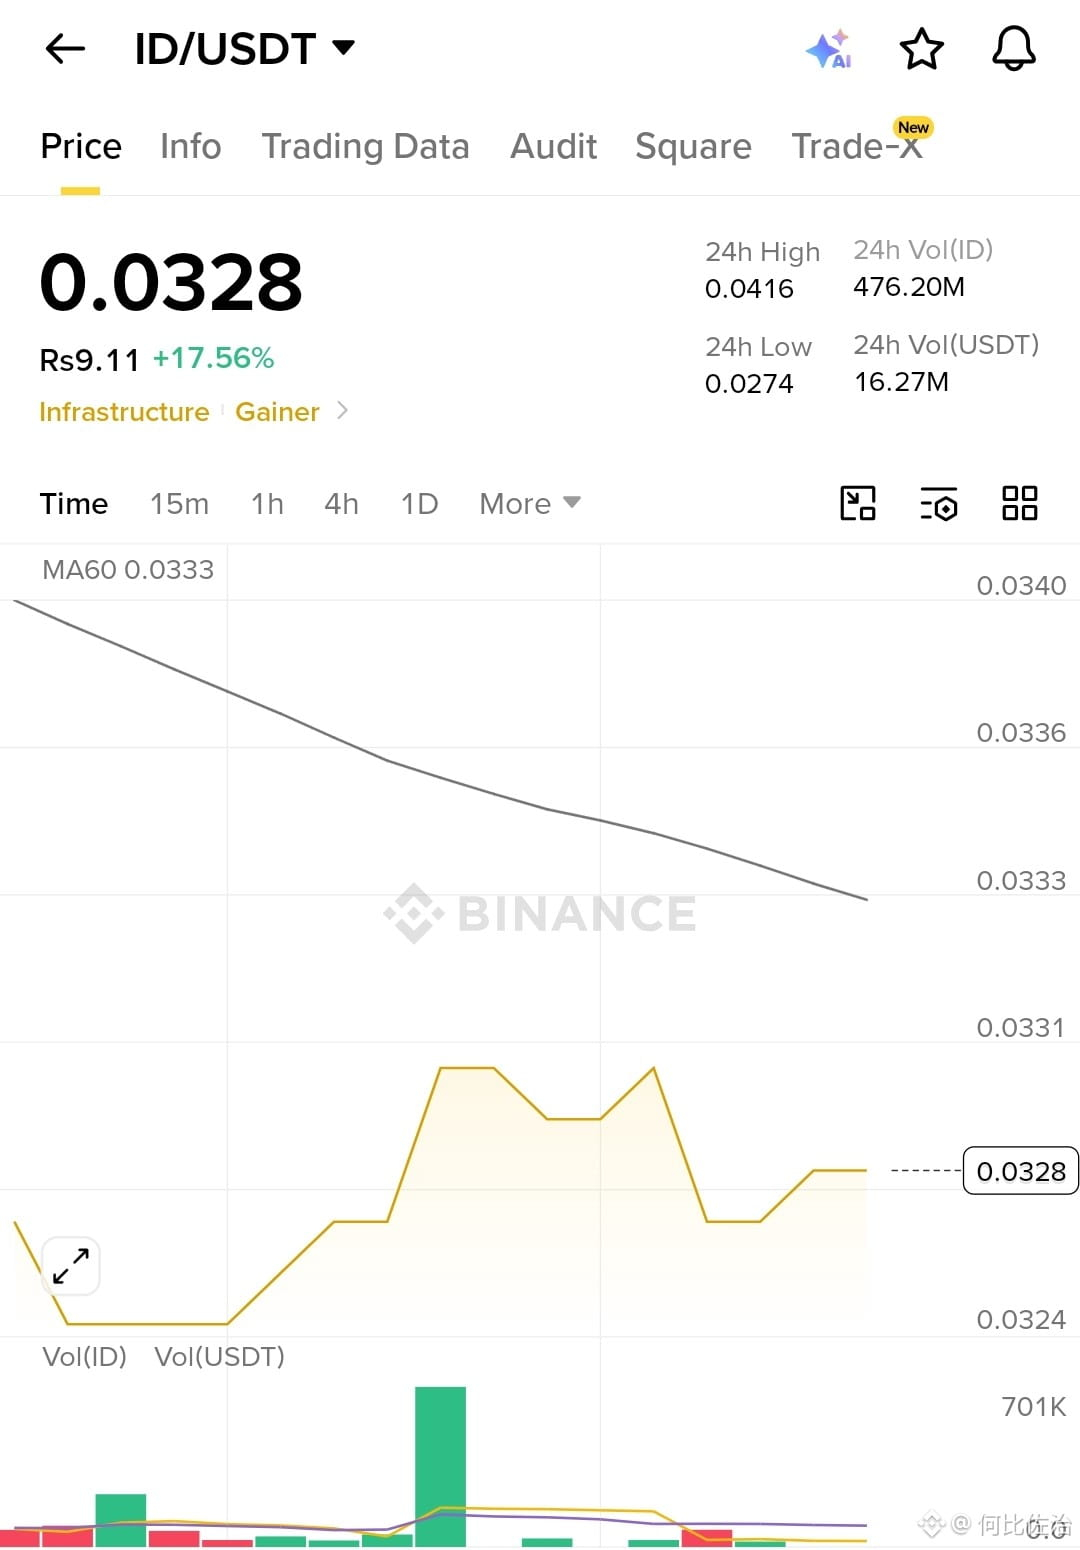
$ID لا يزال جذابًا بعد مرحلة التوسع الأخيرة. التماسك فوق مستوى الدعم يمكن أن يوفر الأساس لارتفاع آخر.
EP: 0.0315 - 0.0330
TP: 0.0370 - 0.0410
SL: 0.0290
#ECBFirstRateHikeSince2023
#USMayPPIRises65PctYoY
#MetaHaltsManusDataAccessInUnwind
{spot}(IDUSDT)
$ID لا يزال جذابًا بعد مرحلة التوسع الأخيرة. التماسك فوق مستوى الدعم يمكن أن يوفر الأساس لارتفاع آخر.
EP: 0.0315 - 0.0330
TP: 0.0370 - 0.0410
SL: 0.0290
#ECBFirstRateHikeSince2023
#USMayPPIRises65PctYoY
#MetaHaltsManusDataAccessInUnwind
EP: 0.0315 - 0.0330
TP: 0.0370 - 0.0410
SL: 0.0290
#ECBFirstRateHikeSince2023
#USMayPPIRises65PctYoY
#MetaHaltsManusDataAccessInUnwind
181
سجّل الدخول لاستكشاف المزيد من المُحتوى
انضم إلى مُستخدمي العملات الرقمية حول العالم على Binance Square
⚡️ احصل على أحدث المعلومات المفيدة عن العملات الرقمية.
💬 موثوقة من قبل أكبر منصّة لتداول العملات الرقمية في العالم.
👍 اكتشف الرؤى الحقيقية من صنّاع المُحتوى الموثوقين.
البريد الإلكتروني / رقم الهاتف
المواضيع الرائجة
UKFCAWinsCourtOrderToRecover851400Pounds
6,264 مشاهدات
426 يقومون بالنقاش
#UKFCAWinsCourtOrderToRecover851400Pounds
#UKFCAWinsCourtOrderToRecover851400Pounds
هيئة الرقابة المالية البريطانية FCA تفوز بأمر قضائي لاسترداد 851400 باوند
في انتصار كبير للعدالة المالية في بريطانيا
التفاصيل الكاملة
المحتال جون بيرفورد 86 سنة عالم سابق في ناسا
نصب على اكثر من 100 مستثمر بمبلغ مليون باوند
عرض صناديق استثمار وهمية بدون ترخيص من FCA
اخفى الخسائر واستخدم اموال الناس لشراء منزل لنفسه
حكم عليه بالسجن سنتين في سبتمبر 2025
قرار المحكمة الجديد
محكمة Southwark في لندن امرت بدفع 655951.40 باوند
هذا المبلغ هو كل الاصول القابلة للاسترداد
الاموال ستعود مباشرة للضحايا
مع المدفوعات السابقة سيسترد الضحايا 99% من اموالهم
اذا لم يدفع خلال 3 اشهر سيضاف 5 سنوات سجن اضافية
رسالة FCA
قال ستيف سمارت مدير التنفيذ في FCA
السيد بيرفورد احتال على المستثمرين لتمويل اسلوب حياته الفاخر
استرداد الاموال المسروقة واعادتها للضحايا يرسل رسالة واضحة ان الجريمة لا تفيد
هذا يثبت قوة القانون البريطاني في حماية المستثمرين
#UKFCAWinsCourtOrderToRecover851400Pounds #UKFCA #بريطانيا #FCA #BinanceSquare
Mohammed _crypto sniper
·1 إعجاب
·49 مشاهدات
ChainlinkLaunchesCCIP2WithEnterpriseVerification
19,134 مشاهدات
683 يقومون بالنقاش
GoldFallsTo$4144
7,692 مشاهدات
114 يقومون بالنقاش