

接前面兩篇關於程序化交易實盤注意事項的文章:
硬核乾貨 - 量化交易系統的自動化實盤細節與思考(一 問題與難點)
量化交易系統 - 自動化實盤細節與思考(二 實盤宗旨)
這裏再繼續說說一些代碼設計上的細節處理技巧。
數據庫
前兩篇講過,複雜一點的策略組合的狀態記錄很重要,需要用到數據庫。
其實,大多數編程業務都可以被歸納爲 CRUD 類別,也就是核心流程就是對數據庫的增刪改查罷了。交易代碼也不例外。中低頻的二級市場交易行爲,其實和大家去某寶購物區別不大,都是買賣,自動化交易的實現重點就在對策略狀態的管理上。
如果你不是已經用熟了 SQL 這種關係型數據庫,那麼建議你直接學習使用 Redis 這類 NoSQL 內存性數據庫。它的優點就是上手簡單,性能卓越,天生單線程,不用去考慮讀寫的時候需要鎖住數據之類的底層操作。不過缺點就是沒有主鍵,不能自動實現編號自增之類的功能。需要的話,得自己寫代碼實現。不過這個功能,我自己從事自動化交易這麼久時間,也沒有怎麼用到過。
還有一個不重要的問題就是,內存數據庫,如果需要存的數據量比較大的話,那麼服務器內存就得大一點,不過一般的量化交易實盤,4G,甚至 2G 內存都已經足夠了,用不着保存那麼多數據。
Redis 在實盤中的功能真的很強大,如果你的策略有一點高頻的需求,它還能實現 pub/sub 的消息訂閱模式,用不着再加入額外的各種 MQ 模塊。如果使用 MySQL 這種關係型數據庫,就像前面提到的那樣,只要不是之前已經上手實戰過了,那麼就得再投入時間精力學習一門比較噁心難懂的編程語言 SQL。注意,大家是來做量化交易的,不是來學習寫代碼的,儘量採用簡單一點的方案。
另外,如果要做行情中心,考慮到性能,也是採用 Redis 數據庫,再配合消息隊列方便。方案簡單,適用絕大多數場景。一臺服務器(或者多臺)都能用上。
代碼設計
基本上,寫代碼,核心數據結構最重要。數據結構設計不夠合理,代碼會怎麼寫怎麼彆扭,因爲會導致各個模塊之間無法避免地耦合在一起,修改起來很麻煩。但是要設計合理,就得有點交易經驗了,也就是業務經驗。這些都是關於怎麼寫代碼的了,沒啥說頭。每個人的策略也不一樣,不能等同對待。不過,有些道理大概是相通的。
舉個例子,單子提交之後,是不能保證成功的,就算是市價單也一樣,因爲有可能被交易所拒絕。例如交易所太忙,或者臨時網絡數據掉包之類。那麼,最好設計一些二階段提交(2 Phase Commit)類似的中間態,不成功就一直 try(當然不能太高頻率,不然超過限制被 ban,有專門 retry decorator 幹這事),或者再加入多次矯正錯誤狀態的方法。
一般情況下,就算交易所宕機了,短時間都會恢復。不恢復,那麼總有一方是完全掛了,不是交易所,就是你自己的代碼服務器。這點得做好監控,告警。自動化代碼是不可能面面俱到的,真不能自動處理了就發出告警,人工介入吧。人工沒有及時處理,只要不繼續開倉增加敞口,問題就不會太大,因爲還有算法止損單兜底。
下面是我自己梳理的一個策略開倉邏輯:
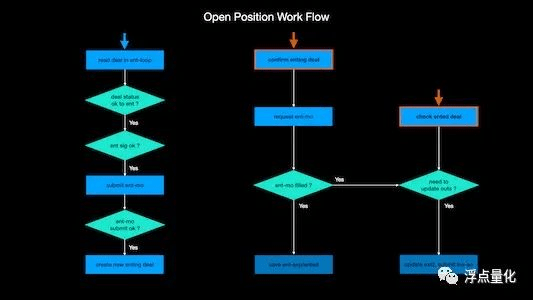
基本上,畫一個類似的流程圖,代碼寫起來就會有條理得多,潛在 bug 也會減少。所以,寫代碼前,最好先畫流程圖,或者邊寫邊梳理,這樣纔會邏輯清晰,心中有數。
關倉邏輯比這個複雜很多,因爲關倉的條件也多一些,止盈止損,各種策略退場信號,都會觸發平倉。總之,出場的重要性是高於入場的,實盤上也麻煩一點。
因爲大家策略邏輯肯定不一樣,這裏也就不多說了。主要就是理順你的策略邏輯,防止各種可能錯誤的發生。
但是,這些也就看着複雜而已,不過都是一堆 if else 罷了(Python 連 switch 語句都沒有)。符合條件,就進行下一步,不行就退出,沒啥大的問題。
時間控制
做交易,時間點的掌握毫無疑問非常重要。這裏再分享一點我的時間控制技巧。
一般編程,如果有需要定時執行的任務,那麼通常採用諸如 apscheduler 這樣的 cron job package。例如計劃整點時刻一到就檢測 k 線價格是否需要開倉、關倉的定時任務。
這種包其實就是在設定的時間(可以精確到秒級),立馬新開一個線程,然後執行指定的任務,問題就是如果這個任務執行時間太長,那麼下一個任務又接着開始,這時就會有問題,雖然可以解決,但是比較麻煩。
我一般是在需要定時輸出 log 信息,程序自糾自檢的時候使用這樣的定時任務,也就是一些低頻而又可以快速完成的功能。這些功能都是對數據庫裏的數據只讀,沒有寫、更新操作,所以讓 apscheduler 另開線程處理也無妨。
然而,那種需要不斷較高頻率查詢市場價格,或者本地策略狀態的邏輯,就不適合這樣的定時包,需要採用 while 循環來控制。
比如策略使用了 k 線的 bar 內信號,就意味着信號可能隨時會出現,就需要不停地檢查標的價格或者交易量,判斷是否需要執行相應的操作。如果這個時候你還需要比較精確的時間控制,例如只在 k 線整點結束前 10 秒才執行開倉的系列邏輯。那麼如何簡單判斷是最後 10 秒呢?
我是通過使用時間 timestamp 對 3600 取餘數。
(如果你不熟悉計算機上的 timestamp,也就是時間戳,它是從格林威治標準時間 1970.1.1 開始算起,比如現在大概是第 1691240298 秒,電腦上準確到微秒級都沒有問題。)
對 3600 取餘之後,如果餘數大於 3590 秒就是最後十秒了。誤差可以到毫秒級別。之前講過,主要交易操作最好是在一個線程裏,順序執行,那麼就可以通過這樣的方式來大致控制執行的時間,或者模糊一點,時間段,這樣就更沒問題了。
這種控制,需要你自己服務器的時間設置與標準時間誤差不大就行。不過這種控制也不會非常精確,只能到秒級吧。但是 Python 裏本來就不能非常精確控制時間,那些 sleep 函數都會導致大概微秒級誤差的。
減少 API 訪問頻率
如果已經採用了基於 websocket 的獨立行情中心,在不同策略,甚至不同交易代碼之間共享 k 線這類市場公開信息,那麼在這方面就沒有 API 頻率限制的顧慮。
但是我們還需要及時獲取賬戶信息,也就是資金、倉位、訂單這三類信息。賬戶信息雖然也可以使用 websocket,等待交易所服務器主動推送過來,但是,因爲三點原因,還是直接採用 rest api 比較簡單一點。
第一,websocket 推送的賬戶信息,交易所爲了減輕負擔,要求每隔一段時間就得重新鏈接或者更新 listenKey(幣安是60分鐘)。這種情況顯然維護比較麻煩。雖然也沒有麻煩多少,但是如果做了 API 託管,同時交易多個賬戶,那麼就得又啓用單獨的程序來保證信息的即時準確,邏輯複雜了不少。
第二,有的交易所並沒有賬戶信息更新的 websocket 推送,這樣的話,交易邏輯不通用,實盤代碼在不同交易所之間切換更麻煩。當然,一般人不會交易多個交易所,碰不到這樣的情況。
第三,websocket 如果鏈接斷了,或者遇到前面講的 listenKey 更新,或者到期之類的問題,如果程序沒有及時發現,而這個時候恰好又有交易,那麼如果僅僅依賴 websocket,就會造成比較大的問題,因爲錯過的賬戶更新信息不會再次推送。要規避這類潛在問題發生的可能性,也得依賴 rest api 獲取確定的賬戶信息。那麼最後總得依賴 rest api,豈不是多此一舉?
綜上,對於中低頻交易,還不如直接採用 rest api 獲取賬戶信息。重要數據源,最好奉行 SSOT(Single Source Of Truth 可信單一數據源),不然可能造成潛在混亂,這個概念可以自行谷歌,在依靠數據處理的編程中非常有用。
那麼,如果只採用 rest api 獲取賬戶信息,可以在本地代碼內存裏維護一個臨時賬戶信息表,特別是可用資金,這樣可以減少頻繁訪問交易所,關鍵是快,可以把單子一次性都發出去,類似批量下單,然後再慢慢處理更新後面的邏輯,下單快了,滑點自然就小一點。
另外,要判斷算法止損單是否成交,可以使用近期的 high low 價格,而不是直接去獲取掛單的狀態,因爲判斷單子是否成交,需要不斷去 poll,比較頻繁,會造成很多無效 api 訪問。而 websocket 的 k 線價格更新是非常及時的,而且不佔用 api 頻率限制。
同理,一些退場單子也可以如此。如果你的退場信號是依靠 bar 內的價格,那麼採用近期 high low 價格可能更好。因爲有的時候價格觸發了,又會立即迴歸,如果你的檢查頻率不是太高,那麼就有可能錯過。爲了保證交易策略的一致性,檢查 high low 這樣的價格就不會錯過。這樣處理還有額外好處,就是實際成交價格可能會更有利,相比於真正的觸發價格。
不知道上面兩點容不容易理解。可能需要一點實盤經驗纔行。
分享一點自己實盤代碼開發中的心得體會,希望對大家有所幫助。