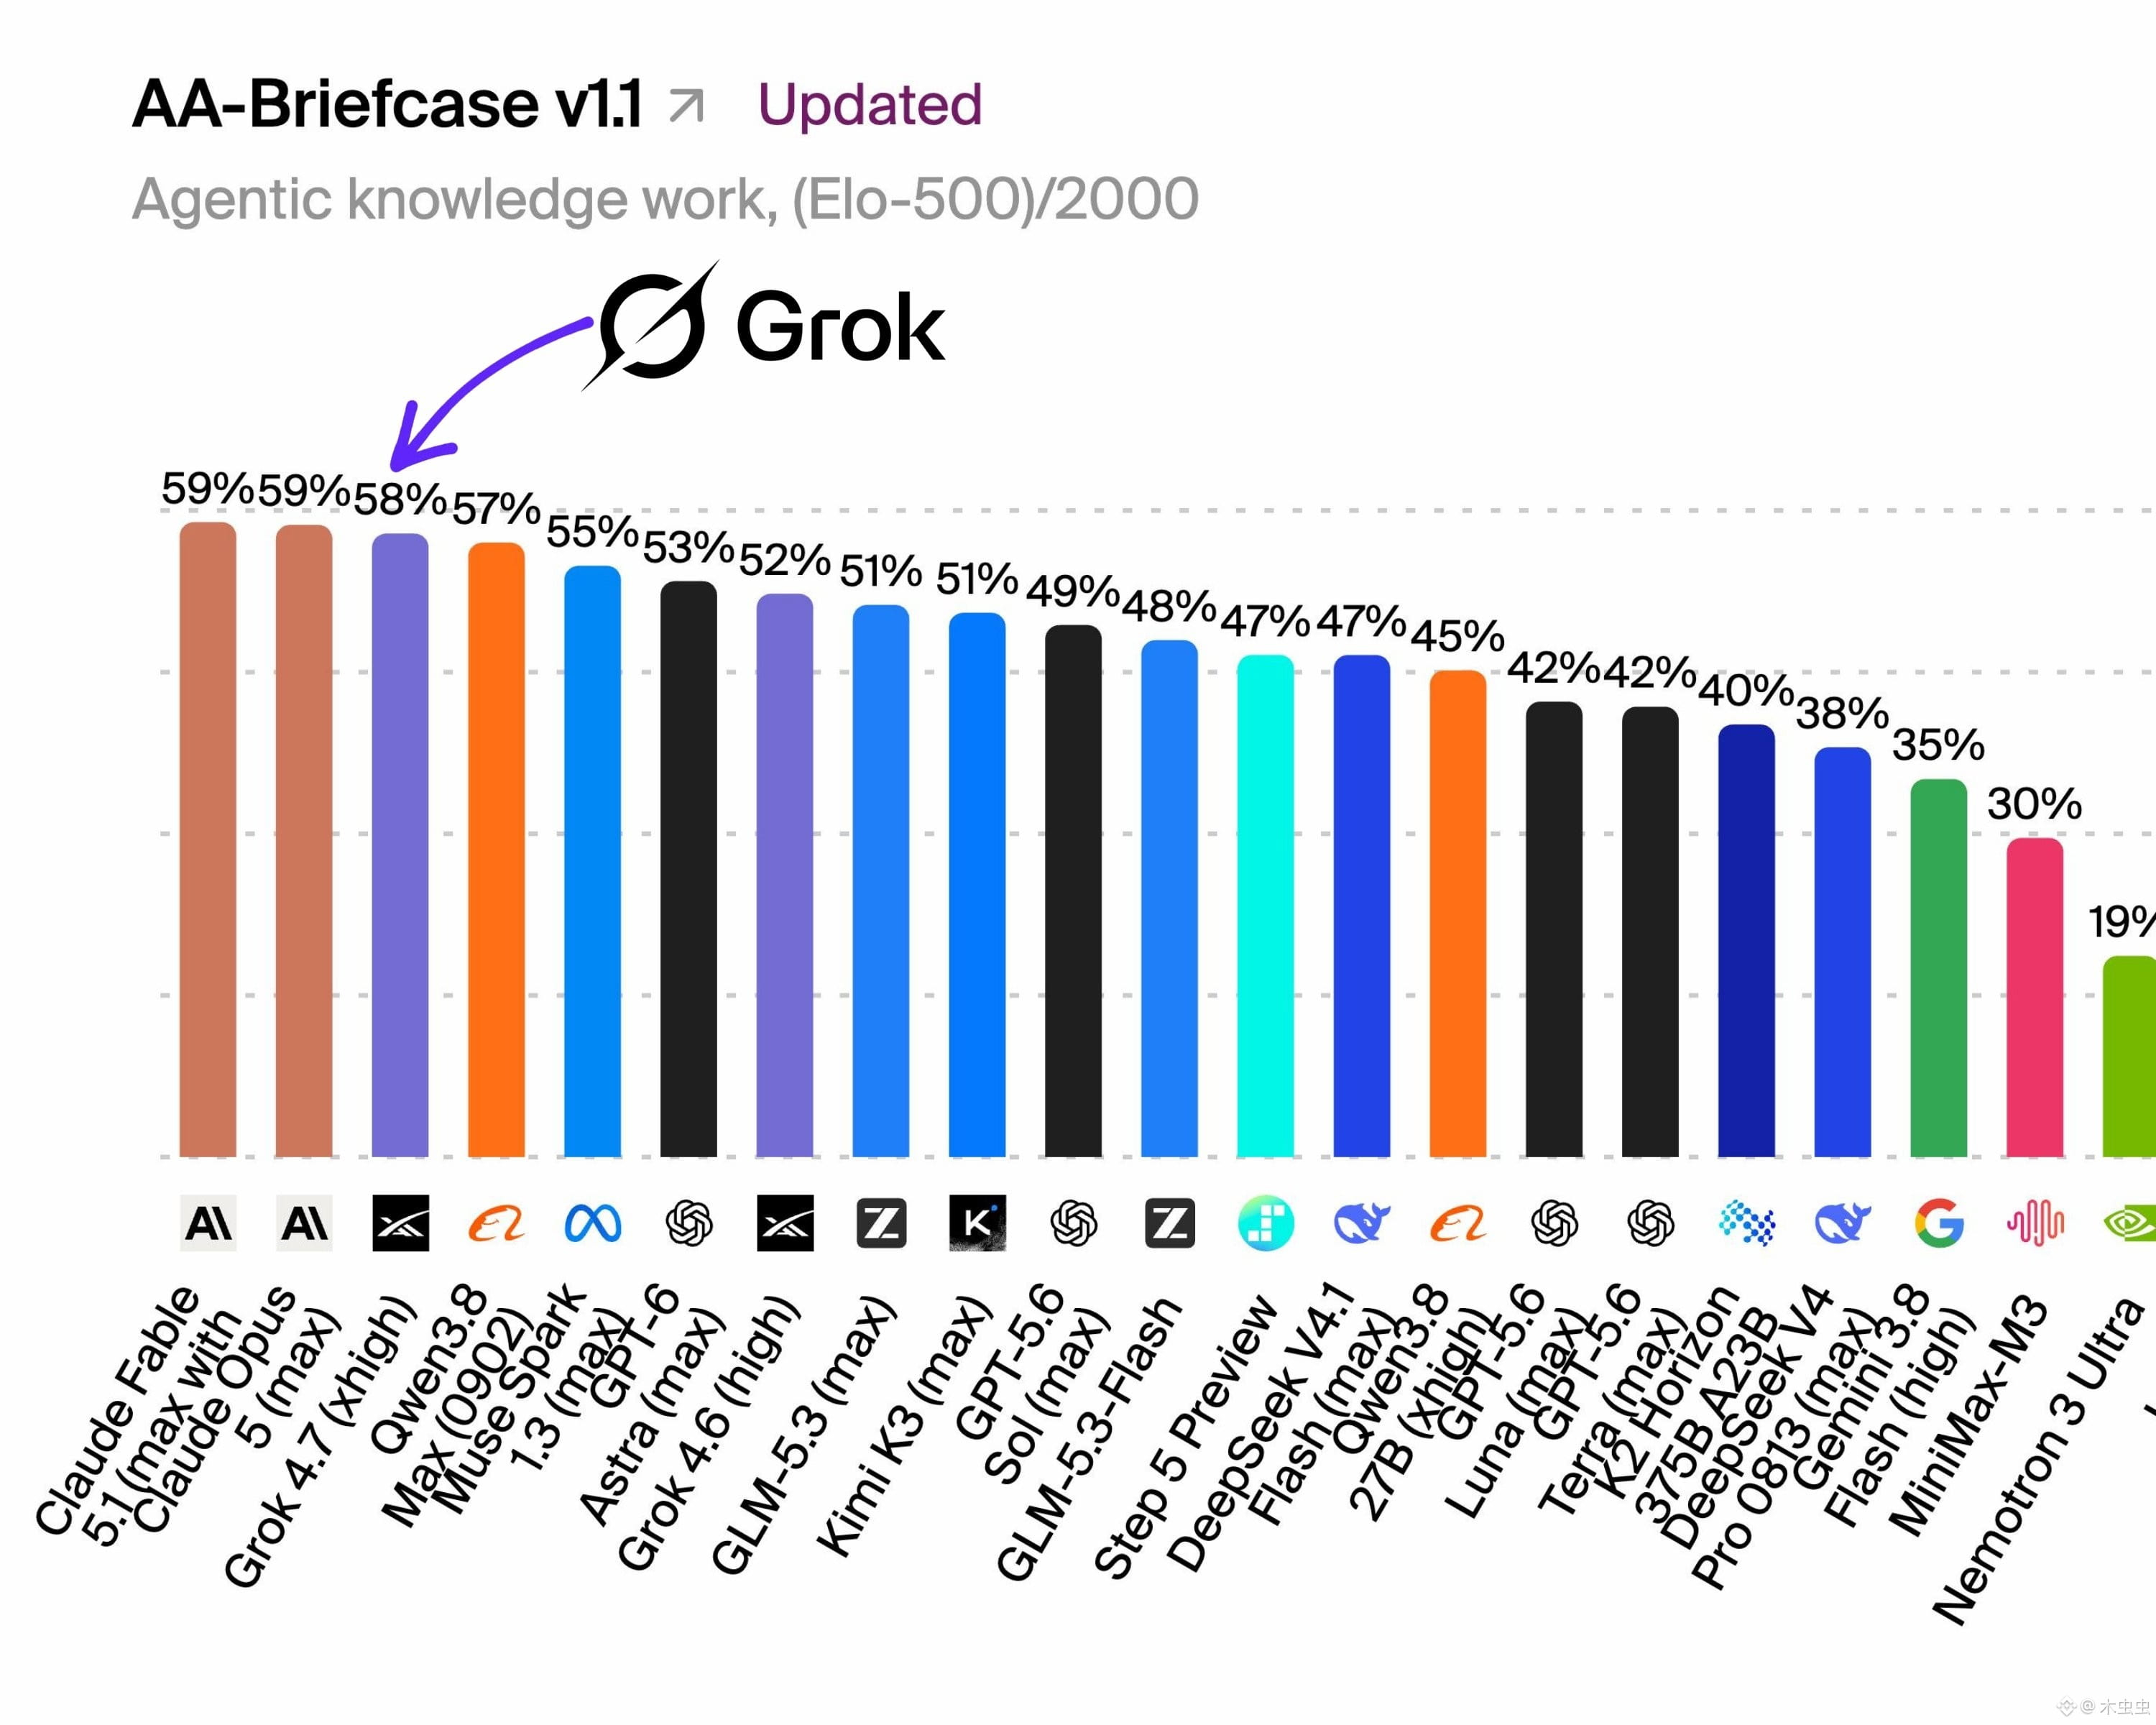
Grok 4.7 xHigh 現已登頂:在人工分析(Artificial Analysis)的 AA-Briefcase 基準測試中,僅差 1 分就能追平 Claude Fable 5.1 Max
Claude Fable 5.1 Max — 59%
Grok 4.7 xHigh — 58%
頂端僅差 1 分
而且 Grok 在該基準測試中領先於 GPT-6 Astra、GPT-5.6、Gemini、Kimi、GLM 以及幾乎所有其他前沿模型
Claude Fable 5.1 Max — 59%
Grok 4.7 xHigh — 58%
頂端僅差 1 分
而且 Grok 在該基準測試中領先於 GPT-6 Astra、GPT-5.6、Gemini、Kimi、GLM 以及幾乎所有其他前沿模型