有人做了一個"星際爭霸"AI 對戰測試(Brood War Bench),讓當下主流大模型互相打即時戰略,結果所有模型的水平都沒超過新手。
《星際爭霸:母巢之戰》是 1998 年的經典即時戰略遊戲,也是 AI 研究的老朋友,2019 年 DeepMind 的 AlphaStar 就曾在這款遊戲裏擊敗職業選手。但那是專門訓練的強化學習 AI。這次測試不同,它讓通用大模型以 AI 智能體的形式直接上手操作,看看它們能不能自己建基地、造兵、打仗。
作者 Ben Swerdlow 原本只是做了一個"只能通過智能體操控"的星際爭霸版本,拿來和朋友玩。沒想到幾個幾乎沒玩過星際的朋友表現還不錯——他們說自己就下了句"去進攻"的命令,智能體就自己造了支小部隊衝過去了。這讓他好奇:如果完全讓 AI 自己玩,能打到什麼水平?
答案是:很菜,但很有意思。
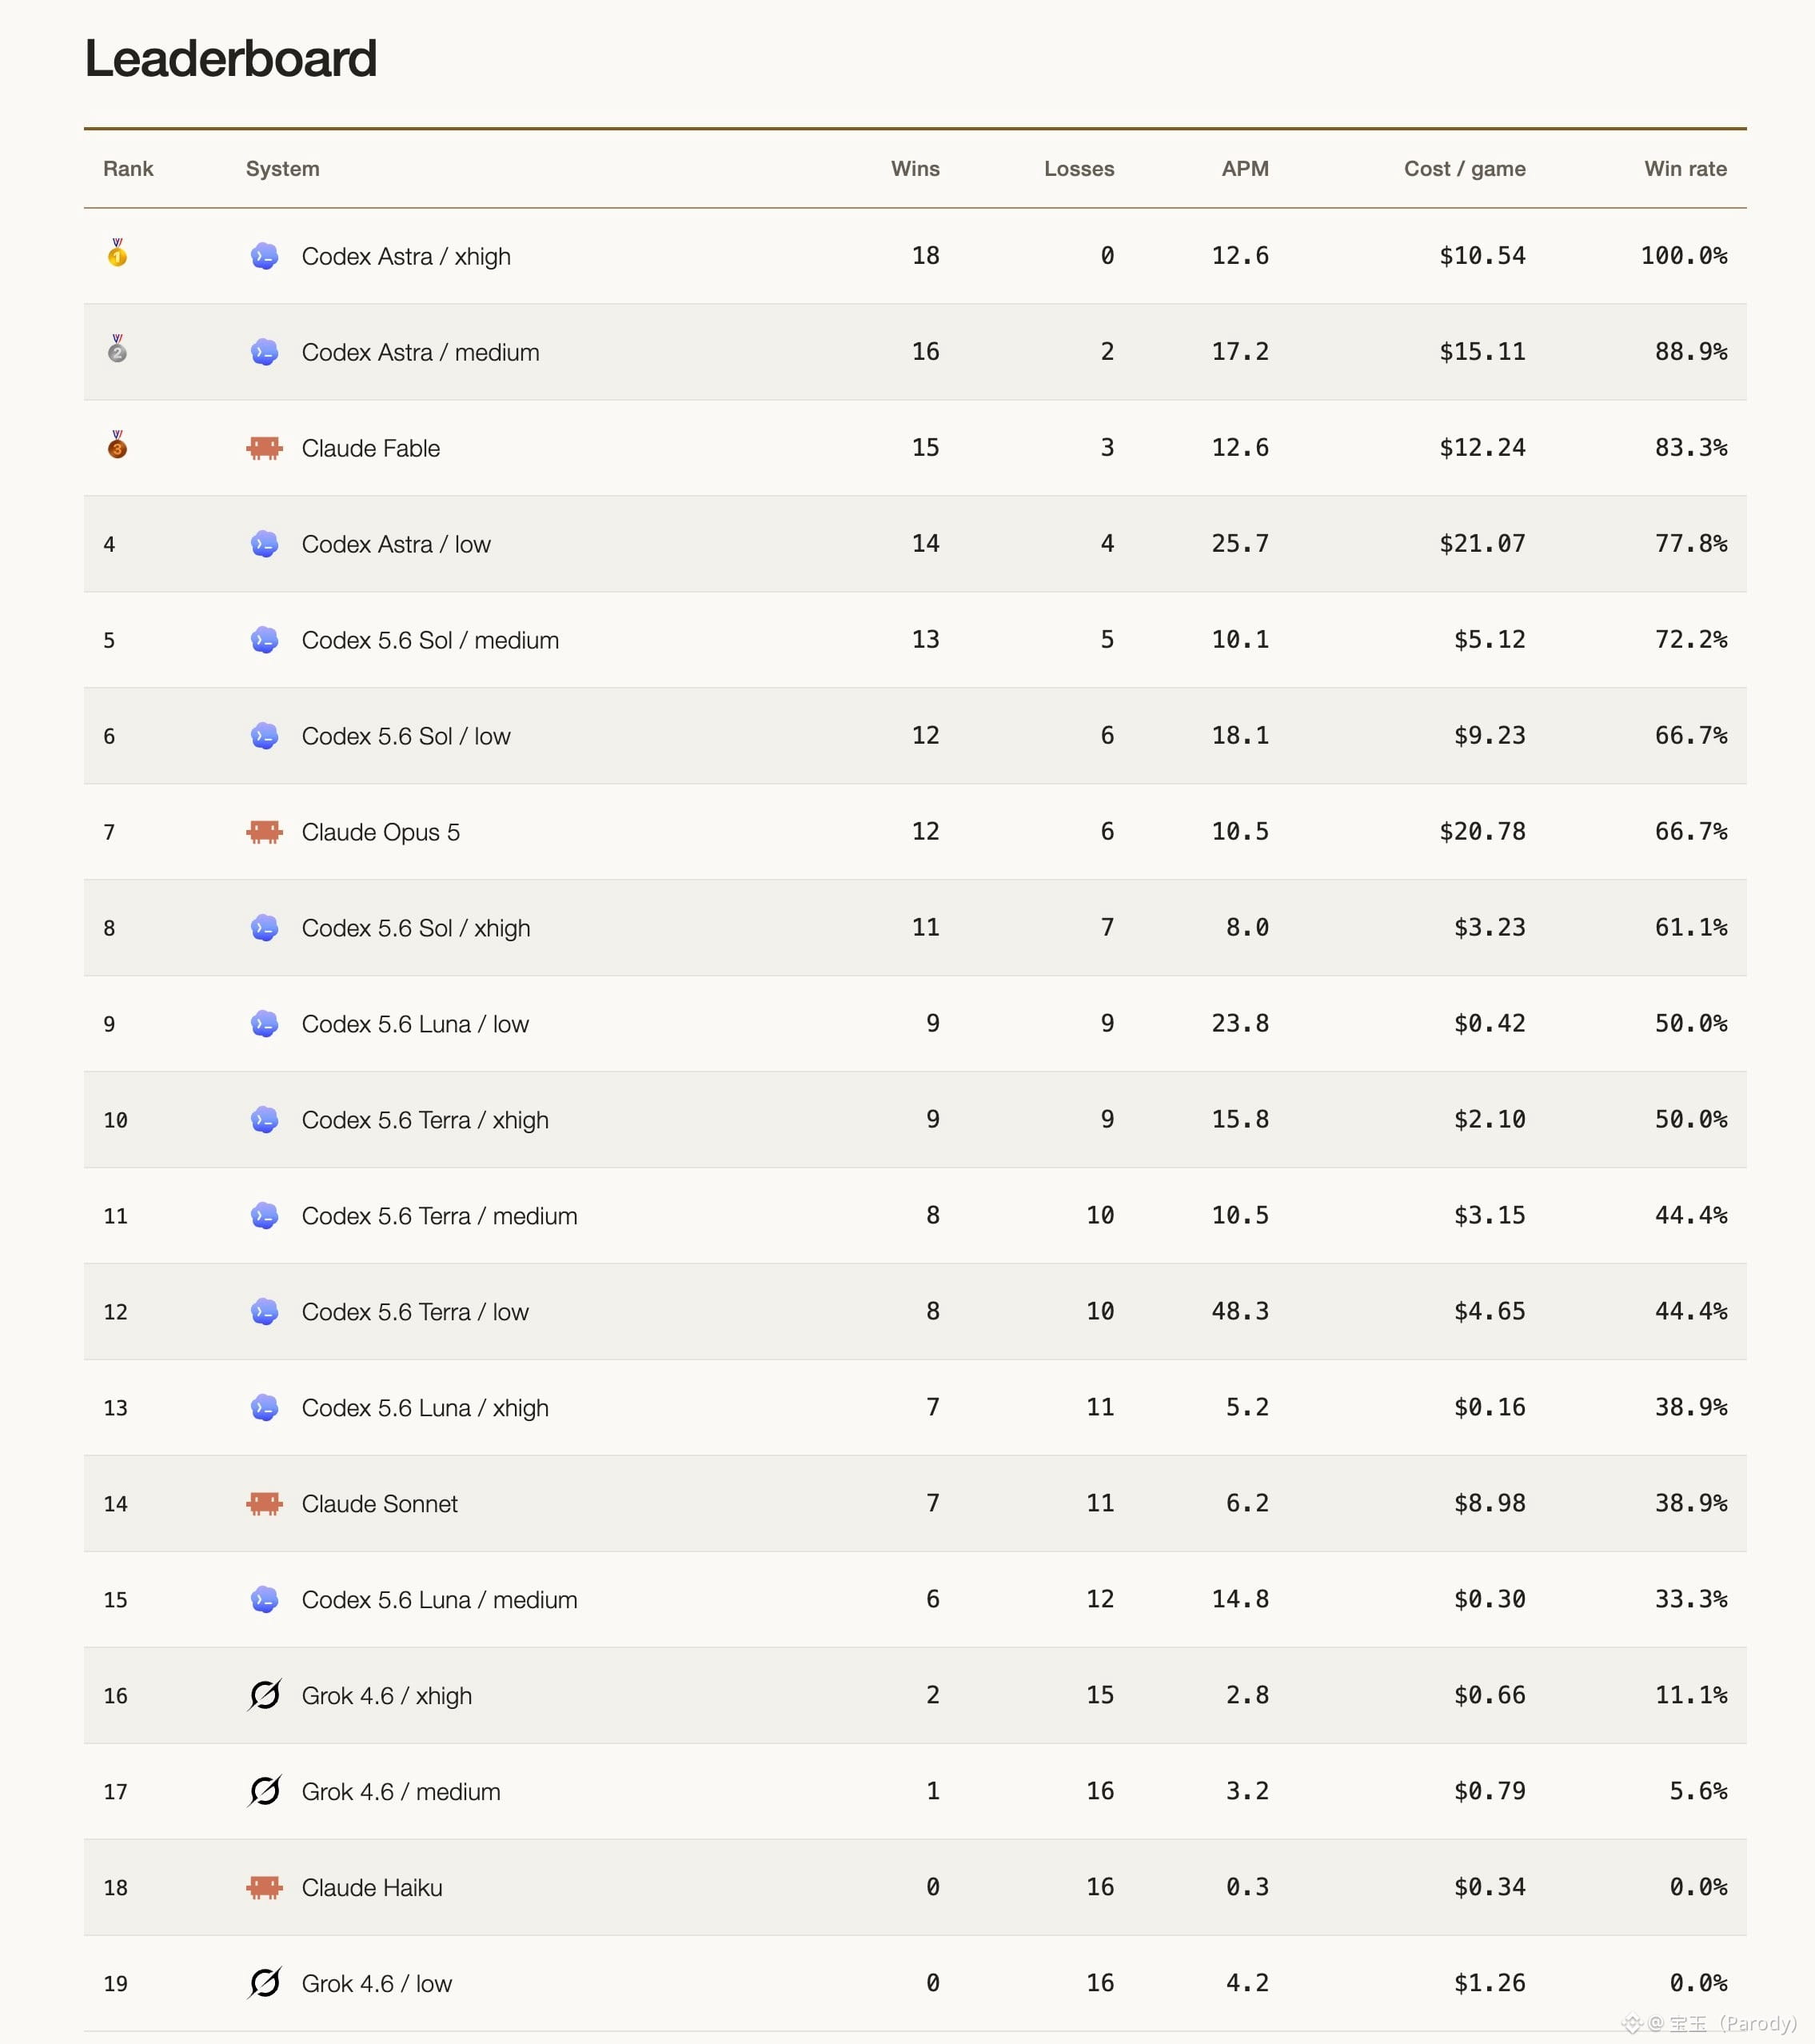
排名第一的 Codex Astra 打了 18 場全勝,但它最擅長的不是正面作戰,而是"騷擾":派一個採礦的工人(Probe)跑到對方基地搗亂。這招對 AI 對手特別好使,因爲對面的智能體看到一個工人來了,會花幾十秒思考該怎麼辦,期間什麼都不幹。而在正經的經濟發展和大規模作戰方面,Codex 反而比較弱,經常造一兩個兵就往對面扔,而不是攢夠兵力再出擊。
Claude Fable 排第三,勝率 83.3%,是所有參賽模型裏最"像在認真打遊戲"的。它會老老實實發展經濟、爬科技樹,甚至在一局裏造出了飛龍(Mutalisk),在另一局裏研究到了聖堂武士科技。雖然有時候研發做了一堆,兵力沒跟上,但至少在"試圖理解遊戲規則"這件事上,Fable 比誰都認真。
Grok 的表現最差。Grok 4.6 在一場 43 分鐘的比賽裏輸出了超過 11000 個推理 token,卻只發出了 6 批操作指令,全程沒造過一個戰鬥單位。它本質上是把即時戰略當成了回合制遊戲,一直在想,忘了要動手。
這個測試揭示的核心問題是:當前大模型在需要持續觀察、快速決策、多線程協調的實時環境中,還遠遠不夠用。即使是表現最好的模型,一個會打"光子炮速推"(一種最基礎的快攻戰術)的人類新手就能贏下所有比賽。但反過來看,這些模型已經能理解建造、採礦、進攻的基本概念,只是在執行節奏和多任務協調上差得遠。
測試的代碼和對戰平臺已經開放,任何人都可以帶自己的智能體上去打一局,地址是 http://bw.swerdlow.dev。
《星際爭霸:母巢之戰》是 1998 年的經典即時戰略遊戲,也是 AI 研究的老朋友,2019 年 DeepMind 的 AlphaStar 就曾在這款遊戲裏擊敗職業選手。但那是專門訓練的強化學習 AI。這次測試不同,它讓通用大模型以 AI 智能體的形式直接上手操作,看看它們能不能自己建基地、造兵、打仗。
作者 Ben Swerdlow 原本只是做了一個"只能通過智能體操控"的星際爭霸版本,拿來和朋友玩。沒想到幾個幾乎沒玩過星際的朋友表現還不錯——他們說自己就下了句"去進攻"的命令,智能體就自己造了支小部隊衝過去了。這讓他好奇:如果完全讓 AI 自己玩,能打到什麼水平?
答案是:很菜,但很有意思。
排名第一的 Codex Astra 打了 18 場全勝,但它最擅長的不是正面作戰,而是"騷擾":派一個採礦的工人(Probe)跑到對方基地搗亂。這招對 AI 對手特別好使,因爲對面的智能體看到一個工人來了,會花幾十秒思考該怎麼辦,期間什麼都不幹。而在正經的經濟發展和大規模作戰方面,Codex 反而比較弱,經常造一兩個兵就往對面扔,而不是攢夠兵力再出擊。
Claude Fable 排第三,勝率 83.3%,是所有參賽模型裏最"像在認真打遊戲"的。它會老老實實發展經濟、爬科技樹,甚至在一局裏造出了飛龍(Mutalisk),在另一局裏研究到了聖堂武士科技。雖然有時候研發做了一堆,兵力沒跟上,但至少在"試圖理解遊戲規則"這件事上,Fable 比誰都認真。
Grok 的表現最差。Grok 4.6 在一場 43 分鐘的比賽裏輸出了超過 11000 個推理 token,卻只發出了 6 批操作指令,全程沒造過一個戰鬥單位。它本質上是把即時戰略當成了回合制遊戲,一直在想,忘了要動手。
這個測試揭示的核心問題是:當前大模型在需要持續觀察、快速決策、多線程協調的實時環境中,還遠遠不夠用。即使是表現最好的模型,一個會打"光子炮速推"(一種最基礎的快攻戰術)的人類新手就能贏下所有比賽。但反過來看,這些模型已經能理解建造、採礦、進攻的基本概念,只是在執行節奏和多任務協調上差得遠。
測試的代碼和對戰平臺已經開放,任何人都可以帶自己的智能體上去打一局,地址是 http://bw.swerdlow.dev。