我最近重新理解了 KGeN:AI 可能真的缺的不是更多數據》
最近研究 KGeN,我最大的一個感受是:
AI的數據越多,“數據是不是真的來自人”反而可能越重要。
以前看到 AI 項目講數據,我基本不會停留太久。畢竟現在網上什麼數據都有。
但問題也恰恰在這裏。
AI 生成的文章、圖片、聲音越來越多,機器人賬號也越來越普遍。以後如果 AI 大量學習這些已經被 AI 生成過的內容,會不會出現一個循環?
AI生成 → AI學習 → 再生成 → 再訓練AI。
數量越來越大,但真實的人類經驗反而可能越來越少。
這也是我開始認真看 KGeN 的原因。
KGeN 目前把自己定位成 Verified Human Network,核心方向是獲取經過驗證的真實人類、多模態數據,用於 Physical AI 和 LLM。官方提到的數據類型包括聲音、視覺、動作和觸覺,並覆蓋 60+ 個國家。
我覺得這裏最值得思考的並不是“AI”這個熱門概念,而是:
如果未來 AI 要真正理解現實世界,它是不是必須先理解真實的人類?
比如一個機器人要學會生活在真實環境裏,單純看互聯網圖片可能遠遠不夠。
它需要知道人怎麼說話、怎麼行動、怎麼觀察環境,甚至人在不同場景下會做出什麼反應。
這時候,真實的人類數據就不再只是數據量的問題,而是數據來源和質量的問題。
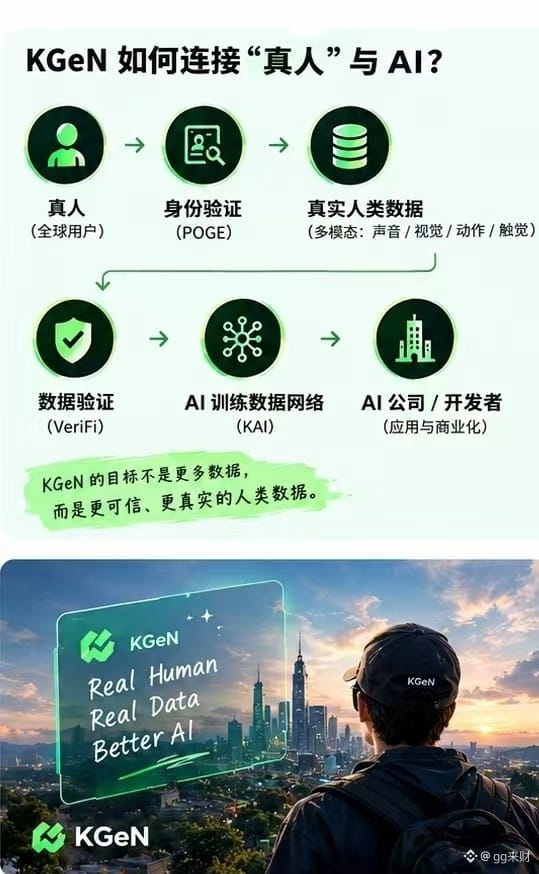
KGeN 現在的思路,就是把真人、驗證、多模態數據和 AI 訓練需求連接起來。其產品體系裏也包括 K-Quest,用經過驗證的人類完成任務來採集 Physical AI 和 LLM 所需要的多模態數據。
當然,我不會現在就說 KGeN 一定會成功。
對我來說,更值得繼續觀察的是:
真實用戶能不能持續增長?
數據需求能不能持續產生?
這些數據能不能真正被 AI 公司使用?
最後能不能形成長期的商業閉環?
這些問題,比單純看短期價格有意思得多。
這個答案,我還在繼續觀察
#KGen
最近研究 KGeN,我最大的一個感受是:
AI的數據越多,“數據是不是真的來自人”反而可能越重要。
以前看到 AI 項目講數據,我基本不會停留太久。畢竟現在網上什麼數據都有。
但問題也恰恰在這裏。
AI 生成的文章、圖片、聲音越來越多,機器人賬號也越來越普遍。以後如果 AI 大量學習這些已經被 AI 生成過的內容,會不會出現一個循環?
AI生成 → AI學習 → 再生成 → 再訓練AI。
數量越來越大,但真實的人類經驗反而可能越來越少。
這也是我開始認真看 KGeN 的原因。
KGeN 目前把自己定位成 Verified Human Network,核心方向是獲取經過驗證的真實人類、多模態數據,用於 Physical AI 和 LLM。官方提到的數據類型包括聲音、視覺、動作和觸覺,並覆蓋 60+ 個國家。
我覺得這裏最值得思考的並不是“AI”這個熱門概念,而是:
如果未來 AI 要真正理解現實世界,它是不是必須先理解真實的人類?
比如一個機器人要學會生活在真實環境裏,單純看互聯網圖片可能遠遠不夠。
它需要知道人怎麼說話、怎麼行動、怎麼觀察環境,甚至人在不同場景下會做出什麼反應。
這時候,真實的人類數據就不再只是數據量的問題,而是數據來源和質量的問題。
KGeN 現在的思路,就是把真人、驗證、多模態數據和 AI 訓練需求連接起來。其產品體系裏也包括 K-Quest,用經過驗證的人類完成任務來採集 Physical AI 和 LLM 所需要的多模態數據。
當然,我不會現在就說 KGeN 一定會成功。
對我來說,更值得繼續觀察的是:
真實用戶能不能持續增長?
數據需求能不能持續產生?
這些數據能不能真正被 AI 公司使用?
最後能不能形成長期的商業閉環?
這些問題,比單純看短期價格有意思得多。
這個答案,我還在繼續觀察
#KGen