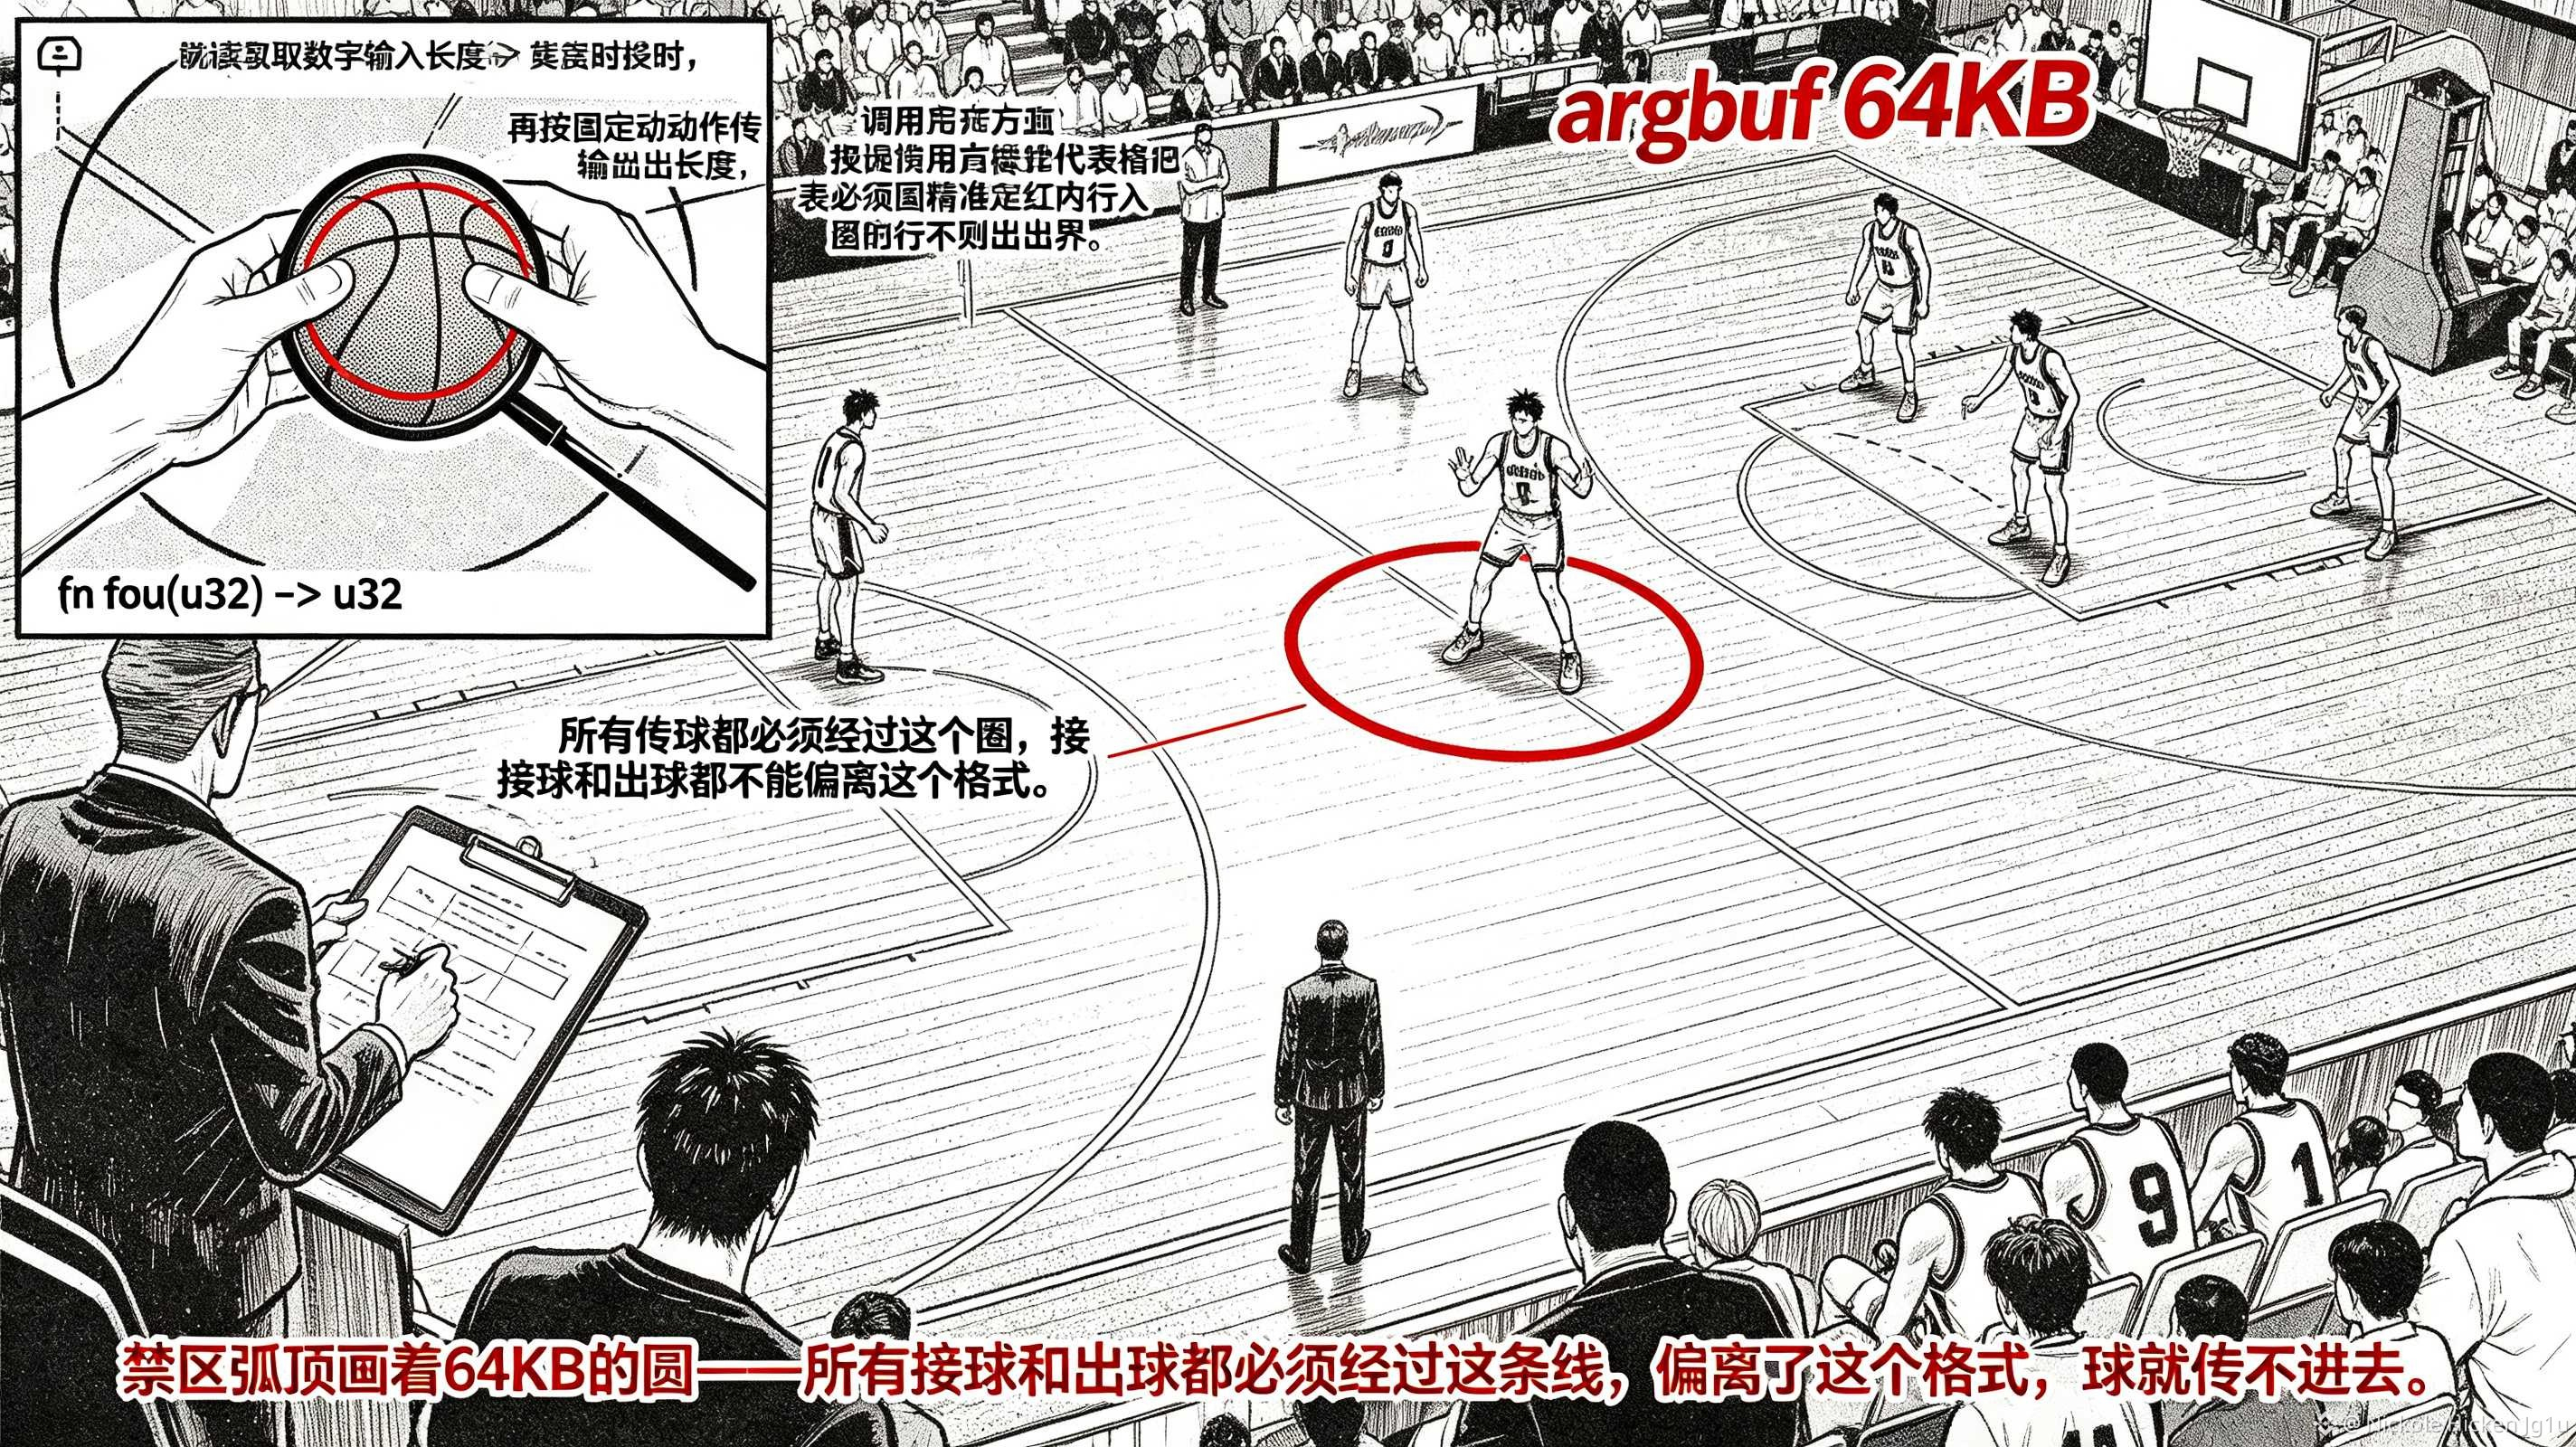
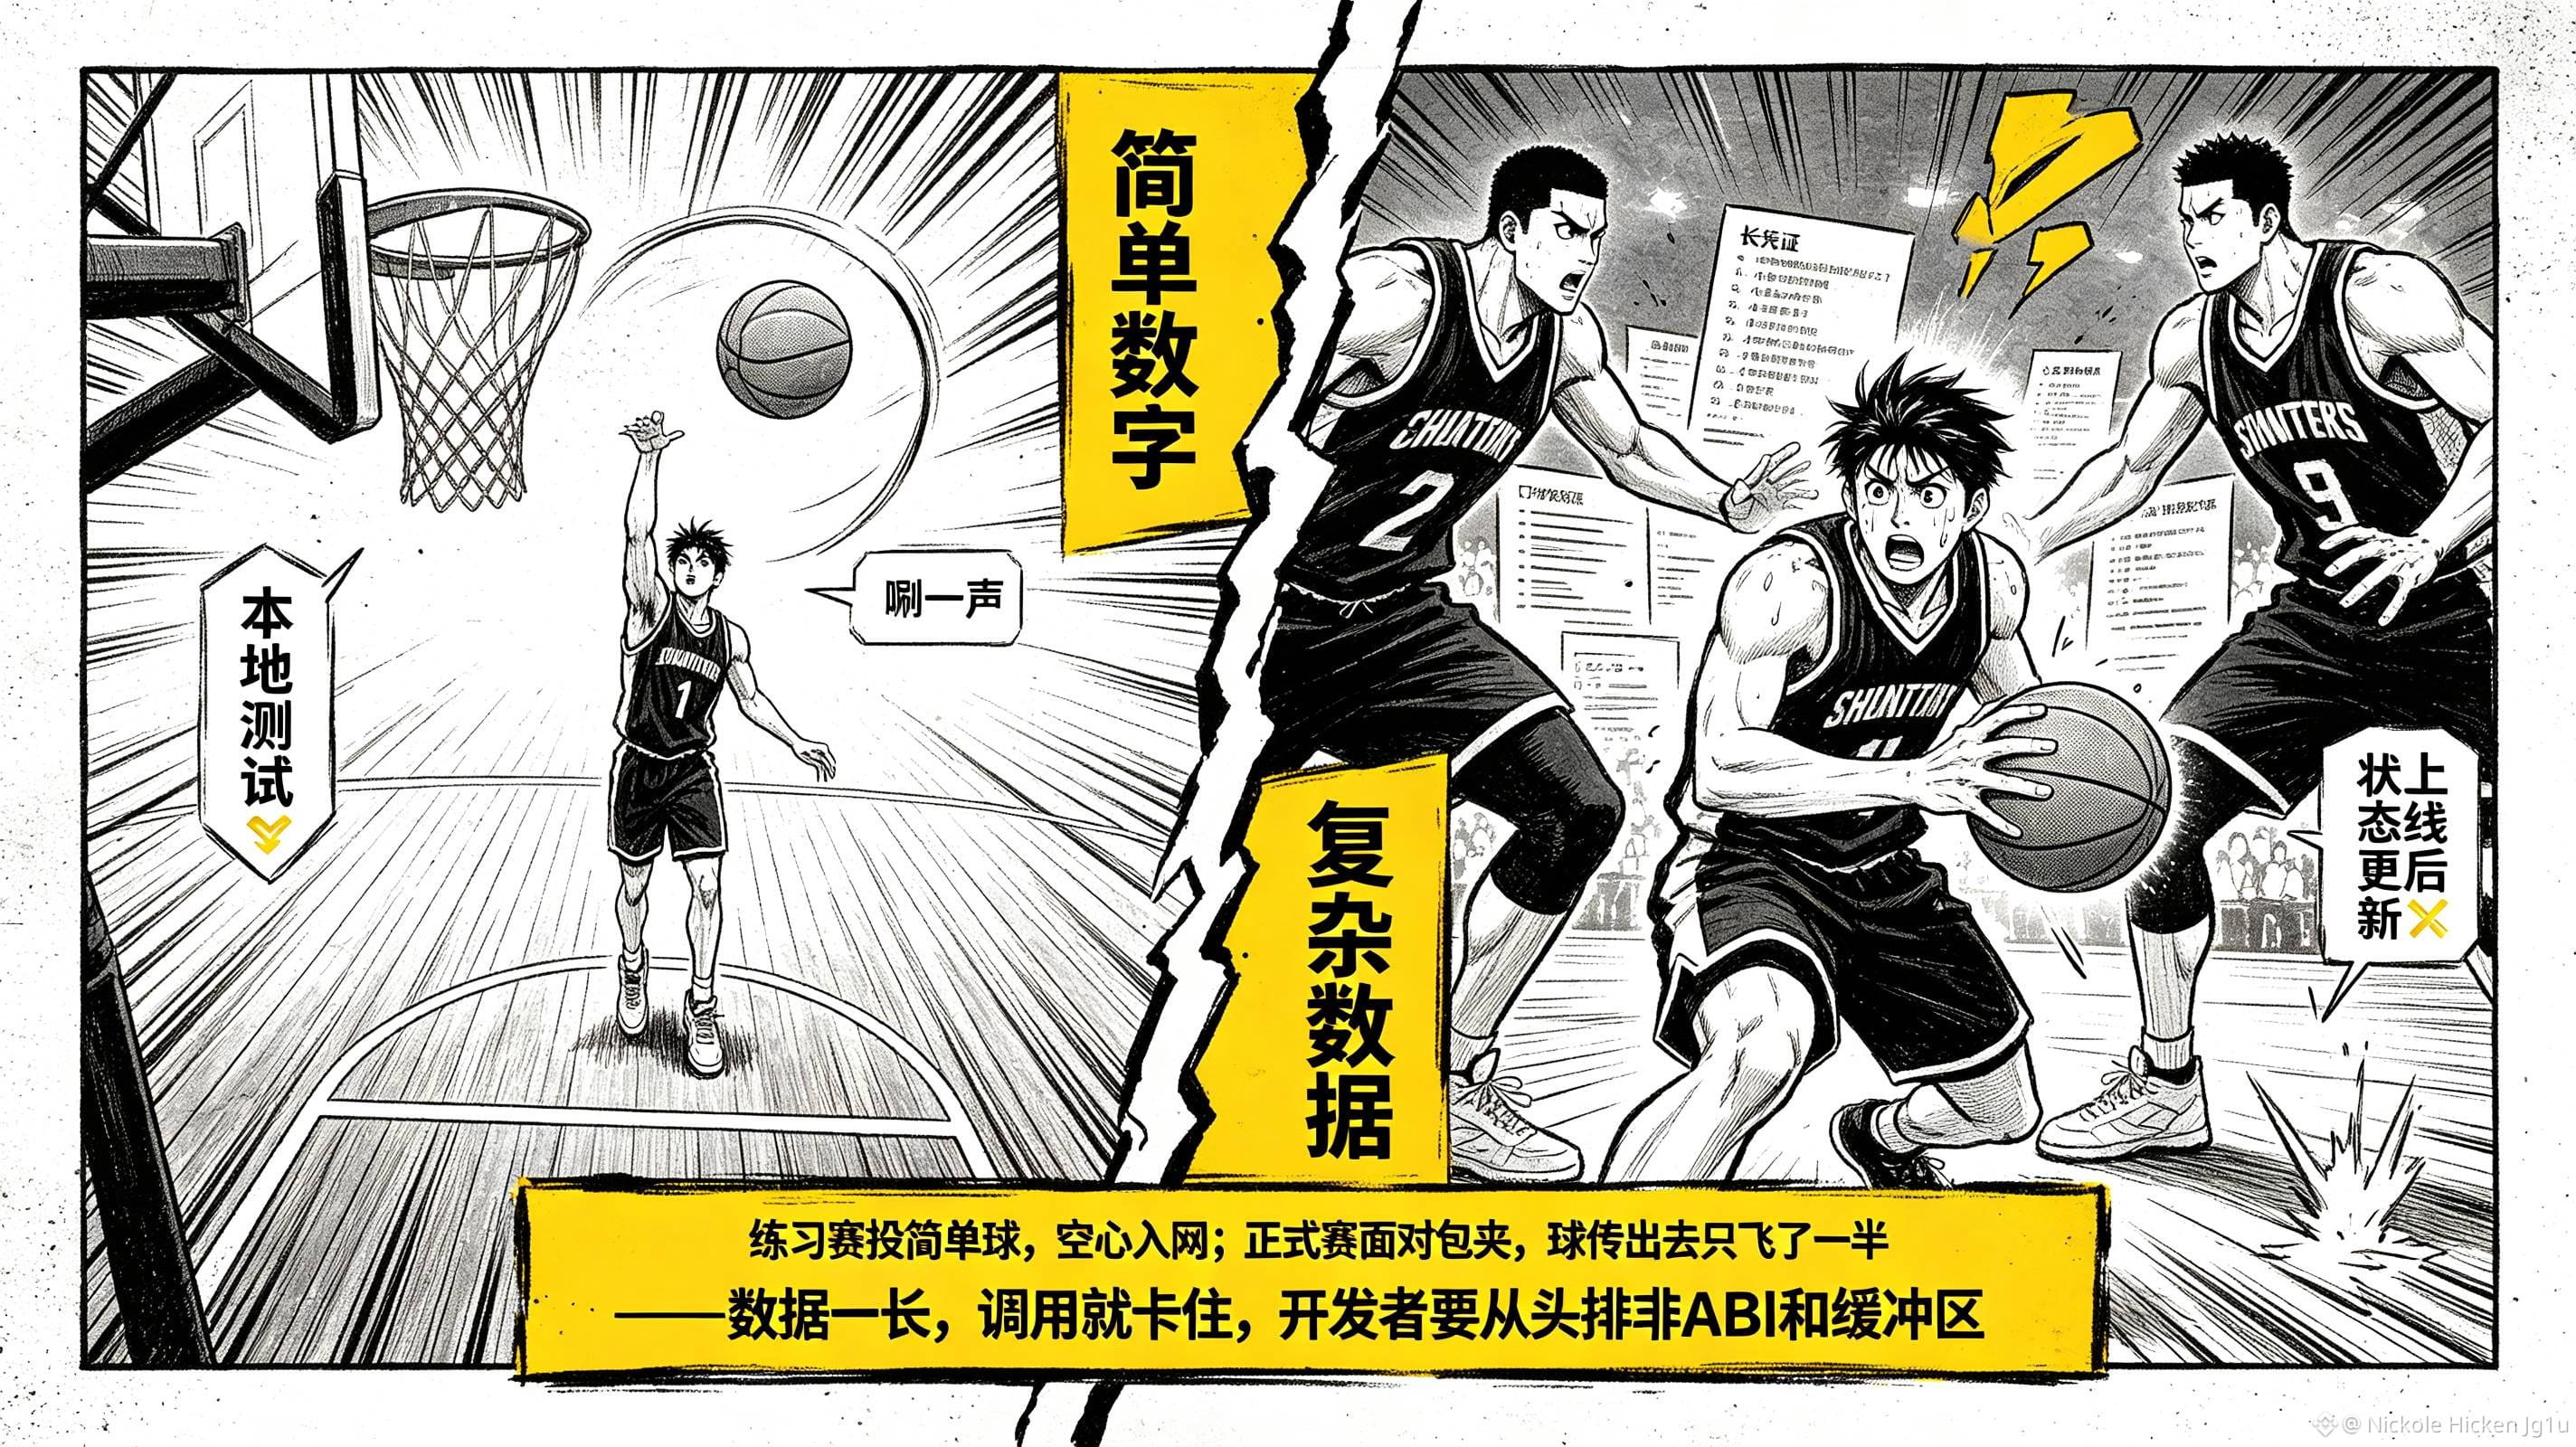
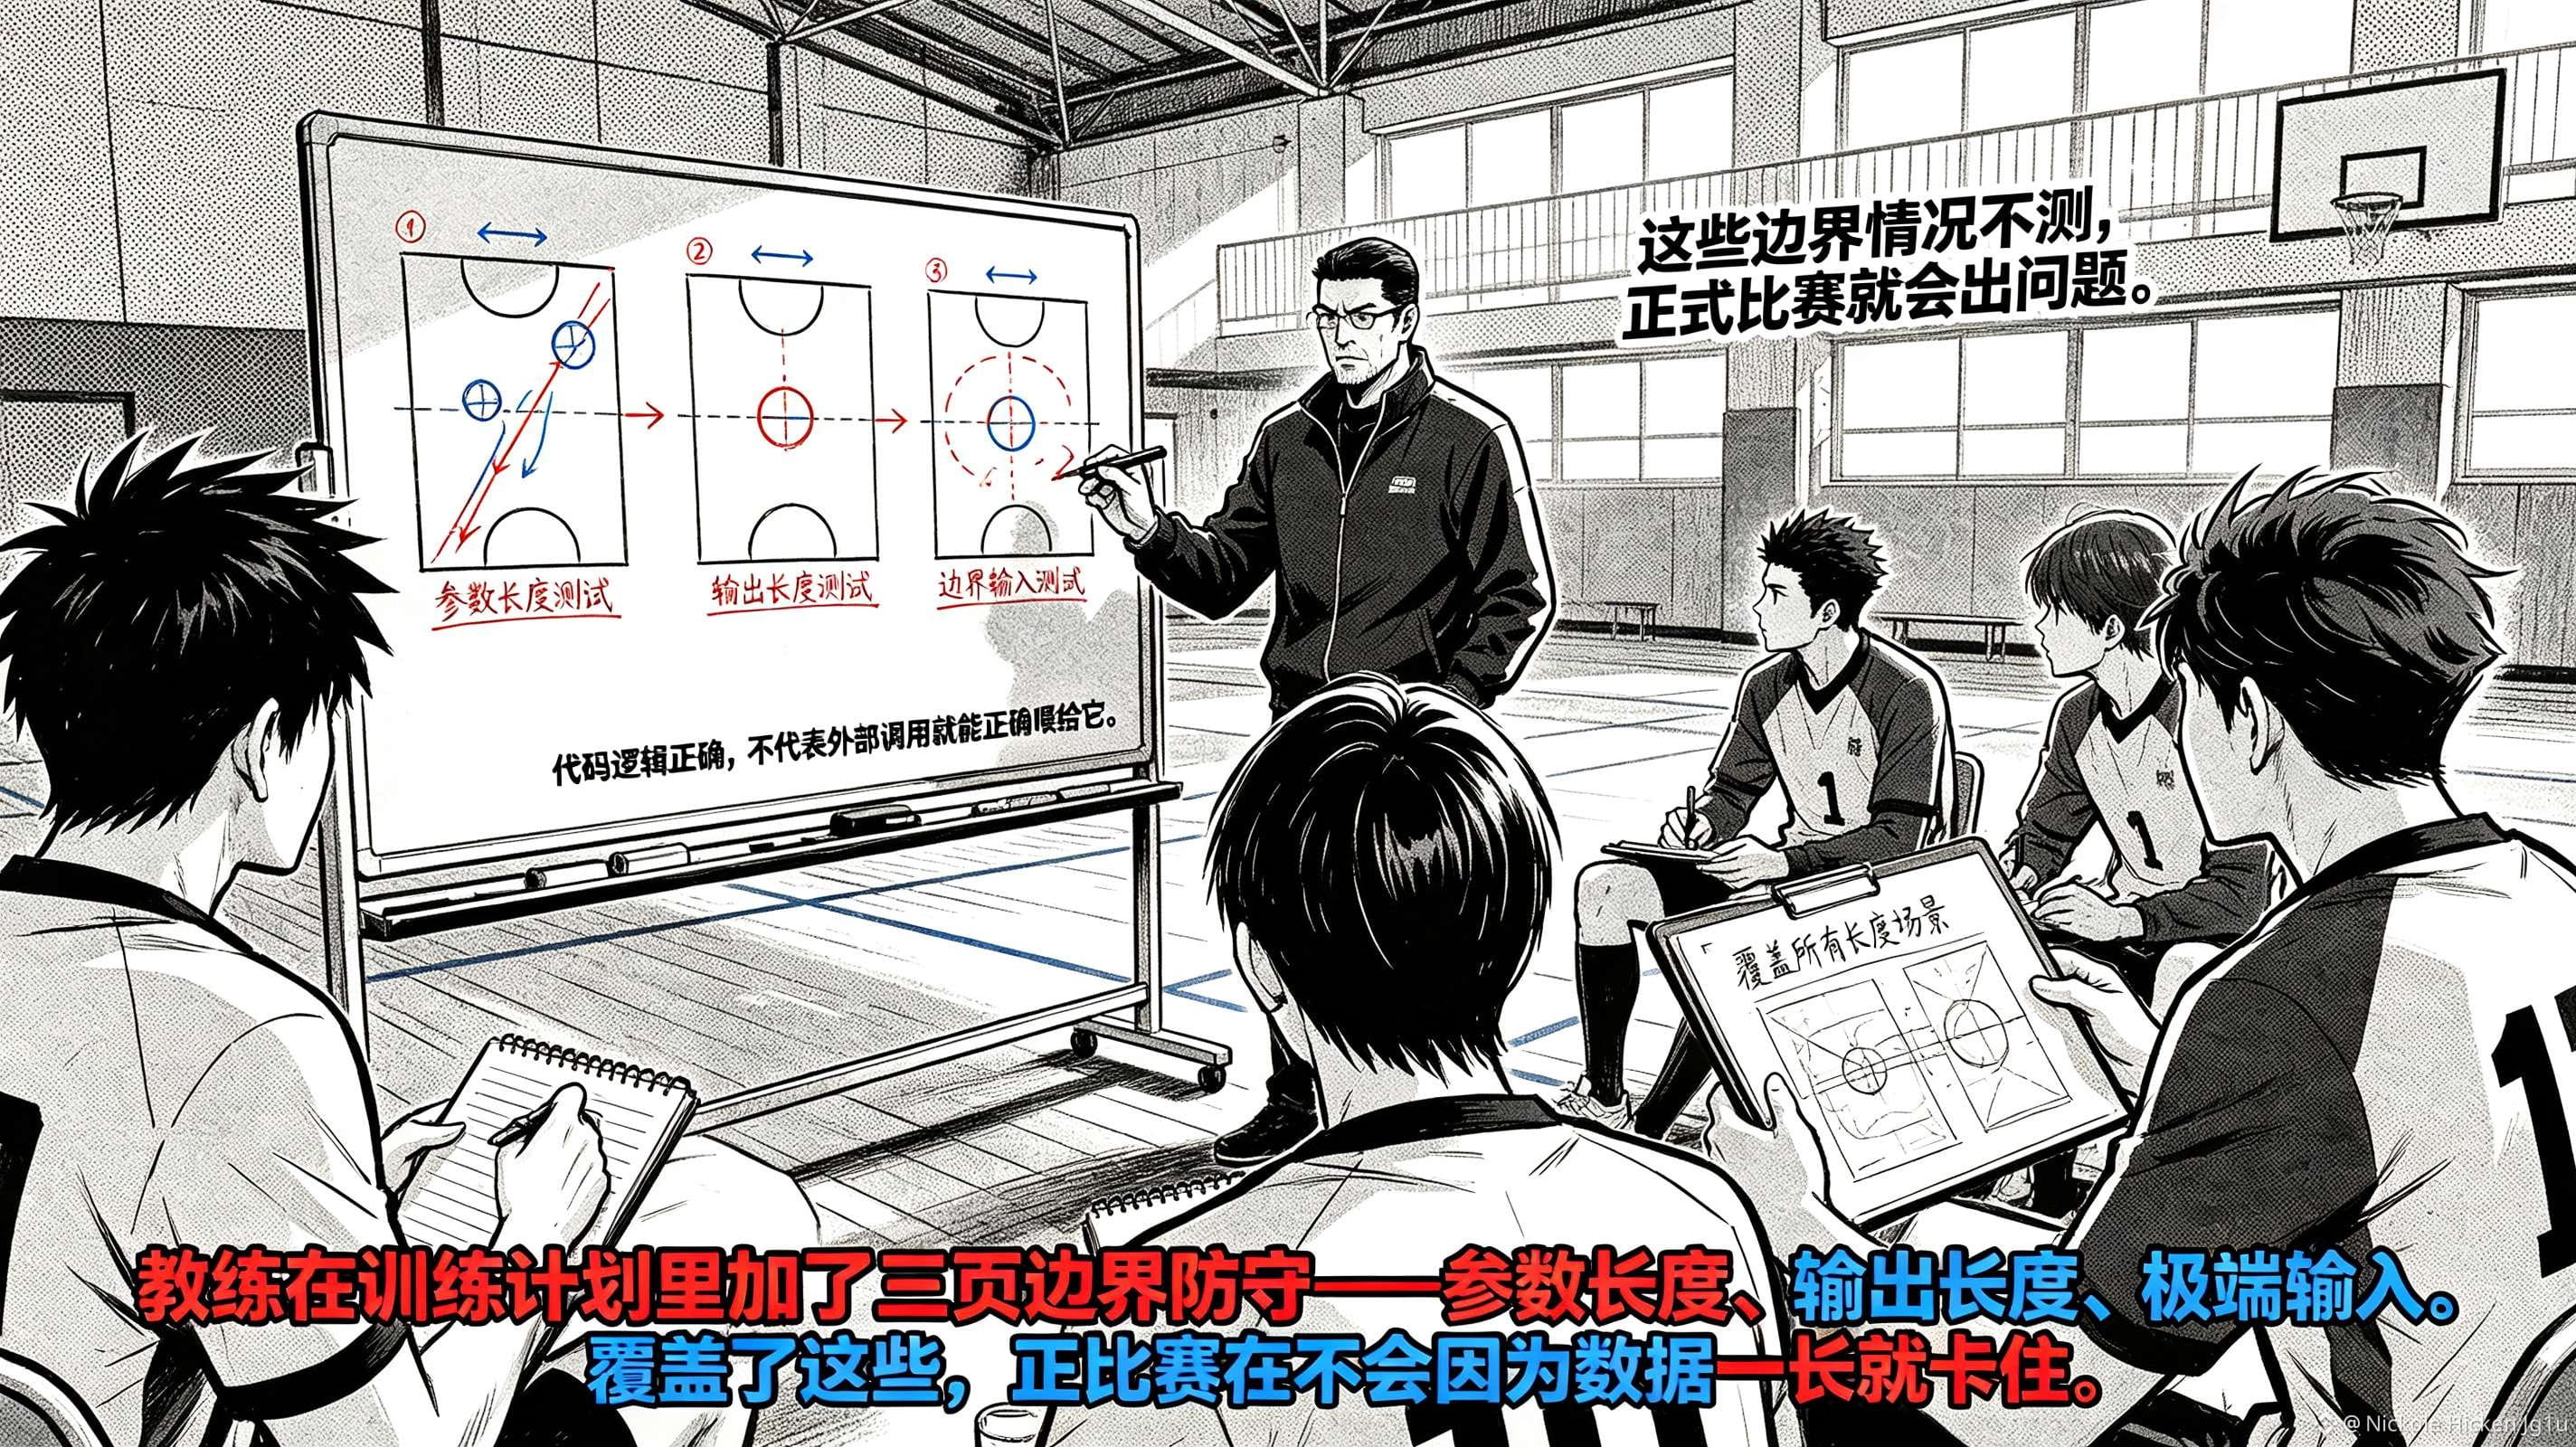
我原來以爲合約能不能在DuskVM裏跑起來主要看Rust代碼有沒有編譯通過,但讀了@Dusk 的DuskVM說明後才發現真正容易卡住的地方更靠近調用邊界:合約必須暴露一塊64KB的argbuf,入口函數還要按fn foo(u32) -> u32的格式接收輸入長度、處理數據再返回輸出長度,代碼邏輯正確並不代表外部調用就能正確餵給它。這個設計讓我重新看待開發成本,DuskVM不替開發者規定業務邏輯,卻把輸入和輸出的內存邊界交給合約自己負責。調用方傳進來的並不是一串“隨便能讀的參數”,而是已經放進緩衝區並由長度決定讀取範圍的數據,如果序列化、長度判斷以及輸出寫回有一處沒對上,問題可能不會表現爲明顯的業務錯誤,前端只會收到一次失敗的合約調用。壓力場景其實很具體,資產應用在本地測試裏只傳一個簡單數字時一切正常,上線後換成更長的憑證、訂單或權限數據,合約仍然能被調用卻讀不完整或者返回截斷結果。用戶看到的是狀態沒有更新,開發者需要回頭排查ABI、緩衝區以及數據驅動器,承擔成本的並不是抽象的虛擬機,而是等待結果的用戶和維護集成的團隊。所以我現在看$DUSK 的DuskVM時不會只問它能不能執行Rust或WASM,會先看合約測試是否覆蓋了參數長度、輸出長度以及邊界輸入。@Dusk 把調用約定寫得很明確,說明性能和可控性背後也有一份內存責任,對Dusk開發者來說真正值得驗證的是複雜業務數據進入合約後邊界是否仍然可預測。#dusk