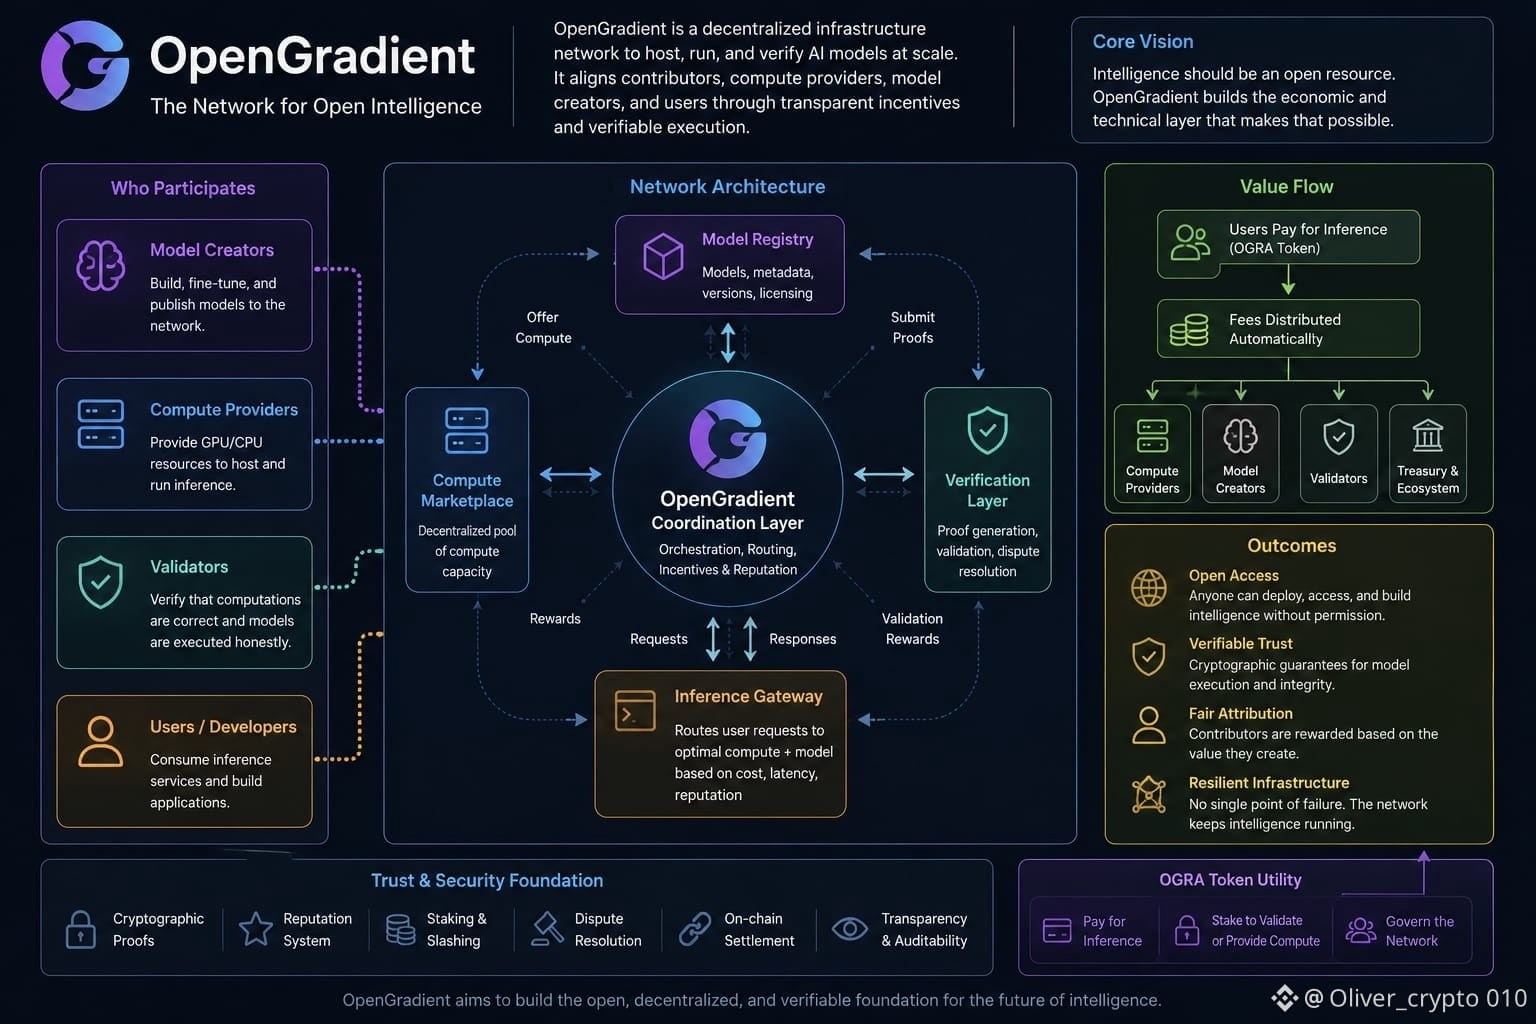
#opg $OPG 我得先說實話。第一次聽到 OpenGradient 的時候,我以爲又是某個項目想把一種加密代幣放到人工智能旁邊,然後把它包裝成“基礎設施”。行業早就養成了一個習慣:把每一次技術變革都變成敘事的競賽,而 AI 成了其中最大的敘事。看多了那些項目承諾“去中心化代理”“自治經濟體”“人人擁有的機器智能”之後,懷疑開始感覺不像是冷嘲熱諷,更像是一種自我防護。
但我越深入瞭解 OpenGradient,就越覺得它不像是一個 AI 故事,反而更像是一個“所有權”故事。
關於人工智能的大多數討論都聚焦在能力上。哪個模型更聰明?哪家公司有更多算力?哪個系統能生成更好的文本、圖片或代碼?這些問題確實重要,但它們往往會掩蓋下面那個更深層的問題:如果智能像電力、通信和雲計算那樣成爲基礎設施,那麼誰有資格擁有這套基礎設施?
目前答案似乎很明確:少數公司訓練這些模型、擁有底層硬件、存儲數據,並通過人們與 AI 交互的接口來進行控制。從商業角度看,這種集中也說得通。大模型需要鉅額投資,而規模優勢會讓體量較小的參與者很難追趕。更好的模型吸引更多用戶,更多用戶又產生更多數據,而更多數據又會進一步提升模型。這個循環會不斷自我供養。
@OpenGradient $OPG