OpenLedger和歸因中心化AI基礎設施的隱性脆弱性
大多數基礎設施系統在活動消失時不會崩潰。它們在活動無法正確分類時纔會崩潰。
這個區分在AI網絡中比在傳統區塊鏈中更爲重要,因爲系統的經濟價值不太依賴於交易吞吐量,而更依賴於歸因的完整性。一旦網絡無法可靠地判斷哪個模型貢獻是重要的,哪個數據集改善了結果,或者哪個代理產生了有意義的執行,整個激勵結構就會開始偏離有效協調,轉向合成參與。網絡可能仍然看起來在運行。流動性可能仍然活躍。驗證者可能繼續生產區塊。然而在表面之下,貢獻和獎勵之間的關係逐漸減弱,直到基礎設施開始以與信號相同的信心來補償噪聲。
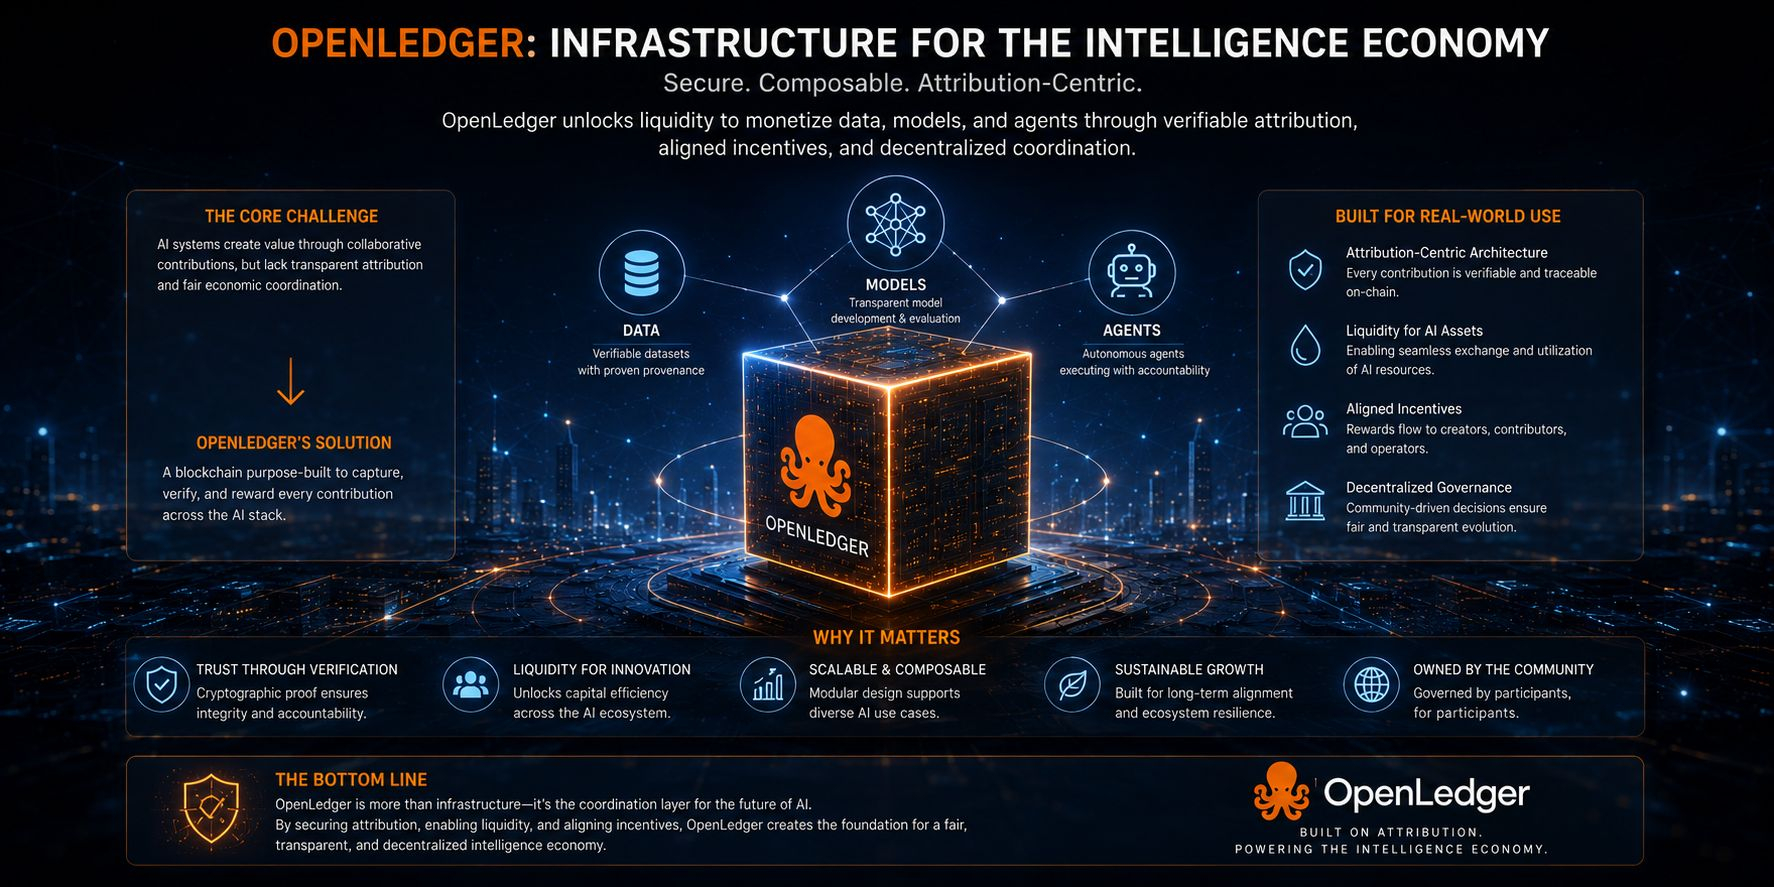
OpenLedger 在結構上似乎意識到了這個問題。該項目並不只是試圖再造一個面向 AI 的區塊鏈。它的架構表明,它在嘗試解決一個更難的協調問題:如何在這樣一種環境中維持歸因完整性——在這裏,模型、數據集、代理與流動性提供者會同時爲經濟攫取而競爭。
這會帶來一種不同於傳統第 1 層系統所通常面臨的基礎設施壓力。
大多數區塊鏈優化圍繞狀態一致性和交易最終性展開。OpenLedger 似乎是在經濟壓力條件下,優化“貢獻可追溯性”。這個區別起初聽起來很微妙,但它會改變網絡設計內部幾乎所有取捨。
因此,OpenLedger 的核心結構性檢驗並不是吞吐量。關鍵在於:歸因能否在規模化時仍然存活。
一旦這個框架變得可見,項目的許多架構決策就會開始變得更有道理。
傳統區塊鏈的驗證者主要驗證執行正確性。在 OpenLedger 的環境中,驗證者隱式地也會成爲信息合法性的仲裁者。網絡不僅在確保交易;它試圖在 AI 基礎設施各層之間,確保輸入與結果之間的關係——而這些關係本質上是概率性的。這會顯著提高協調複雜度,因爲機器學習系統中的歸因很少是線性的。
某個數據集在一種推理條件下可能會讓模型邊際變好,但在另一種條件下卻會降低性能。一個自主代理可能在低擁堵時期帶來執行效率,同時又在壓力時期製造協調不穩定。一個流動性層可能加速模型可達性,但也會同時把影響集中到資本最充足的參與者手中。
這意味着 OpenLedger 的驗證者拓撲揹負着一種大多數 AI 基礎設施項目低估的隱性負擔:驗證者並不是僅在進行共識排序,而是在間接地確保經濟解釋。
這種差異會引入一種不尋常的治理動態。
在傳統區塊鏈系統中,治理爭議常常圍繞升級、發行或驗證者激勵展開。在 OpenLedger 中,治理壓力很可能集中在歸因標準本身。一旦經濟價值取決於衡量貢獻質量,網絡就會繼承一個不可避免的政治層。參與者自然會試圖影響“貢獻如何被衡量”,因爲衡量本身會變得等同於經濟准入。
這就是基礎設施從結構上變得有趣的地方。
OpenLedger 似乎理解:僅有流動性抽象不足以支撐 AI 協調。沒有歸因完整性的資本流動最終會產生掠奪行爲。系統會被那些能夠製造可見性而不是產生真實信息價值的參與者主導。就實際而言,這意味着在歸因機制無法在壓力下保持韌性時,網絡可能會獎勵“優化過的參與模式”,而不是有意義的基礎設施貢獻。
因此,該項目似乎是圍繞一場艱難的平衡性設計而成的。
一方面,它試圖減少數據集、模型與執行環境之間的摩擦,使 AI 資源在經濟層面實現可組合。另一方面,每一次可組合性的提升,也會擴大合成協調行爲的表面積。參與經濟變得越容易,就越難區分富有成效的參與與剝削性的優化。
這會在設計中製造一種不可避免的犧牲。
通過將 AI 基礎設施抽象爲可互操作的經濟層,OpenLedger 可能獲得靈活性與流動性效率,但它同時增加了對歸因準確性的依賴。網絡會變得更具適應性,同時也更容易受到信息模糊性的威脅。這未必是缺陷。它只是追求通用型 AI 基礎設施協調而非狹窄執行專業化所付出的代價。
關鍵在於:該項目看起來在結構上清楚地認識到這種權衡,而不是假裝不存在。
在這種框架下,驗證者層變得尤其重要,因爲在以歸因爲中心的系統中,驗證者集中所帶來的風險與普通金融鏈中的集中風險不同。
在大多數第 1 層環境中,驗證者集中主要威脅的是審查抵抗或治理中立性。在 OpenLedger 中,集中式驗證者影響最終可能會塑造“歸因合法性”本身。如果一小部分基礎設施參與者獲得了對“貢獻質量如何被解釋”的不成比例影響,網絡可能會在技術上仍保持去中心化的同時,慢慢集中信息權威。
這種類型的中心化更難被察覺,因爲鏈條在交易層面仍可正常運行,但歸因標準會在暗中逐漸偏向根深蒂固的經濟利益。
再說一次,結構性檢驗保持不變:歸因能否在規模化與壓力同時存在時仍然存活?
在模擬故障條件而不是正常運行時,答案會變得更清晰。
在中等網絡活動下,OpenLedger 的協調模型可能看起來穩定,因爲歸因爭議仍然可控。但當基礎設施系統在假設層面整體失效時,它們纔會暴露出真正的架構。
設想一種場景:AI 需求在網絡中出現激進式飆升,同時流動性在競爭的模型生態之間發生碎片化。
執行壓力可能會迅速上升。驗證者需要在維持共識一致性的同時處理更大的歸因“表面”(歸因範圍)。模型提供者會競爭可見性。代理會爲經濟攫取進行激進優化。治理參與者則會面臨壓力,要求他們在現實時間中重新定義激勵分配標準。
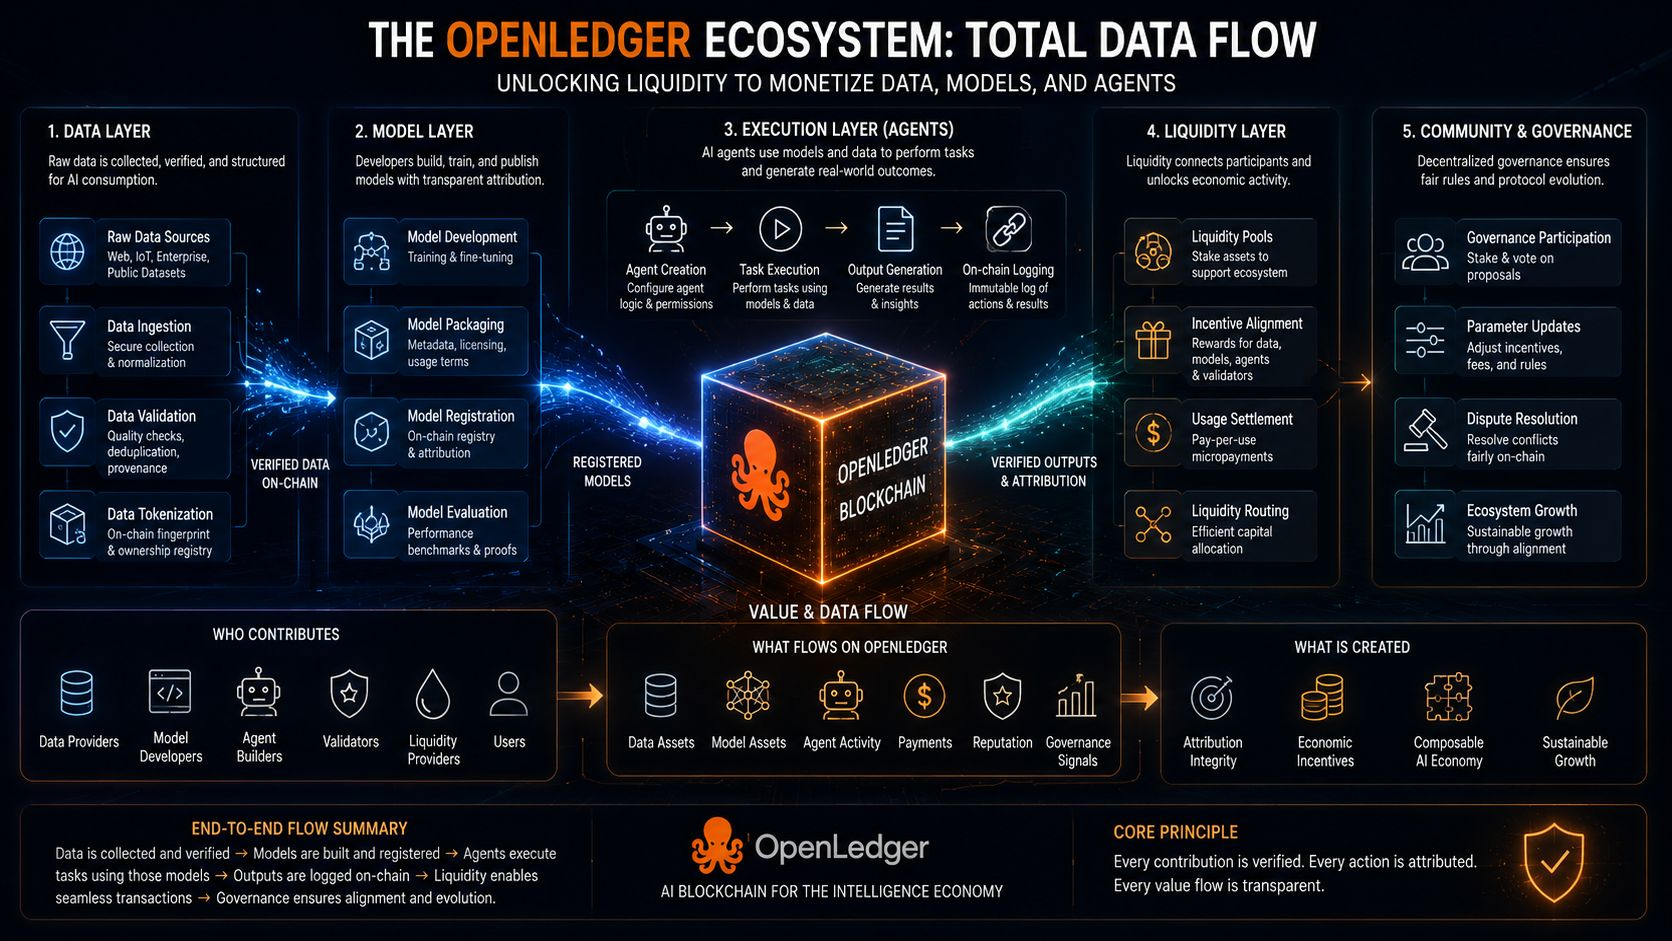
這就是以歸因爲中心的系統通常會遭遇隱藏不穩定之處。
隨着信息密度增加,驗證成本的上升速度會快於交易活動本身。網絡變得脆弱並不是因爲它無法處理交易,而是因爲它難以在擁堵下維持解釋清晰度。歸因爭議會不斷疊加。經濟路由會變得更嘈雜。協調延遲也會增加。
如果 OpenLedger 的架構能有效應對這種環境,這將表明該項目具備真正的基礎設施韌性,而不只是與 AI 趨勢敘事層面的對齊。
但相反的情景同樣完全可能。
如果在歸因衝突期間驗證者協調變慢,或者治理干預變得過於頻繁,系統可能會逐步向“軟中心化”過渡:在不確定時期,由更小羣體的參與者以非正式方式穩定解釋標準。許多基礎設施網絡會在不知不覺中滑入這種狀態。去中心化在運作層面得以保留,但實際權威會在社會層面逐漸集中。
這就是爲什麼不應主要將 OpenLedger 當作一種 AI 敘事資產來分析。
更恰當地說,它是一個實驗:在可組合智能基礎設施內部,經濟歸因能否保持穩定。這是一個比擴展交易規模或連接流動性池困難得多的問題,因爲歸因失敗往往在激勵結構已然惡化之後纔會變得不可見。
因此,該項目的長期耐久性在很大程度上不取決於擴張速度,而取決於當系統同時遭遇對抗行爲、治理分歧與執行擁堵時,其協調機制能否保住信息合法性。
這比大多數市場目前承認的基礎設施挑戰要苛刻得多。
有趣的地方並不是 OpenLedger 是否能完美成功。任何大規模協調系統都做不到完美。更重要的觀察是,該項目似乎意識到了真正的壓力集中點在哪裏。許多 AI 區塊鏈系統先優化可訪問性、後澄清治理。OpenLedger 似乎以不同的方式處理排序:它通過隱式地將“歸因穩定性”視爲基礎設施,而不是疊加在上面的可選功能。
這種設計理念或許會降低短期的簡單性,但它會提高結構層面的嚴肅性。
基礎設施很少會因爲系統完全停止工作而崩塌。更常見的是,它們會因爲失去了區分“富有成效的協調”與“表演式參與”的能力而崩塌。一旦這種區分被侵蝕,激勵就會開始以快於價值的速度放大噪聲。
OpenLedger 的架構似乎是圍繞抵抗正是這種結果而構建的。
它是否能在真實的經濟壓力下維持這種抵抗力,仍然是唯一最終重要的結構性問題。