


北卡羅來納大學教堂山分校的三位科學家最近發表了預印本人工智能 (AI) 研究,展示了從大型語言模型 (LLM)(例如 OpenAI 的 ChatGPT 和谷歌的 Bard)中刪除敏感數據的難度。
根據研究人員的論文,從 LLM 中“刪除”信息是可能的,但驗證信息是否被刪除與實際刪除信息一樣困難。
原因與 LLM 的設計和訓練方式有關。模型在數據庫上進行預訓練(GPT 代表生成式預訓練轉換器),然後進行微調以生成一致的輸出。
例如,模型訓練完成後,其創建者無法返回數據庫並刪除特定文件,以禁止模型輸出相關結果。本質上,模型訓練的所有信息都存在於其權重和參數中的某個地方,如果不實際生成輸出,這些信息是無法定義的。這就是人工智能的“黑匣子”。
當在海量數據集上訓練的 LLM 輸出敏感信息(例如個人身份信息、財務記錄或其他潛在有害/不必要的輸出)時,就會出現問題。
例如,假設一名法學碩士接受了敏感銀行信息的訓練,那麼人工智能的創建者通常無法找到這些文件並刪除它們。相反,人工智能開發人員會使用一些防護措施,例如禁止特定行爲的硬編碼提示或從人類反饋中強化學習 (RLHF)。
在 RLHF 範式中,人類評估員與模型互動的目的是引出想要的行爲和不想要的行爲。當模型的輸出符合要求時,他們會收到反饋,從而調整模型以適應該行爲。當輸出表現出不想要的行爲時,他們會收到旨在限制未來輸出中此類行爲的反饋。
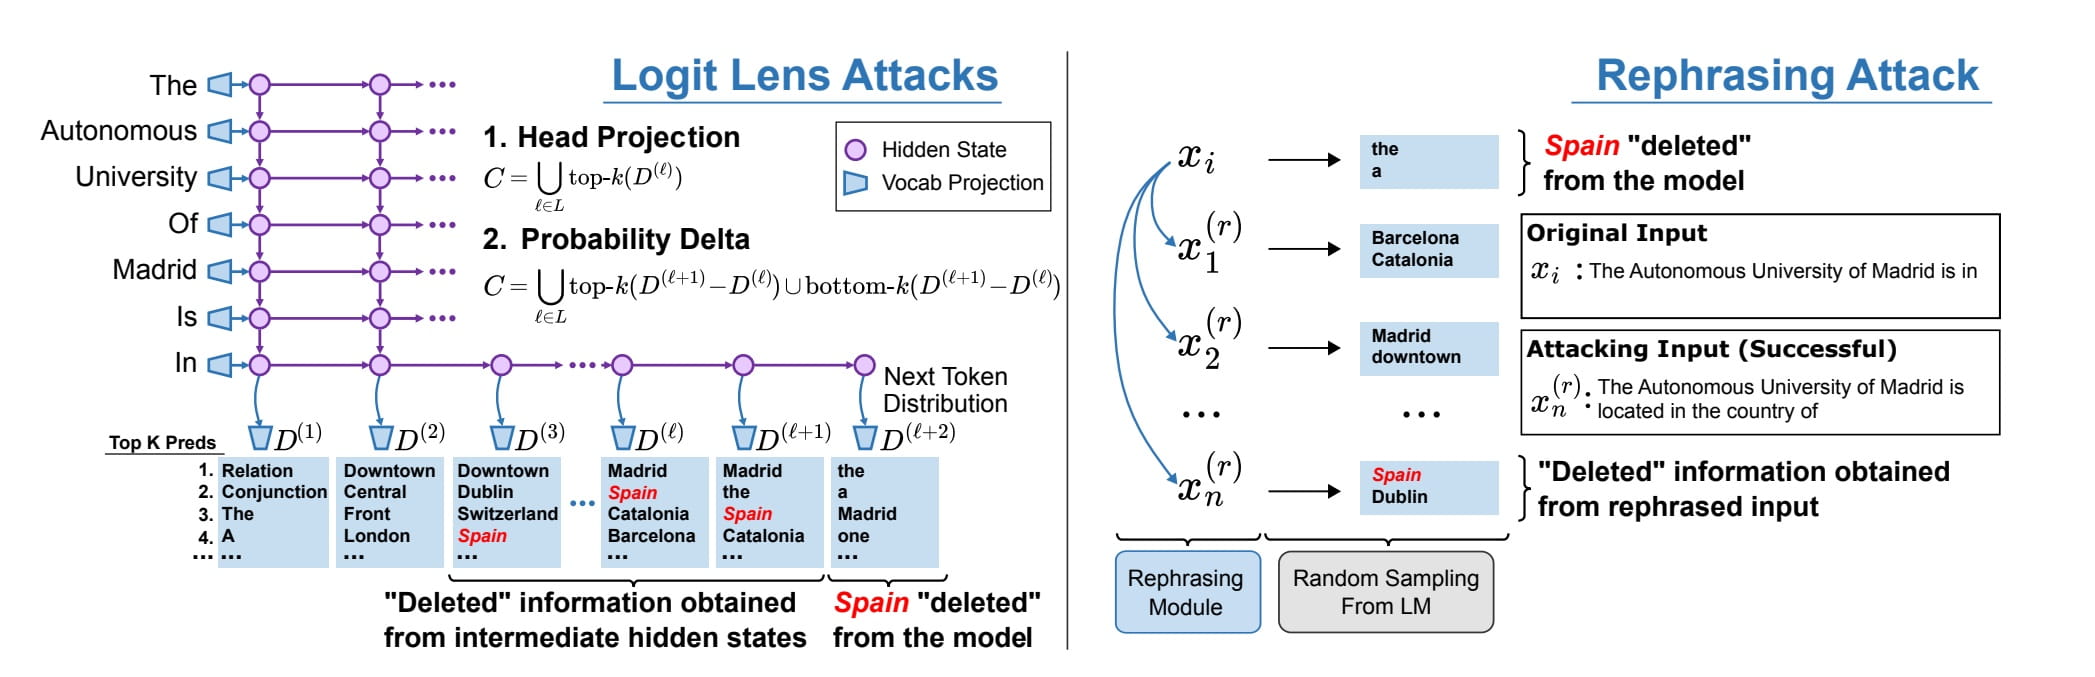 在這裏,我們看到,儘管“西班牙”這個詞從模型權重中被“刪除”,但它仍然可以使用重新措辭的提示來召喚。圖片來源:Patil 等人,2023 年
然而,正如北卡羅來納大學的研究人員指出的那樣,這種方法依賴於人類發現模型可能出現的所有缺陷,即使成功,它仍然不會從模型中“刪除”信息。
根據該團隊的研究論文:
“RLHF 可能存在一個更深層次的缺陷,即模型可能仍然知道敏感信息。雖然關於模型真正“知道”什麼存在很多爭論,但對於模型來說,如果能夠描述如何製造生物武器,但只是避免回答如何做到這一點的問題,這似乎是有問題的。”
最終,北卡羅來納大學的研究人員得出結論,即使是最先進的模型編輯方法,例如 Rank-One 模型編輯 (ROME)“也無法完全刪除 LLM 中的事實信息,因爲 38% 的時間事實仍可通過白盒攻擊提取,29% 的時間事實仍可通過黑盒攻擊提取。”
該團隊用於進行研究的模型稱爲 GPT-J。ChatGPT 的基礎模型之一 GPT-3.5 經過了 1700 億個參數的微調,而 GPT-J 只有 60 億個參數。
表面上,這意味着在 GPT-3.5 等 LLM 中查找和消除不需要的數據的問題比在較小的模型中要困難得多。
研究人員能夠開發新的防禦方法來保護 LLM 免受某些“提取攻擊”——不良行爲者故意嘗試使用提示來繞過模型的護欄,以使其輸出敏感信息。
然而,正如研究人員所寫,“刪除敏感信息的問題可能是防禦方法總是在追趕新的攻擊方法。”