


將書面提示轉化為令人信服的視覺敘述已被認為是文字到影片生成領域的關鍵挑戰,該領域正在出現許多模型。這項任務與傳統電影製作不同,需要一套不同的能力,類似於導演,掌握影片物件生成(VOG)可能是一個相當大的挑戰。此外,敏銳的觀察本身就是一種藝術形式。
為了解決這個問題,VideoDirectorGPT 提出了一種創新方法來製作精確且一致的多場景視頻,從而簡化流程。 VideoDirectorGPT 的核心採用兩階段方法,將大型語言模型 (LLM) 的強大功能與視訊調度的藝術相結合。
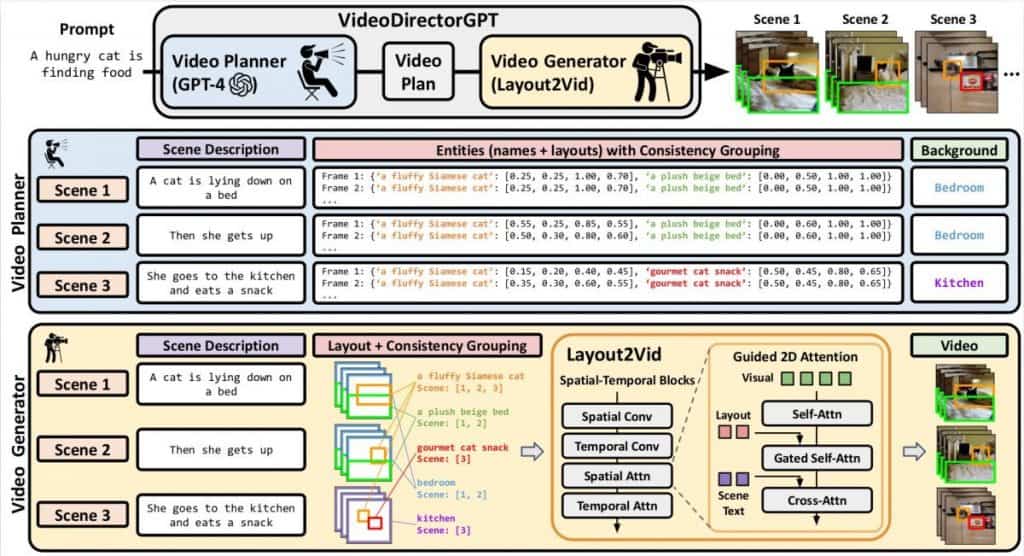
LLM 引導的調度在第一階段,VideoDirectorGPT 採用 LLM 作為視訊調度程式。法學碩士充當說故事大師,為多場景影片打造整體敘事。該敘述由場景級文本描述、每個場景中物件和背景的詳細列表、帶有邊界框的精確逐幀物件佈局以及物件和背景的智慧連貫分組組成。
Layout2Vid影片產生LLM精心製作影片計畫後,就到了付諸實踐的時候了。這就是視訊生成模組 Layout2Vid 發揮作用的地方。 Layout2Vid 在初始階段創建的藍圖上進行擴展,採用相同的圖像和文字嵌入來描繪影片計劃中的物件和背景。但值得注意的是,它透過整合到空間注意力單元中的複雜的 2D 注意力機制來提供對物件佈局的空間控制。
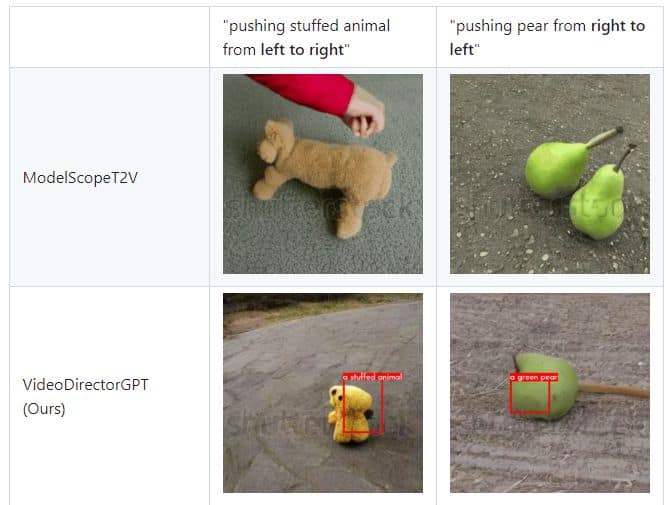 VideoDirectorGPT 模型能夠產生完整的視訊方案,其中包含準確的物件邊界框位置(重疊)、整個場景中人物的一致性以及適當擴展的原始文字提示來顯示該過程。香菜蛋糕和蜜桃梅爾巴是 ModelScopeT2V 生成的唯一食物,並且它們因場景而異。
結果是一個無縫編排的視頻,遵循最初的文本描述,將它們轉換成動態的視覺序列。它是人工智慧驅動的敘事構建和細緻的視訊渲染的結合,確保生成的內容與創作者的願景完全一致。
8月份,Yandex推出了一項名為Masterpiece的新功能,讓用戶可以創建持續長達4秒、幀率為每秒24幀的短影片。該技術使用級聯擴散方法來製作後續視訊幀,產生與用戶描述相符的圖像。 Masterpiece 提供了可訪問性和簡單性,使其成為新手和所有技能水平的用戶的有吸引力的選擇。該技術的更廣泛影響不僅限於創意表達,還可能重新定義數位內容的創作和消費。
此外,今年早些時候,Runway 發布了 Gen-2,這是一種文本轉視頻模型,可以使用文字提示從頭開始生成新視頻,比之前的版本有了顯著改進。此功能透過產生不需要高級編輯技能的影片來節省時間和精力。此外,Gen-2可以將上傳的影像轉換為比競爭對手更高品質的短影片剪輯。這項技術預計將改善社群媒體平台上內容的創建和分享,可能使 Facebook 和 TikTok 等平台受益。
閱讀更多相關主題:
最佳 50 個文字轉影片 AI 提示:簡單的圖像動畫
10 多個最佳文字到影片 AI 產生器:功能強大且免費
貼文《VideoDirectorGPT:人工智慧驅動的導演重塑文字到影片製作》首先出現在 Metaverse Post 上。