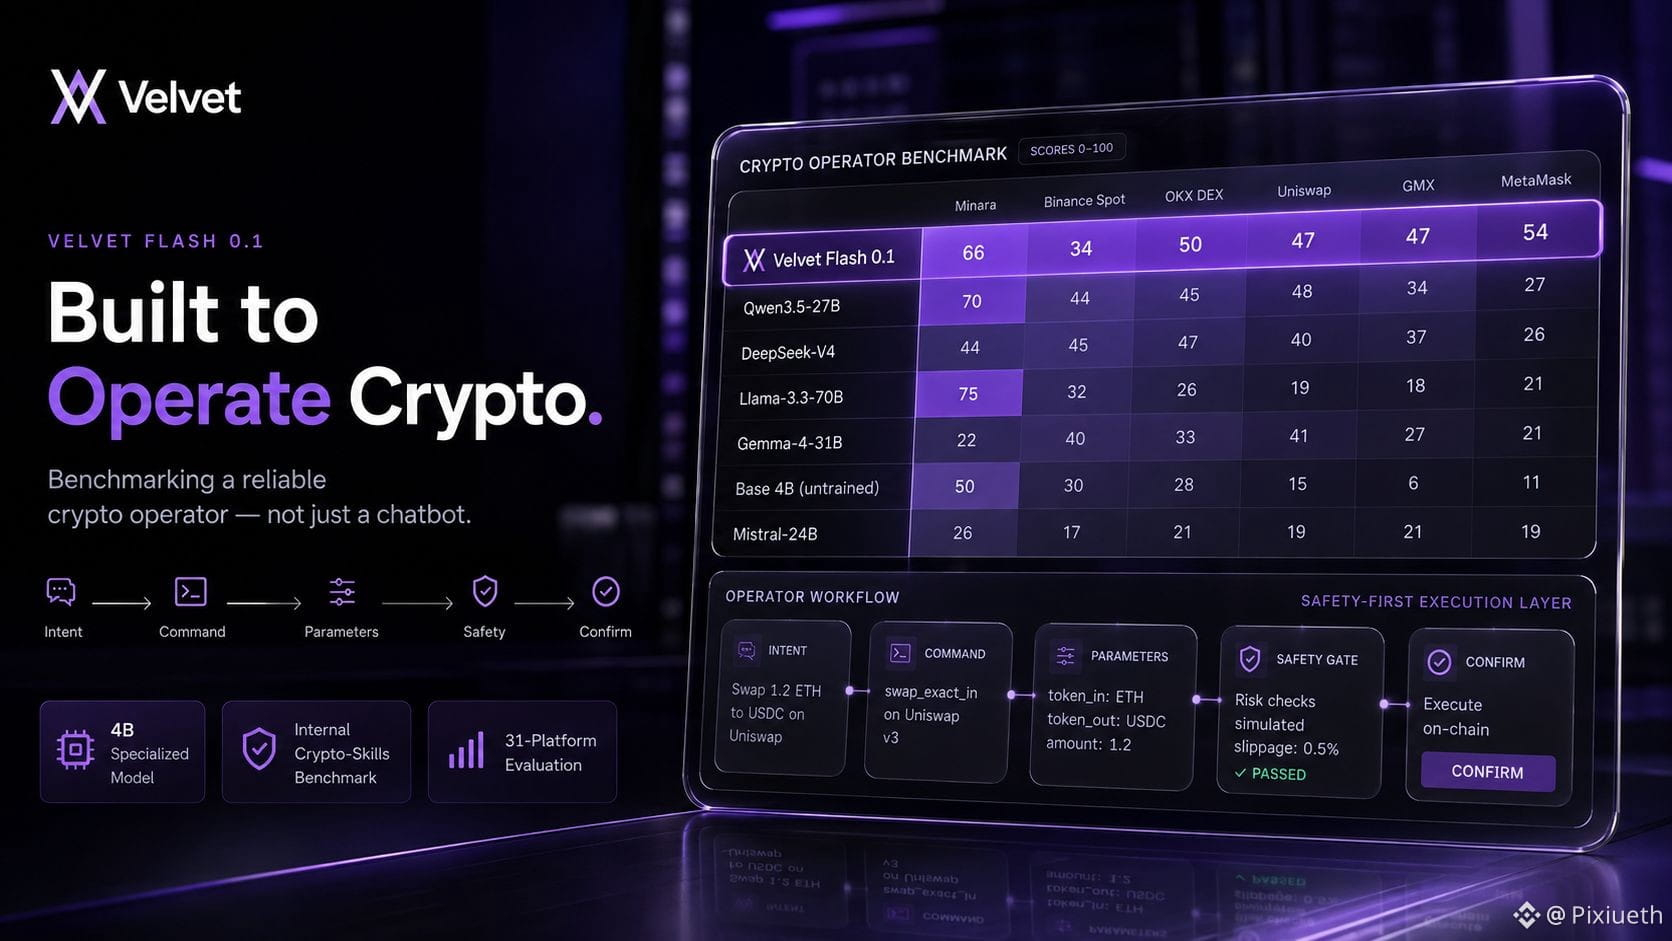
Velvet Flash 0.1 画出一条关键的线:一种能谈论加密货币的模型,并不等于一种能执行加密货币操作的模型。
@velvet_capital 正在评估:人类意图能否变成精确、特定平台的金融行动。
测试会给模型一份平台技能文档以及一条自然语言请求。它必须选择正确的指令,提取精确金额、代币、链和地址;识别高风险请求,并在资金移动之前进行确认。 这项工作与“给出一段听起来聪明的回答”完全不同。
Flash 是一个 4B 模型。在 Velvet 的内部加密“技能”基准测试中,它相较基础模型的 23 分,拿到了 50 分;同时安全性从 28 提升到 61。重要的并不是排行榜。真正受到惩罚的是基准测试背后的逻辑:错误参数、不安全的资金移动、糟糕的路由,以及当请求不应该继续时却未能停止。
核心覆盖 Minara、Binance Spot、OKX DEX、Uniswap、GMX 和 MetaMask,并在另外 31 个平台上进行更广泛的评估。每个平台都有自己的操作语法。所以更深层的问题是:互操作性——一条来自人类的请求,能否在不同指令、参数和安全规则之间完成“翻译”后仍不丢失其含义?
Flash 0.1 仍是首个版本,这也是 Velvet 自身的基准。它并不能证明在这 31 个平台上完全没有错误、必然盈利,或已具备全面的生产级支持。但方向比一次模型发布更重要:当我能够可靠理解你的意思,并且把它稳定地变成“我确切知道你指的是哪种操作”,以及“我什么时候不应该执行它”——金融 AI 才会真正变得有用。