


2024.03.14
giới thiệu dự án
Ra mắt vào tháng 6 năm ngoái, Grass xây dựng một mạng quét web phi tập trung tập trung vào việc biến dữ liệu web công cộng thành bộ dữ liệu AI. Mạng này do người dùng sở hữu và vận hành và là cách dễ dàng nhất để mọi người tương tác với AI. Mọi người có thể nhanh chóng tạo nút Grass của riêng mình. Để biết chi tiết, bạn có thể xem hướng dẫn do Goose đăng trước đó. Bạn cũng có thể chơi nó trên điện thoại di động của mình!
Hiện tại, giá của Cá voi đã đạt 4,6U/1.000 điểm trong và ngoài thị trường. Dưới điều kiện mạng 75%, một thiết bị IP có thể khai thác khoảng 50.000 điểm trong một tháng, tức là 240U. Cách đây rất lâu, Goose đã yêu cầu bạn khai thác, nhưng nhiều người quá lười khai thác. Bây giờ tôi nói với bạn rằng bạn có thể khai thác 240u bằng máy tính hoặc điện thoại di động trong một tháng, miễn là bạn cúp máy thêm một vài đơn vị. ở nhà người thân, bạn bè trong dịp Tết Nguyên đán sẽ có vài 240u Bạn có chút tiếc nuối không? Nếu bạn hối hận thì hãy nhanh chóng đến làm bài tập về nhà nhé! !
Grass hiện có kế hoạch ra mắt Bản tổng hợp dữ liệu Lớp 2 đầu tiên trên SOL. Goose đã đặc biệt chia nó thành một phiên bản quá dài để đọc và một phiên bản bài viết chính thức để bạn bè đọc hiểu.
Quá lâu để xem
Trước khi Grass đề xuất kế hoạch này, nó chỉ có khái niệm DEPIN cộng với AI, nhưng bây giờ nó có kế hoạch xây dựng chuỗi công khai AI của riêng mình. Điều này có nghĩa là Grass đã mở rộng sang một mô hình kinh doanh khác hoàn toàn khác so với trước đây. Nó có thêm chức năng sổ cái dữ liệu và chức năng xử lý ZK từ hoạt động kinh doanh đơn giản trước đây là giúp các công ty AI làm sạch dữ liệu. Sau khi Lớp 2 được xây dựng, khái niệm của nó sẽ trở thành SOL+DEPIN+AI+khái niệm tổng hợp dữ liệu đầu tiên. Tôi sẽ không nói nó có giá trị như thế nào. Các bạn nhanh tay tìm hiểu nhé.
Hướng dẫn phiên bản PC:
https://weibo.com/tarticle/p/show?id=2309404997006383775962
Hướng dẫn phiên bản di động:
https://weibo.com/tarticle/p/show?id=2309404998038614573232
tích cực
Grass: Bản tổng hợp dữ liệu Lớp 2 đầu tiên trong lịch sử
Trong vài tuần qua, chúng tôi đã xuất bản một số nội dung để giải thích vai trò của Grass trong nhóm AI. Bây giờ, bạn đã biết rằng giao thức này thực hiện nhiều chức năng để giúp người xây dựng truy cập dữ liệu mạng để đào tạo mô hình của họ. Đây là giai đoạn đầu tiên quan trọng của quá trình AI và là điểm khởi đầu cho mọi sự phát triển.
Trong trường hợp của Grass, một tập hợp các nút được lưu trữ trên các thiết bị thường trú, thu thập và xử lý dữ liệu thô từ mạng. Nó làm sạch và chuyển đổi dữ liệu thành các tập dữ liệu có cấu trúc để đào tạo AI. Điều tuyệt vời nhất là nó thu thập dữ liệu mạng theo cách thu hút và trao thưởng cho gần một triệu người trên khắp thế giới tham gia. Nó tự mình tạo ra một hạng mục cung cấp dữ liệu AI và đó là lý do tại sao một số công ty AI lớn nhất trên thế giới chọn hợp tác với chúng tôi. Đó là lớp dữ liệu của AI.
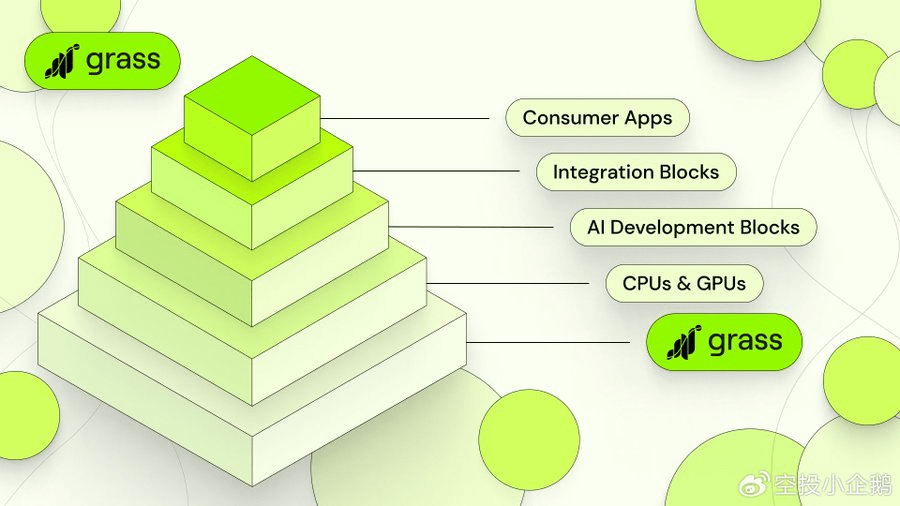
Trong khi đó, chúng tôi đã dành vài tuần qua để suy nghĩ về tình trạng trí tuệ nhân tạo hiện tại. Chúng tôi đã tự hỏi đâu là vấn đề cấp bách nhất và chúng tôi có thể làm gì để giải quyết chúng như một phần quan trọng của cơ sở hạ tầng AI.
Chúng tôi kết luận rằng vấn đề lớn nhất mà AI hiện nay phải đối mặt là thiếu tính minh bạch của dữ liệu. Chỉ cần xem tin tức là bạn sẽ hiểu. Hãy tự hỏi, tại sao một mô hình AI lại so sánh Elon Musk với Hitler? Hay xóa bỏ toàn bộ dân tộc khỏi lịch sử thế giới? Dữ liệu sai có được sử dụng trong quá trình đào tạo không? Hoặc tệ hơn, sử dụng dữ liệu tốt mà có chọn lọc đưa ra câu trả lời sai?
Câu trả lời là chúng tôi không biết. Và chúng ta không biết vì không có cách nào để biết. Chúng tôi không biết những mô hình này được đào tạo dựa trên dữ liệu nào vì không có cơ chế nào để chứng minh điều đó. Không có cách nào để người dùng xác minh nguồn gốc của dữ liệu cũng như không có cách nào để người xây dựng tự xác minh dữ liệu đó.
Đây là vấn đề mà Grass dự định giải quyết và chúng tôi hiện đang xây dựng bản tổng hợp dữ liệu Lớp 2 để giải quyết vấn đề này. Bạn có thể hỏi bằng cách nào?
Hãy cho phép chúng tôi giải thích.
Lớp thứ hai Cách tạo nguồn dữ liệu
Thế giới cần một cách để chứng minh nguồn gốc của dữ liệu đào tạo AI và đó là những gì Grass đang xây dựng. Chẳng bao lâu nữa, mỗi khi dữ liệu được thu thập bởi nút Grass, siêu dữ liệu sẽ được ghi lại để xác thực trang web nơi dữ liệu được thu thập. Siêu dữ liệu này sau đó được nhúng vĩnh viễn vào từng tập dữ liệu, cho phép các nhà xây dựng hoàn toàn chắc chắn về nguồn gốc của nó. Sau đó, họ có thể chia sẻ phả hệ này với người dùng, những người có thể yên tâm rằng mô hình AI mà họ tương tác chưa được đào tạo có chủ ý để đưa ra câu trả lời sai lệch.
Đây là một nỗ lực đáng kể và yêu cầu các phần mở rộng lớn cho giao thức của chúng tôi để chuẩn bị cho việc mở rộng quy mô hoạt động thu thập dữ liệu lên hàng chục triệu yêu cầu mạng mỗi phút. Mỗi yêu cầu sẽ yêu cầu xác thực, thông lượng này sẽ lớn hơn bất kỳ L1 nào có thể cung cấp. Đó là lý do tại sao chúng tôi đã công bố kế hoạch xây dựng giải pháp Lớp 2 để xử lý sự nâng cấp lớn về khả năng của mình. L2 sẽ là một bản tổng hợp có chủ quyền, được trang bị bộ xử lý ZK để siêu dữ liệu có thể được phân nhóm để xác thực và được sử dụng để cung cấp dòng dõi liên tục cho mọi tập dữ liệu chúng tôi tạo ra. Điều này là cần thiết để cho phép lớp nền tảng của tất cả quá trình phát triển AI chuyển sang giai đoạn tiếp theo.
Việc này có rất nhiều lợi ích: nó sẽ bảo vệ khỏi ô nhiễm dữ liệu, hỗ trợ AI nguồn mở và mang lại sự minh bạch cho các mô hình mà chúng ta tương tác hàng ngày.
Tiếp theo, chúng tôi mô tả thiết kế cơ bản của hệ thống.
kiến trúc cỏ
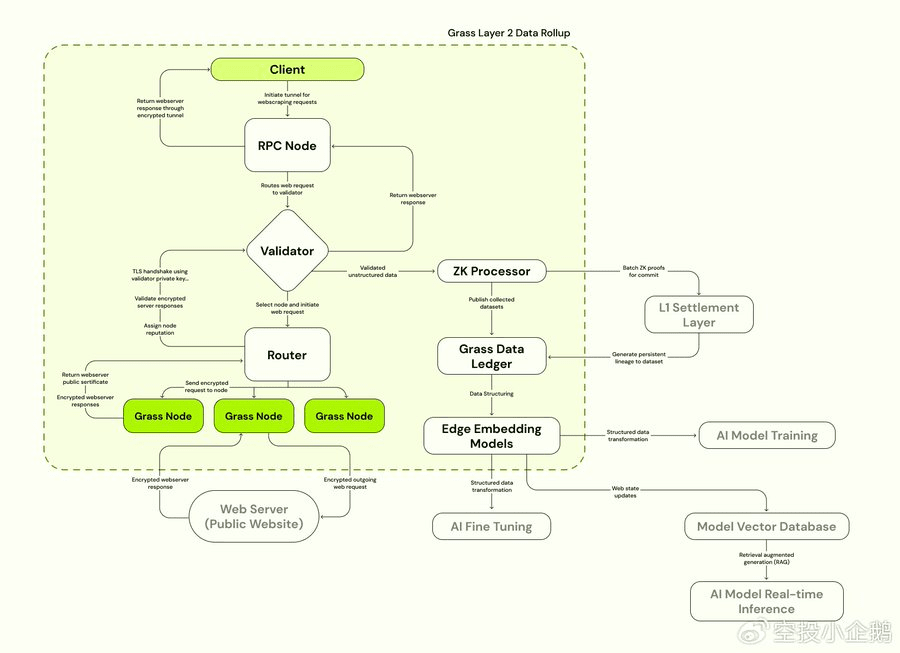
Cách dễ nhất để hiểu những nâng cấp này là xem biểu đồ của Grass Data Rollup. Ở bên trái, giữa máy khách và máy chủ web, bạn thấy mạng của Grass, như được xác định theo truyền thống. Máy khách thực hiện yêu cầu mạng, chuyển qua trình xác nhận và cuối cùng được định tuyến qua nút Grass. Máy chủ của trang web được khách hàng yêu cầu sẽ phản hồi yêu cầu mạng, cho phép thu thập dữ liệu của nó và gửi lại qua đường truyền. Dữ liệu sau đó sẽ được làm sạch, xử lý và chuẩn bị cho việc đào tạo thế hệ mô hình AI tiếp theo.
Trong sơ đồ L2, bạn sẽ thấy hai bổ sung chính ở bên phải sẽ được thêm vào khi ra mắt Lớp 2 có chủ quyền của Grass: Sổ cái dữ liệu Grass và Bộ xử lý ZK.
Cả hai đều có chức năng riêng nên chúng tôi sẽ giải thích từng cái một.
Sổ cái dữ liệu cỏ
Sổ cái dữ liệu là nơi lưu trữ cuối cùng cho tất cả dữ liệu trên Grass. Nó là một sổ cái vĩnh viễn của mọi tập dữ liệu được thu thập trên Grass, hiện có siêu dữ liệu được nhúng để ghi lại dòng dõi của nó kể từ thời điểm ban đầu. Bằng chứng về siêu dữ liệu cho mỗi tập dữ liệu sẽ được lưu trữ trên lớp thanh toán của Solana và chính dữ liệu thanh toán sẽ có thể truy cập được thông qua sổ cái. Tầm quan trọng của việc Grass có một nơi để lưu trữ dữ liệu mà nó thu thập cần được lưu ý, mặc dù chúng ta sẽ sớm đề cập đến điều đó.
bộ xử lý ZK
Như chúng tôi đã mô tả ở trên, mục đích của bộ xử lý ZK là hỗ trợ ghi lại nguồn gốc của các bộ dữ liệu được quét trên mạng Grass. Hãy tưởng tượng quá trình này.
Khi một nút trên mạng - nói cách khác, người dùng sử dụng tiện ích mở rộng Grass - gửi yêu cầu mạng đến một trang web nhất định, nó sẽ trả về phản hồi được mã hóa chứa tất cả dữ liệu mà nút đó yêu cầu. Vì mọi mục đích, đây là thời điểm tập dữ liệu của chúng ta ra đời và là thời điểm xuất xứ cần được ghi lại.
Và đây chính xác là khoảnh khắc chúng tôi ghi lại khi ghi lại siêu dữ liệu. Nó chứa nhiều trường - khóa phiên, URL của trang web được thu thập thông tin, địa chỉ IP của trang web mục tiêu, dấu thời gian của giao dịch và tất nhiên là cả dữ liệu. Đây là tất cả thông tin cần thiết để biết chắc chắn rằng một tập dữ liệu cụ thể đến từ trang web mà nó dự định xuất hiện và do đó, một mô hình AI cụ thể đã được đào tạo chính xác - và trung thực.
Vai trò của bộ xử lý ZK là do dữ liệu này cần được xử lý trên chuỗi, nhưng chúng tôi không muốn tất cả dữ liệu này hiển thị cho người xác thực Solana. Hơn nữa, số lượng yêu cầu mạng tuyệt đối được thực hiện trên Grass trong tương lai chắc chắn sẽ vượt quá khả năng thông lượng của bất kỳ L1 nào - thậm chí là L1 mạnh như Solana. Grass sẽ sớm mở rộng quy mô đến mức hàng chục triệu yêu cầu mạng được thực hiện mỗi phút, với siêu dữ liệu cho mỗi yêu cầu cần được giải quyết trên chuỗi. Chúng tôi sẽ không thể gửi các giao dịch này tới L1 nếu không có bộ xử lý ZK thực hiện bằng chứng và phân nhóm chúng trước. Vì vậy, L2 - là con đường duy nhất có thể đạt được mục tiêu chúng ta đặt ra.
Bây giờ, tại sao điều này lại là một vấn đề lớn?
Lợi ích của lớp 2
sổ cái dữ liệu
Tầm quan trọng của sổ cái dữ liệu là nó nâng quy mô của Grass thành một mô hình kinh doanh khác - và khác biệt về cơ bản -. Mặc dù giao thức sẽ tiếp tục xem xét kỹ lưỡng những người mua gửi yêu cầu mạng của riêng họ và thu thập dữ liệu của chính họ trên web, nhưng một phần hoạt động ngày càng tăng của nó sẽ liên quan đến dữ liệu đã được lưu trữ trên sổ cái. Với khả năng này, Grass giờ đây có thể thu thập dữ liệu một cách chiến lược để đào tạo LLM và lưu trữ dữ liệu đó trong kho lưu trữ dữ liệu ngày càng mở rộng.
Kho lưu trữ này là lớp dữ liệu của ngăn xếp AI mô-đun, từ đó người xây dựng có thể chọn và chọn các khối xây dựng để đào tạo vô số mô hình khác nhau. Về cơ bản, nó là một mô hình thu nhỏ của Internet, cung cấp dữ liệu đào tạo đã được cấu trúc sẵn và sẵn sàng cho AI tiếp thu.
bộ xử lý ZK
Chúng tôi đã trình bày chi tiết tại sao bộ xử lý ZK lại quan trọng. Bằng cách cho phép chúng tôi tạo bằng chứng về siêu dữ liệu ghi lại nguồn gốc của tập dữ liệu Grass, nó cung cấp cơ chế để người xây dựng và người dùng xác minh rằng mô hình AI trên thực tế đã được đào tạo chính xác. Bản thân điều đó đã là một vấn đề lớn.
Tuy nhiên, có một điều chúng tôi chưa đề cập trước đây.
Ngoài việc ghi lại trang web nơi tập dữ liệu bắt nguồn, siêu dữ liệu còn chỉ ra các nút mà tập dữ liệu di chuyển trên mạng. Đáng chú ý, điều này có nghĩa là mỗi khi một nút thu thập dữ liệu trên mạng, họ có thể nhận được tín dụng cho công việc của mình mà không tiết lộ bất kỳ thông tin nhận dạng nào về bản thân họ.
Bây giờ, tại sao điều này lại quan trọng?
Điều này rất quan trọng vì một khi bạn có thể chứng minh được nút nào đã hoạt động, bạn có thể bắt đầu thưởng cho chúng theo tỷ lệ. Một số nút có giá trị hơn những nút khác. Một số nút thu thập dữ liệu nhiều hơn so với các nút ngang hàng của chúng. Và đây chính xác là những nút mà chúng tôi cần khuyến khích để tiếp tục mở rộng mạng lưới nhanh chóng mà chúng tôi đã thấy trong vài tháng qua. Chúng tôi tin rằng cơ chế này sẽ tăng đáng kể phần thưởng cho những khu vực cần thiết nhất trên thế giới, cuối cùng là khuyến khích mọi người ở những nơi này đăng ký và tăng công suất của mạng theo cấp số nhân.
Không cần phải nói, mạng càng lớn thì khả năng thu thập thông tin của chúng tôi càng lớn và kho lưu trữ dữ liệu mạng mà chúng tôi lưu trữ càng lớn. Vòng phản hồi tích cực chắc chắn sẽ xuất hiện và nhiều dữ liệu hơn có nghĩa là chúng tôi sẽ có nhiều dữ liệu hơn cho các phòng thí nghiệm AI cần dữ liệu đào tạo - do đó mang lại động lực để mạng tiếp tục phát triển.
Tóm lại là
Nhìn chung, hầu hết các vấn đề nổi bật trong AI ngày nay đều xuất phát từ việc thiếu khả năng hiển thị về cách đào tạo các mô hình. Chúng tôi tin rằng vấn đề này có thể được giải quyết bằng cách trao quyền cho AI nguồn mở với các hệ thống xác minh nguồn gốc dữ liệu. Giải pháp của chúng tôi là xây dựng bản tổng hợp dữ liệu Lớp 2 đầu tiên, giúp có thể giới thiệu các cơ chế ghi lại siêu dữ liệu từ tất cả các nguồn tập dữ liệu.
Bằng chứng ZK của dữ liệu này sẽ được lưu trữ trên lớp xử lý L1, trong khi bản thân siêu dữ liệu cuối cùng sẽ được liên kết với các tập dữ liệu cơ bản của nó, vì bản thân các tập dữ liệu được lưu trữ trên sổ cái dữ liệu của riêng chúng tôi. Grass cung cấp lớp dữ liệu cho các ngăn xếp AI mô-đun và những phát triển này sẽ mang lại sự minh bạch và phần thưởng cao hơn cho các nhà cung cấp nút tỷ lệ thuận với khối lượng công việc họ thực hiện.
Bản cập nhật này sẽ giúp truyền đạt một số dự án sắp tới của chúng tôi và làm rõ tư duy thúc đẩy các quyết định của chúng tôi. Chúng tôi rất vui được góp phần làm cho AI trở nên minh bạch hơn và hào hứng với nhiều trường hợp sử dụng có thể có trong tương lai cho các sản phẩm của chúng tôi. Những nâng cấp này sẽ mở ra cơ hội lớn cho các nhà phát triển, vì vậy nếu bạn hoặc nhóm của bạn quan tâm đến việc xây dựng trên Grass, vui lòng liên hệ với chúng tôi trên Discord. Cảm ơn sự ủng hộ của bạn và xin vui lòng theo dõi.
Nhận cổ phần trong cuộc cách mạng AI.