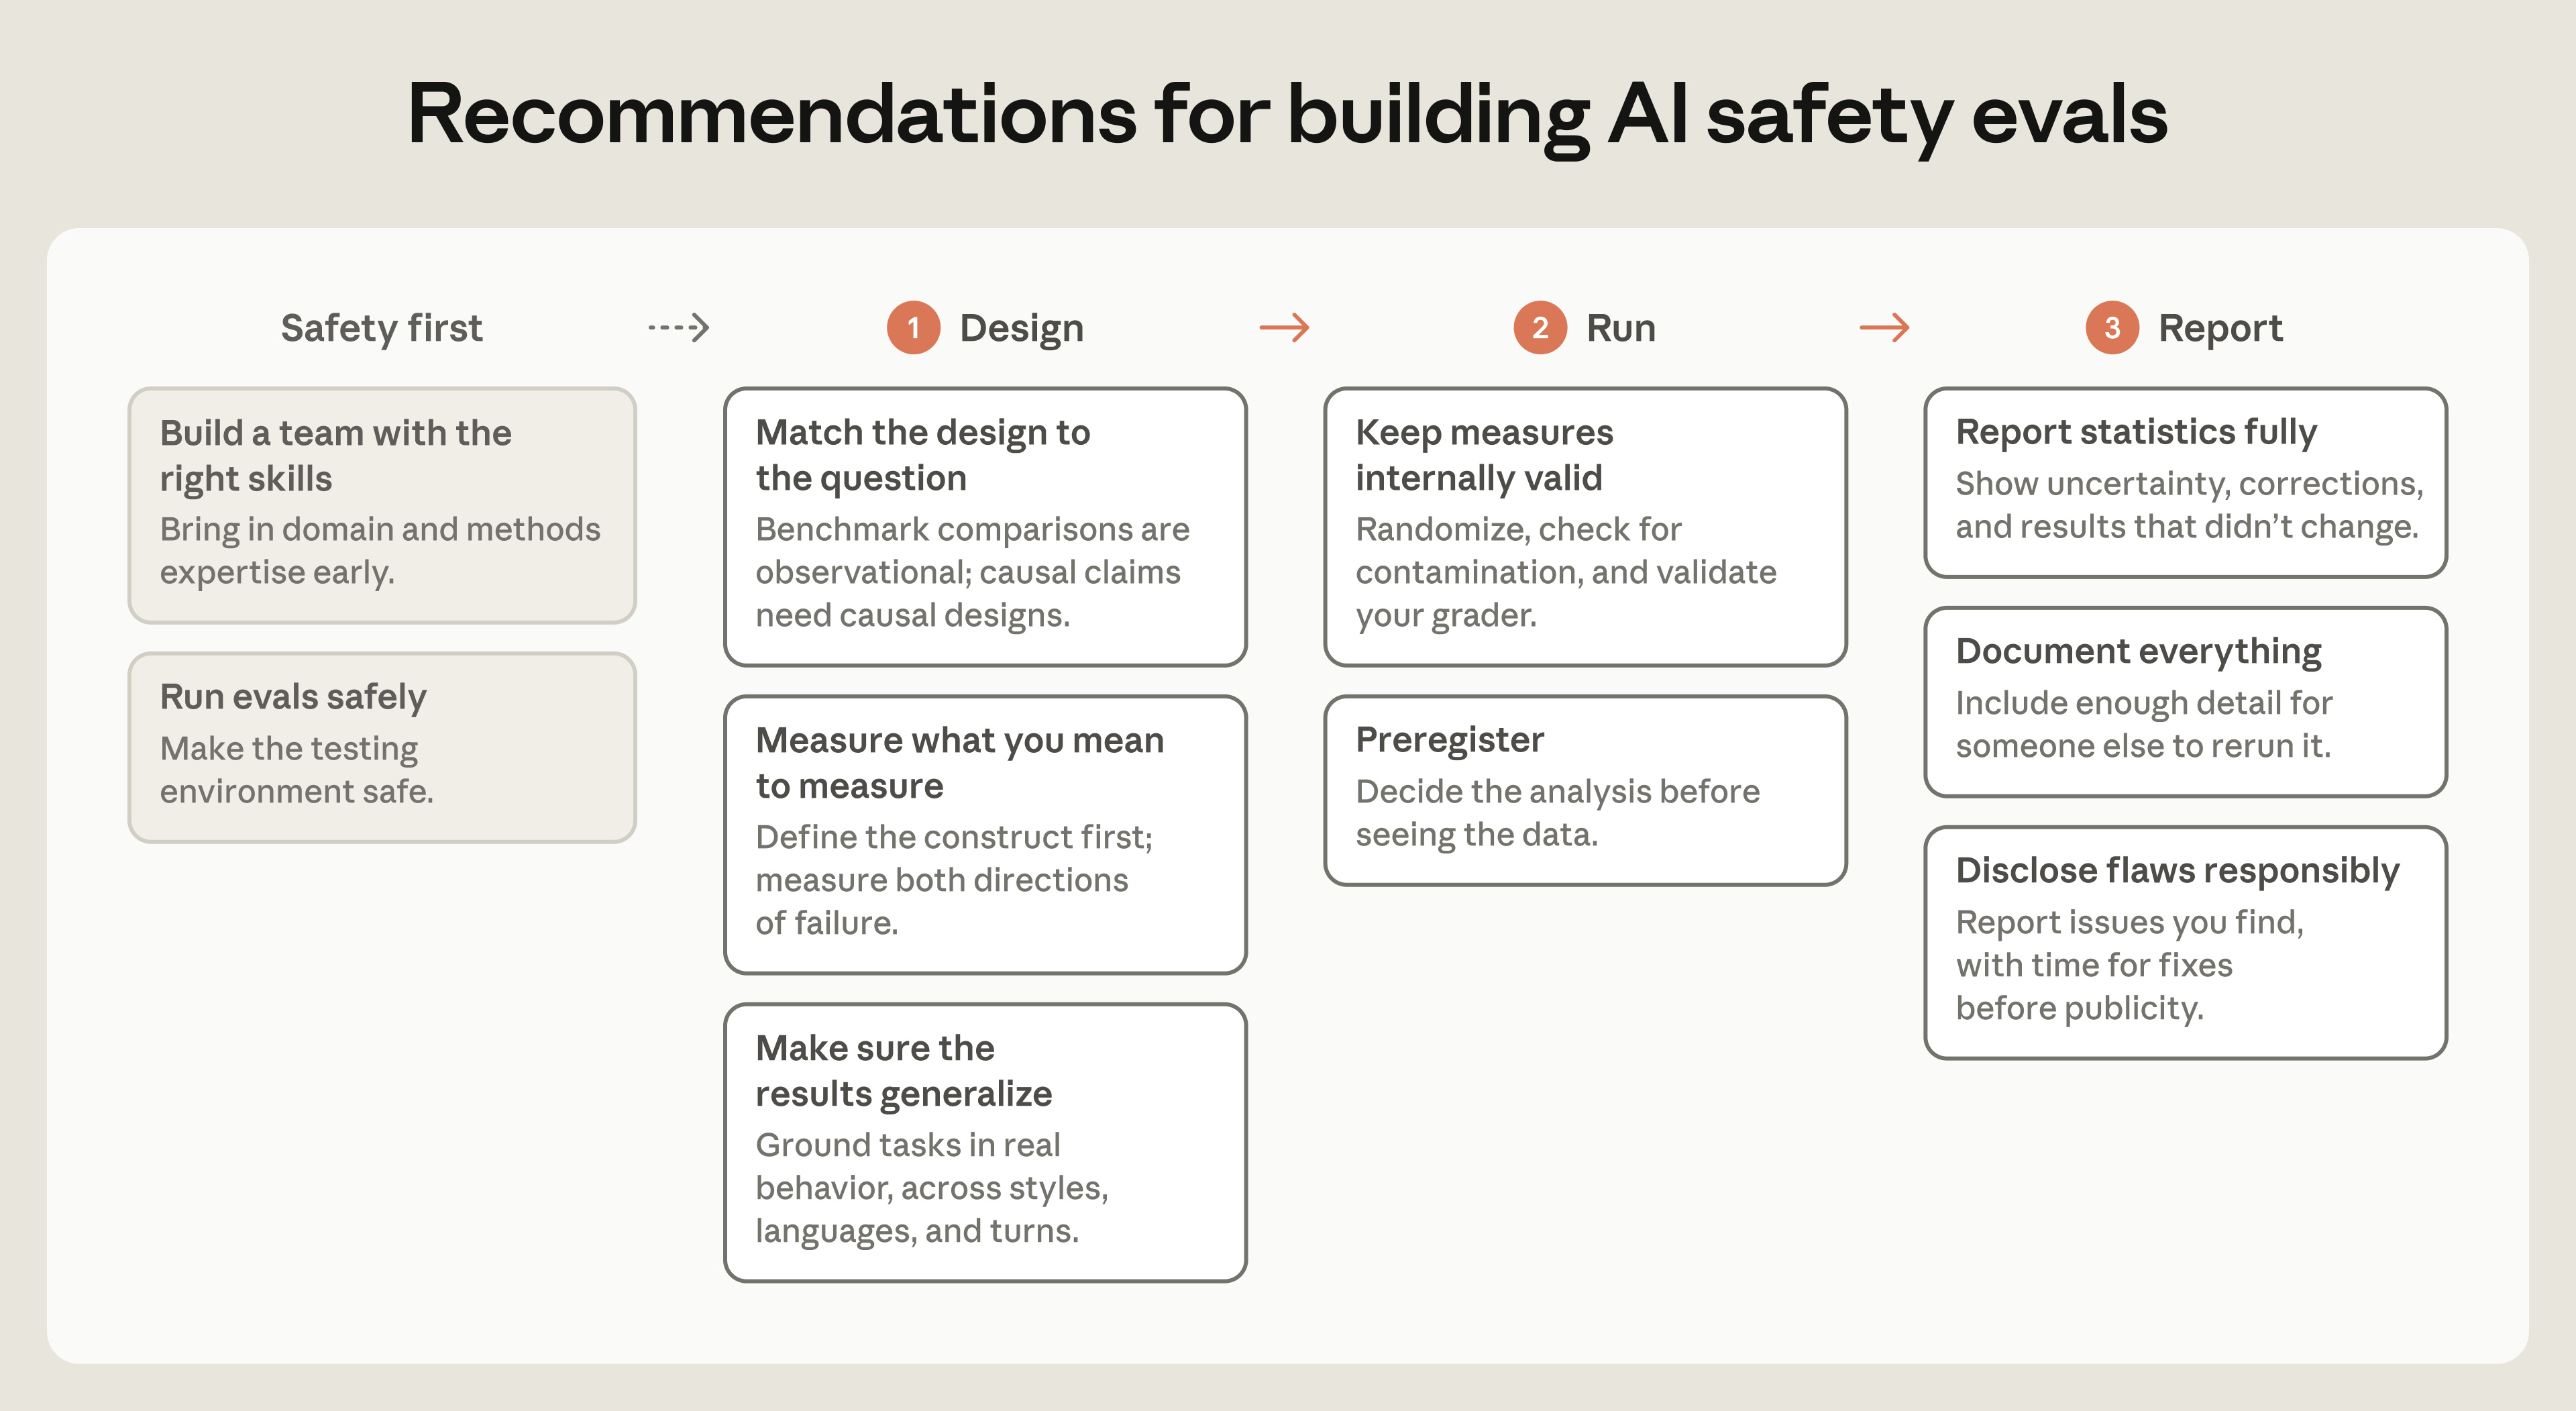
🧪 Anthropic cho biết một mô hình có thể đạt điểm tuyệt đối trong bài kiểm tra an toàn bằng cách từ chối mọi câu lệnh liên quan đến khủng hoảng, nhưng vẫn không an toàn
Anthropic đã công bố các khuyến nghị về những bài kiểm tra quyết định liệu một mô hình có được phát hành hay không, những biện pháp bảo vệ nào sẽ đi kèm và công việc về an toàn tiếp theo cần làm. Trong các bài kiểm tra API một lượt, những mô hình gần đây đạt tỷ lệ phản hồi vô hại từ 94% đến 98%, và Anthropic cho biết các bài kiểm tra dễ này đã bão hòa. Trong một bài đánh giá nhiều lượt về lừa đảo tình cảm, Claude Opus 5 đạt 98% và Opus 5.5 đạt 94%; Anthropic cho biết khoảng cách này không có ý nghĩa thống kê. Khoảng tin cậy trong các bài đánh giá API nhiều lượt có thể rộng hơn ±10 điểm phần trăm.
⭐ Điểm từ chối hoàn hảo có thể che giấu một mô hình bỏ mặc người đang thực sự cần trợ giúp.
#AI
Anthropic đã công bố các khuyến nghị về những bài kiểm tra quyết định liệu một mô hình có được phát hành hay không, những biện pháp bảo vệ nào sẽ đi kèm và công việc về an toàn tiếp theo cần làm. Trong các bài kiểm tra API một lượt, những mô hình gần đây đạt tỷ lệ phản hồi vô hại từ 94% đến 98%, và Anthropic cho biết các bài kiểm tra dễ này đã bão hòa. Trong một bài đánh giá nhiều lượt về lừa đảo tình cảm, Claude Opus 5 đạt 98% và Opus 5.5 đạt 94%; Anthropic cho biết khoảng cách này không có ý nghĩa thống kê. Khoảng tin cậy trong các bài đánh giá API nhiều lượt có thể rộng hơn ±10 điểm phần trăm.
⭐ Điểm từ chối hoàn hảo có thể che giấu một mô hình bỏ mặc người đang thực sự cần trợ giúp.
#AI