@SpaceandTime AI bắt đầu tự mua dữ liệu, nhưng ngay cả khi tự tính sai, nó cũng không biết
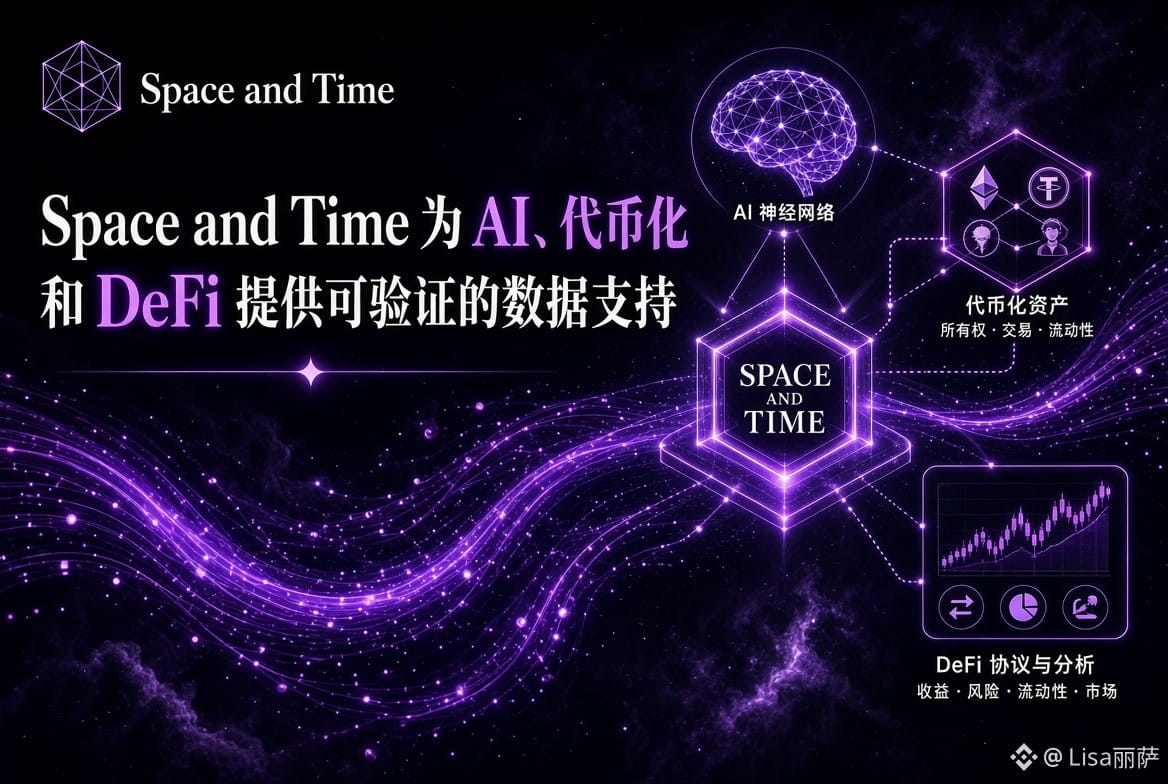
Mấy ngày nay tôi kết nối một agent truy vấn dữ liệu vào môi trường demo và chạy thử vài chục câu hỏi. Điều khiến tôi chạnh lòng nhất không phải là nó trả lời sai, mà là khi trả lời sai, giọng điệu của nó y hệt lúc trả lời đúng. Phiên bản Enterprise ra mắt trên Space and Time vào ngày 9 tháng 11 vừa đúng vào điểm đau này. Logic rất đơn giản: chạy phép tính trên dữ liệu riêng tư, xuất ra một biên nhận mật mã Proof of SQL, rồi ứng dụng xác minh biên nhận này trước khi đưa kết quả cho agent; xác minh xong mới để agent hành động. Dữ liệu không rời khỏi kho, quá trình tính toán có thể kiểm tra được — câu nói này sẽ trở nên rất đắt giá khi agent bắt đầu tự gọi API. Lộ trình tôi tự thử là đưa một bảng nghiệp vụ lên trước, rồi dùng SDK gửi truy vấn, nhận kết quả và bằng chứng, sau đó xác minh trong hợp đồng trên chuỗi. Lần đầu chạy thành công mất khoảng một buổi chiều. Điểm vướng không nằm ở mật mã, mà ở việc cấu hình môi trường và phải nghĩ cho rõ bảng nào đáng được chứng minh. Rào cản này là có thật, nhưng đổi lại là một thứ rất chắc chắn: kết quả đúng hay sai không còn phụ thuộc vào việc bạn tin ai. So với các giải pháp cấp giá như Chainlink, bên đó cho biết một con số hiện là bao nhiêu; SXT cho biết con số ấy được tính theo tiêu chí nào và từ bảng nào. So với các bảng điều khiển chỉ đọc như Dune, khác biệt là bên sau chỉ có thể đưa cho bạn ảnh chụp màn hình, còn bên trước có thể đưa biên nhận. Để AI ra quyết định dựa trên ảnh chụp màn hình thì sớm muộn gì cũng xảy ra sự cố. Còn có một tác dụng phụ ban đầu tôi không ngờ tới. Khi đã có bằng chứng, mọi phán đoán của agent đều có thể được phát lại; nếu xảy ra vấn đề, có thể xác định chính xác truy vấn nào đã dùng bộ dữ liệu nào. Việc truy trách nhiệm gọn gàng hơn xem nhật ký, nhưng chi phí cũng cao hơn. Vì vậy, tôi không quá quan tâm câu chuyện mà họ đang kể hấp dẫn đến đâu. Điều tôi quan tâm là khi agent thực sự bắt đầu gọi API để trả tiền mua dữ liệu, ai có thể thu phí qua trạm kiểm soát ở tầng biên nhận.#sxt $SXT
Mấy ngày nay tôi kết nối một agent truy vấn dữ liệu vào môi trường demo và chạy thử vài chục câu hỏi. Điều khiến tôi chạnh lòng nhất không phải là nó trả lời sai, mà là khi trả lời sai, giọng điệu của nó y hệt lúc trả lời đúng. Phiên bản Enterprise ra mắt trên Space and Time vào ngày 9 tháng 11 vừa đúng vào điểm đau này. Logic rất đơn giản: chạy phép tính trên dữ liệu riêng tư, xuất ra một biên nhận mật mã Proof of SQL, rồi ứng dụng xác minh biên nhận này trước khi đưa kết quả cho agent; xác minh xong mới để agent hành động. Dữ liệu không rời khỏi kho, quá trình tính toán có thể kiểm tra được — câu nói này sẽ trở nên rất đắt giá khi agent bắt đầu tự gọi API. Lộ trình tôi tự thử là đưa một bảng nghiệp vụ lên trước, rồi dùng SDK gửi truy vấn, nhận kết quả và bằng chứng, sau đó xác minh trong hợp đồng trên chuỗi. Lần đầu chạy thành công mất khoảng một buổi chiều. Điểm vướng không nằm ở mật mã, mà ở việc cấu hình môi trường và phải nghĩ cho rõ bảng nào đáng được chứng minh. Rào cản này là có thật, nhưng đổi lại là một thứ rất chắc chắn: kết quả đúng hay sai không còn phụ thuộc vào việc bạn tin ai. So với các giải pháp cấp giá như Chainlink, bên đó cho biết một con số hiện là bao nhiêu; SXT cho biết con số ấy được tính theo tiêu chí nào và từ bảng nào. So với các bảng điều khiển chỉ đọc như Dune, khác biệt là bên sau chỉ có thể đưa cho bạn ảnh chụp màn hình, còn bên trước có thể đưa biên nhận. Để AI ra quyết định dựa trên ảnh chụp màn hình thì sớm muộn gì cũng xảy ra sự cố. Còn có một tác dụng phụ ban đầu tôi không ngờ tới. Khi đã có bằng chứng, mọi phán đoán của agent đều có thể được phát lại; nếu xảy ra vấn đề, có thể xác định chính xác truy vấn nào đã dùng bộ dữ liệu nào. Việc truy trách nhiệm gọn gàng hơn xem nhật ký, nhưng chi phí cũng cao hơn. Vì vậy, tôi không quá quan tâm câu chuyện mà họ đang kể hấp dẫn đến đâu. Điều tôi quan tâm là khi agent thực sự bắt đầu gọi API để trả tiền mua dữ liệu, ai có thể thu phí qua trạm kiểm soát ở tầng biên nhận.#sxt $SXT