

Bài trước đo thời gian cần để tạo một proof cho một giao dịch. Có bạn góp ý rằng tôi chỉ thử tạo proof cho từng giao dịch một, chứ chưa thử khi nhiều giao dịch cùng lúc đổ vào. Máy chủ của các tổ chức ngoài đời thực sẽ không xếp hàng xử lý từng giao dịch một, vì vậy lần này tôi khởi chạy dịch vụ tạo proof của Rayls và cho dịch vụ liên tục nhận từ 1 đến 16 yêu cầu cùng lúc trong vài phút.
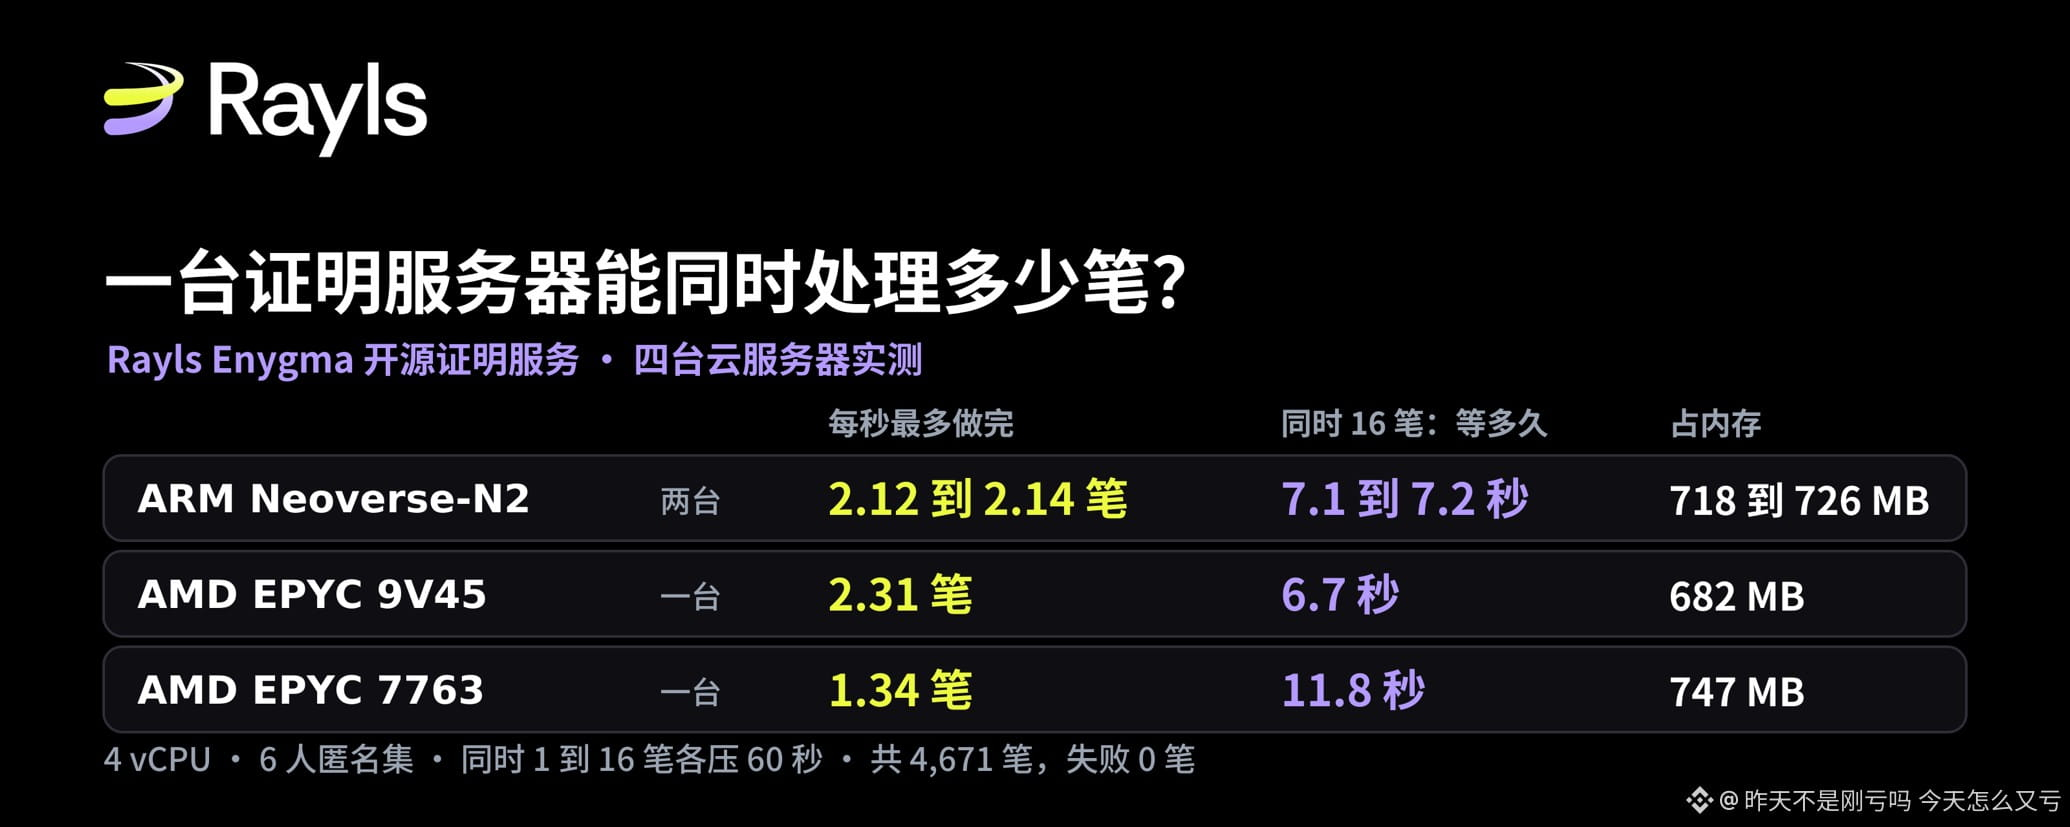
Trước tiên là câu trả lời ngắn gọn. Lấy tập ẩn danh gồm 6 người của mạch chuyển tiền riêng tư Enygma của Rayls làm ví dụ: một máy chủ đám mây 4 vCPU có thể nhận cùng lúc 16 yêu cầu và xử lý xong tất cả, không có yêu cầu nào thất bại, nhưng mỗi giây chỉ xử lý xong được 1,3 đến 2,3 yêu cầu. Khi số yêu cầu được xử lý đồng thời vượt quá 2 đến 4, việc gửi thêm yêu cầu không giúp xử lý xong nhanh hơn mà chỉ khiến từng giao dịch phải chờ lâu hơn và tốn nhiều bộ nhớ hơn: với 16 giao dịch cùng lúc, thời gian chờ trung vị cho một giao dịch tăng từ 0,5 đến 0,9 giây lên 6,7 đến 11,8 giây, còn mức sử dụng bộ nhớ tăng từ khoảng 260 MB lên 680 đến 750 MB.
Sau đây là cách thu được những con số này, lý do đằng sau chúng và ý nghĩa đối với một tổ chức dự định tự chạy dịch vụ tạo bằng chứng.
Vì sao số giao dịch xử lý đồng thời quan trọng hơn tốc độ xử lý một giao dịch
Có thể hình dung bằng chứng không tri thức như một chứng từ toán học: bên trả tiền có thể chứng minh với mạng rằng giao dịch là hợp lệ mà không tiết lộ số tiền hay đối tác giao dịch. Tạo chứng từ này đòi hỏi rất nhiều phép tính trên đường cong elliptic, hầu như hoàn toàn dựa vào CPU.
Bài trước trả lời câu hỏi mất bao lâu để tính một bằng chứng. Nhưng máy chủ của một tổ chức phải xử lý từng đợt yêu cầu đến cùng lúc. Với một dịch vụ sử dụng hết CPU, số giao dịch xử lý đồng thời quyết định thông lượng, thời gian chờ và bộ nhớ—đó mới là ba yếu tố cần tính đến khi mua sắm và triển khai.
Vấn đề này không chỉ riêng Rayls. Mọi hệ thống tự tạo bằng chứng không tri thức trên máy chủ của mình đều phải đối mặt với sự đánh đổi tương tự; khác biệt chỉ nằm ở kích thước mạch và phần cứng.
Cách kiểm thử, ai cũng có thể tái lập
Đối tượng được kiểm thử vẫn là dịch vụ tạo bằng chứng mã nguồn mở của Rayls, rayls-sovereign-gnark-api, commit 67c4c26; không sửa một dòng mã nào. Mã kiểm thử nằm trong kho công khai hansonhan0520-lang/enygma-bench. Lần này tôi bổ sung công cụ kiểm thử tải loadgen viết chỉ bằng thư viện chuẩn của Go và tập lệnh run_load.sh; GitHub Actions tự động chạy và nhật ký được tự động lưu vào thư mục results trong kho.
Cách kiểm thử tải: khởi chạy nguyên trạng dịch vụ tạo bằng chứng HTTP của Rayls, rồi cho 1, 2, 4, 8 và 16 yêu cầu cùng được xử lý, mỗi mức tải liên tục trong 60 giây, không tính 5 giây khởi động làm nóng. Ghi lại thời gian xử lý của từng yêu cầu và đọc bộ nhớ của tiến trình dịch vụ mỗi 0,1 giây. Cuối cùng, cho 4 yêu cầu cùng được xử lý liên tục trong 5 phút và tổng hợp số liệu theo từng khoảng 30 giây.
Toàn bộ số liệu lần này đến từ lần chạy Actions 39977915567 (ngày 23 tháng 10 năm 2026), chạy một lượt trên mỗi máy trong bốn máy chủ đám mây được cấp riêng: hai máy ARM Neoverse-N2, một máy AMD EPYC 9V45 và một máy AMD EPYC 7763. Cả bốn đều có 4 vCPU; tổng cộng xử lý 4.671 yêu cầu, không có yêu cầu nào thất bại.
Xin nói rõ phần nào là mới. Bộ tạo dữ liệu kiểm thử và phép đo thời gian xử lý một giao dịch được giữ nguyên từ bài trước. Bài này bổ sung thông lượng, độ trễ đuôi và mức sử dụng bộ nhớ của dịch vụ thực khi chạy đồng thời; tải liên tục trong 5 phút; cùng thử nghiệm đối chứng cố định CPU.
Càng nhiều giao dịch được xử lý đồng thời, tốc độ càng chậm chứ không nhanh hơn
Cả bốn máy đều có cùng một quy luật. Từ 1 lên 2 giao dịch xử lý đồng thời, số giao dịch hoàn tất mỗi giây tăng lên: N2 tăng khoảng một phần ba, 9V45 tăng khoảng 18% và 7763 tăng khoảng 14%. Đến 4 giao dịch đồng thời thì đạt đỉnh: N2 đạt 2,12 đến 2,14 giao dịch mỗi giây, 9V45 đạt 2,31 và 7763 đạt 1,34. Tăng tiếp lên 16 giao dịch thì thông lượng không những không tăng mà còn giảm, thấp hơn mức đỉnh từ 4% đến 10%.
Trong khi đó, thời gian chờ tăng liên tục. Khi có 1 giao dịch xử lý đồng thời, thời gian xử lý trung vị của một yêu cầu là 0,52 đến 0,86 giây; khi có 16 giao dịch, con số này tăng lên 6,70 đến 11,81 giây, tức gấp 11 đến 14 lần. 1% yêu cầu chậm nhất phải chờ 10,00 đến 13,91 giây.
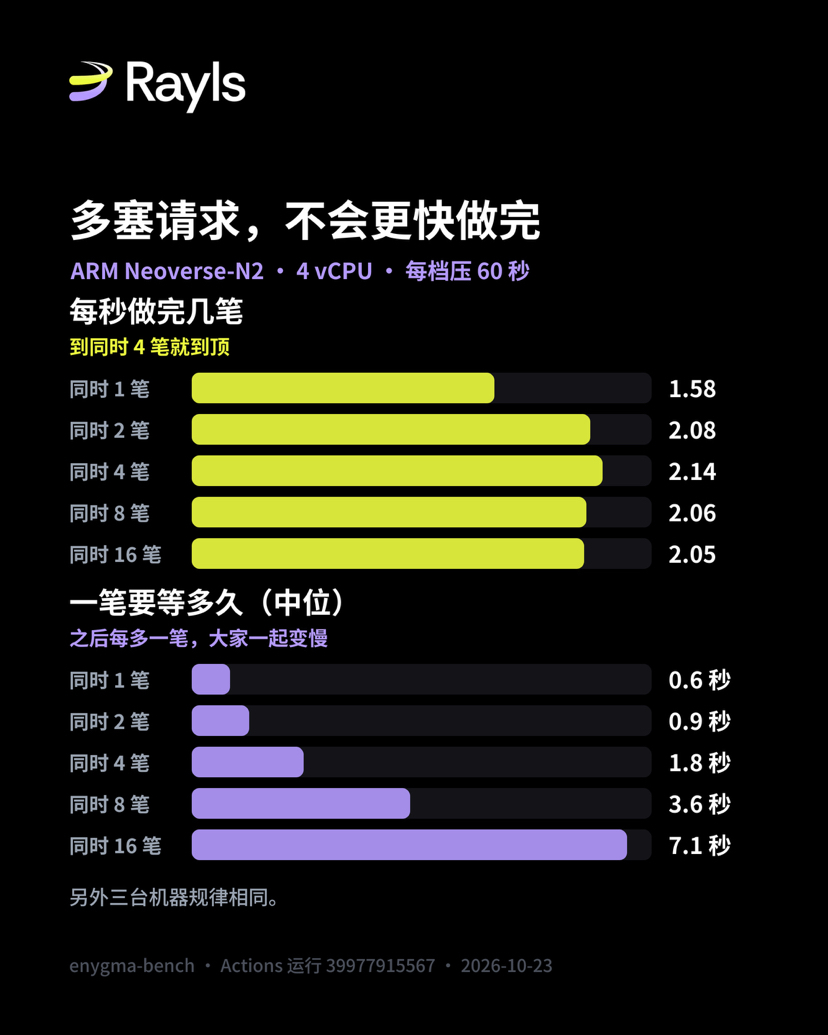
Nhật ký của chính dịch vụ cho biết thời gian chờ phát sinh ở đâu. Dịch vụ tạo bằng chứng Rayls ghi lại thời gian tạo bằng chứng nội bộ cho từng yêu cầu. Khi có 16 giao dịch đồng thời, thời gian này có trung vị chênh chưa đến 3% so với tổng thời gian đo từ bên ngoài. Nói cách khác, yêu cầu không phải xếp hàng ở cửa mà bắt đầu được xử lý ngay khi đến; cả 16 giao dịch cùng tranh 4 vCPU nên tất cả đều chậm lại. Mã nguồn xác nhận điều này: dịch vụ không đặt giới hạn đồng thời, mỗi yêu cầu đi thẳng vào quy trình tạo bằng chứng.
Đằng sau đó là một quy luật phổ quát: trên một máy đã chạy hết công suất, số giao dịch đang được xử lý đồng thời bằng thông lượng mỗi giây nhân với thời gian xử lý mỗi giao dịch. Sau khi thông lượng chạm trần, đưa thêm yêu cầu vào chỉ khiến thời gian xử lý kéo dài hơn.
Mỗi giao dịch đang xử lý thêm chiếm khoảng 30 MB bộ nhớ
Sau khi dịch vụ khởi động và nạp khóa chứng minh cho nhóm 6 người, mức sử dụng bộ nhớ khi nhàn rỗi là 210 đến 217 MB. Số yêu cầu đang được xử lý đồng thời càng nhiều thì mức sử dụng bộ nhớ càng cao: khi có 16 giao dịch đồng thời, mức đỉnh đạt 682 đến 747 MB; mỗi giao dịch đang xử lý thêm chiếm khoảng 28 đến 32 MB. Điều này không thành vấn đề với máy 4 vCPU, 16 GB, nhưng nếu số yêu cầu đột ngột tăng vọt mà không có giới hạn, bộ nhớ sẽ tăng tuyến tính theo số yêu cầu.
Không chậm đi sau 5 phút chạy liên tục
Cho 4 yêu cầu cùng được xử lý liên tục trong 5 phút, tổng hợp số liệu mỗi 30 giây. Thông lượng trong mỗi khoảng của cả bốn máy đều nằm trong phạm vi ±7% so với mức trung bình tương ứng: hai máy N2 đạt 2,03 đến 2,23 giao dịch mỗi giây, 9V45 đạt 2,13 đến 2,37 và 7763 đạt 1,30 đến 1,43. Mức bộ nhớ đỉnh ổn định ở 421 đến 505 MB, không có dấu hiệu tăng liên tục và không có yêu cầu nào thất bại trong suốt thời gian đó.
Nhận định trong bài trước nay đã được kiểm chứng bằng thử nghiệm đối chứng
Trong bài trước, tôi thấy máy Intel chỉ nhanh hơn 1,17 lần khi tăng từ 2 lên 4 vCPU, rồi dùng thông tin lscpu hiển thị 2 lõi, mỗi lõi chạy 2 luồng, để giải thích. Người phản biện chỉ ra rằng máy chủ đám mây là máy ảo; số lõi nhìn thấy không thể chứng minh phần cứng bên dưới được phân bổ như thế nào, nên lời giải thích đó chỉ là suy đoán.
Lần này, tôi dùng taskset để cố định chương trình tạo bằng chứng vào các CPU được chỉ định, rồi so sánh hai tổ hợp gồm hai CPU trên cùng một máy: hai CPU là hai luồng trên cùng một lõi hoặc nằm trên hai lõi khác nhau. Thử nghiệm được lặp ba vòng với thứ tự luân phiên để tránh sai lệch do trạng thái máy thay đổi theo thời gian. Kết quả của hai máy AMD nhất quán ở cả ba vòng: hai luồng trên cùng một lõi chỉ nhanh hơn một CPU từ 1,10 đến 1,18 lần; hai lõi khác nhau nhanh hơn từ 1,53 đến 1,57 lần. Trên N2 không có siêu phân luồng, hai CPU nhanh hơn từ 1,49 đến 1,58 lần.
Vì vậy, lời giải thích rằng siêu phân luồng khiến vCPU thứ 3 và thứ 4 không giúp được nhiều giờ đây đã có kết quả đối chứng trên cùng một máy làm cơ sở. Tuy nhiên, cần nêu rõ giới hạn: đây vẫn chỉ là cấu trúc liên kết quan sát được bên trong máy ảo; tôi không thể thấy máy chủ vật lý phân bổ các lõi vật lý ra sao.
Còn một điểm cần làm rõ. Mức tăng khoảng 1,5 lần khi cố định vào hai CPU thấp hơn mức khoảng 1,9 lần trong bài trước, khi không cố định CPU mà chỉ giới hạn Go sử dụng hai luồng. Một khả năng là khi không cố định, các luồng nền khác của chương trình vẫn có thể dùng thêm hai CPU còn lại; lần này chưa đo riêng điều đó. Vì vậy, số liệu cố định CPU phù hợp để so sánh các điều kiện khác nhau, chứ không nên dùng làm thước đo năng lực xử lý.
Điều này có ý nghĩa gì với một tổ chức dự định tự chạy dịch vụ tạo bằng chứng?
Phần này là suy luận, không phải kết quả đo.
Thứ nhất, đặt giới hạn số yêu cầu được xử lý đồng thời cho dịch vụ tạo bằng chứng, khoảng bằng số CPU; các yêu cầu vượt mức thì xếp hàng. Thông lượng vốn đã chạm trần ở mức 2 đến 4 giao dịch; yêu cầu vượt quá giới hạn chỉ làm chậm từng giao dịch đang được xử lý và chiếm thêm bộ nhớ. Lần này tôi chưa kiểm thử phiên bản có giới hạn, nên mức cải thiện độ trễ đuôi nhờ xếp hàng vẫn cần được xác minh.
Thứ hai, đo thông lượng trên phần cứng thực tế, đừng dựa vào nhãn dòng máy. Lần này, trên các bộ chạy x64 4 vCPU giống nhau của GitHub, máy được cấp AMD EPYC 9V45 hoàn tất 2,31 giao dịch mỗi giây, còn AMD EPYC 7763 chỉ đạt 1,34—chênh lệch hơn 40%.
Thứ ba, ước tính số lượng máy dựa trên thông lượng thay vì thời gian xử lý từng giao dịch. Bài trước dùng thời gian xử lý một giao dịch để ước tính một máy 4 vCPU đạt khoảng 1,41 đến 1,58 giao dịch mỗi giây. Lần này, khi đo thông lượng thực tế liên tục trong 5 phút với 4 giao dịch đồng thời, N2 và 9V45 đạt 2,15 đến 2,29 giao dịch mỗi giây, còn 7763 đạt 1,35. Lấy N2 làm ví dụ, con số này cao hơn khoảng 36% so với mức 1,58 giao dịch mỗi giây ước tính từ thời gian xử lý từng giao dịch trong bài trước.
Dùng con số này để tính lại cho CHAPS của Anh: trong năm tài chính 2025, trung bình 210.483 giao dịch mỗi ngày. Phân bổ vào khung giờ thanh toán từ 06:00 đến 18:00 mỗi ngày làm việc, tương đương khoảng 4,87 giao dịch mỗi giây, cần 2,1 đến 3,6 máy như vậy. Fedwire của Mỹ có trung bình 869.187 giao dịch mỗi ngày trong năm 2025; tính theo thời gian hoạt động 22 giờ mỗi ngày, tương đương khoảng 10,97 giao dịch mỗi giây, cần 4,8 đến 8,1 máy. Đây chỉ là ước tính sơ bộ về năng lực tính toán để tạo bằng chứng, không phải thông lượng thanh toán của Rayls; con số chưa tính đến các đỉnh tải trong ngày, chi phí của sổ cái và bộ chuyển tiếp. Hơn nữa, bằng chứng do chính các tổ chức khởi tạo giao dịch tạo ra, nên tải vốn đã được phân tán giữa các tổ chức.
Những điều chưa xác định
Lần này chỉ kiểm thử mạch chuyển khoản với tập ẩn danh gồm 6 người; mạch nạp tiền, rút tiền và DvP chưa được kiểm thử. Đối tượng được đo là bản thân dịch vụ tạo bằng chứng của Rayls, chứ không phải toàn bộ quy trình thanh toán Rayls; quy trình đầy đủ còn bao gồm sổ cái của từng tổ chức, bộ chuyển tiếp và trung tâm mạng riêng, những phần không thể chạy trong phạm vi mã nguồn công khai. Cả bốn máy đều là máy ảo trên máy chủ đám mây dùng chung, không phải máy chủ vật lý hay môi trường sản xuất của Rayls. Go sử dụng thiết lập thu gom bộ nhớ mặc định; đường cong bộ nhớ có thể khác nếu điều chỉnh. Tôi không tìm thấy tài liệu công khai về cấu hình phần cứng và đồng thời của môi trường sản xuất Rayls.
Nhận định của tôi
Một máy chủ đám mây thông thường có 4 vCPU có thể nhận đồng thời hơn chục yêu cầu tạo bằng chứng không gặp lỗi, đồng thời duy trì đầu ra ổn định trong vài phút. Nhưng năng lực của máy có một mức trần cứng, khoảng hơn một đến hai giao dịch mỗi giây. Vượt quá mức này, nhận thêm yêu cầu chỉ làm thời gian chờ lâu hơn và mức sử dụng bộ nhớ tăng lên.
Cách kiểm chứng rất đơn giản: bất kỳ ai cũng có thể chạy enygma-load trên trang Actions của kho enygma-bench để xem thông lượng trên máy được cấp cho mình có chạm trần tương tự khi có 2 đến 4 giao dịch đang được xử lý đồng thời hay không. Nếu sau này Rayls công bố cấu hình dịch vụ tạo bằng chứng trong môi trường sản xuất, chẳng hạn có đặt giới hạn đồng thời hay không và sử dụng phần cứng nào, ta có thể đối chiếu trực tiếp bằng bài kiểm thử tải này.
Nguồn tham khảo:
Mã nguồn dịch vụ tạo bằng chứng Rayls, raylsnetwork/rayls-sovereign-gnark-api, commit 67c4c26 (ngày 20 tháng 8 năm 2026): https://github.com/raylsnetwork/rayls-sovereign-gnark-api/commit/67c4c26696016b48e70950e284ae1a51b7d0cf0e
Mã kiểm thử tải của bài viết này và toàn bộ nhật ký, lần chạy Actions 39977915567 (ngày 23 tháng 10 năm 2026): https://github.com/hansonhan0520-lang/enygma-bench
Bài kiểm thử một giao dịch trước đó và nhật ký, lần chạy Actions 37741247183 (ngày 8 tháng 10 năm 2026): https://github.com/hansonhan0520-lang/enygma-bench
Thông số bộ chạy do GitHub lưu trữ (tra cứu ngày 8 tháng 10 năm 2026): https://docs.github.com/en/actions/reference/runners/github-hosted-runners
Thống kê Fedwire Funds năm 2025 (trang cập nhật ngày 26 tháng 1 năm 2026): https://www.frbservices.org/resources/financial-services/wires/volume-value-stats/annual-stats.html
Thống kê thanh toán và quyết toán của Ngân hàng Anh, số giao dịch trung bình mỗi ngày của CHAPS trong năm tài chính 2025: https://www.bankofengland.co.uk/payment-and-settlement/payment-and-settlement-statistics
#Rayls $RLS #BằngChứngKhôngTriThức