Vừa xem qua một bài viết về trường hợp kỹ thuật NodeGhost của @Acurast và thấy một kết quả thử nghiệm khá thú vị.
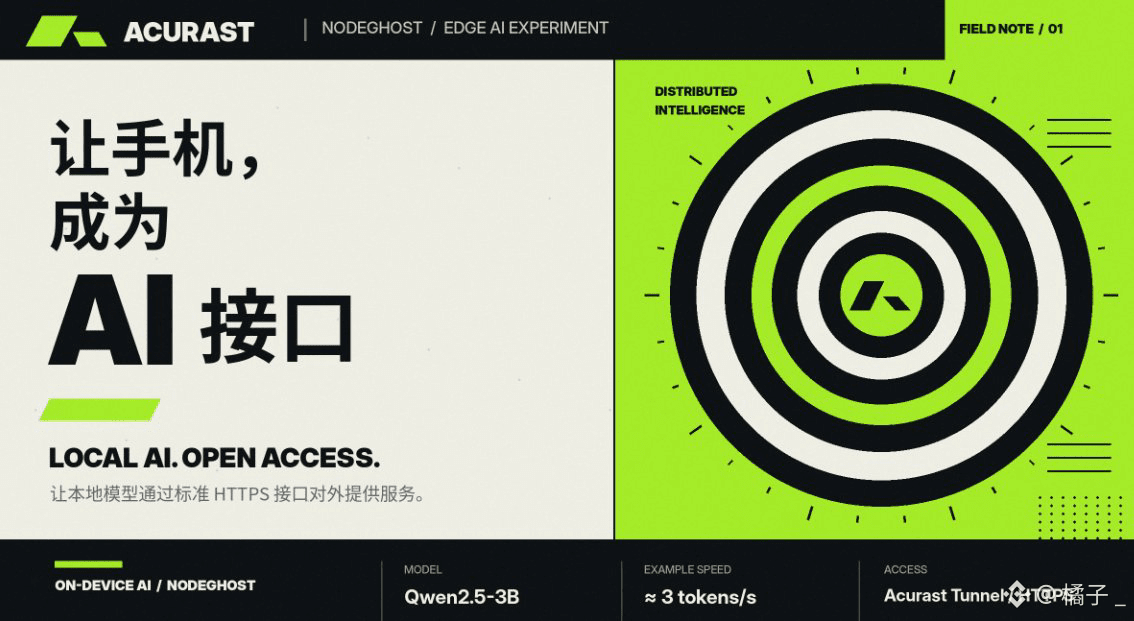
Một chiếc điện thoại chạy mô hình Qwen2.5-3B đã được lượng tử hóa, với tốc độ tạo khoảng 3 Token mỗi giây.
Để trả lời một câu hỏi dài khoảng 120 Token, cần khoảng 45 giây.
So với trải nghiệm sử dụng các mô hình lớn ngày nay, tốc độ này quả thực hơi chậm.
Nhưng điều khiến tôi chú ý ở trường hợp này là một thiết kế khác.
Thông qua Acurast Tunnel, mô hình vốn được lưu trữ cục bộ trên điện thoại và không có IP công khai vẫn có thể cung cấp giao diện HTTPS ra bên ngoài.
Sau đó, chỉ cần kết nối với API tương thích OpenAI của NodeGhost, nhà phát triển gần như không cần thay đổi cách gọi hiện có mà vẫn có thể gửi yêu cầu đến điện thoại để xử lý.
Nhờ vậy, điện thoại không còn chỉ là Processor thụ động chờ được giao nhiệm vụ trong mạng, mà còn có thể cung cấp dịch vụ suy luận AI tiêu chuẩn ra bên ngoài.
Tất nhiên, hiện tại trường hợp này vẫn là một bản triển khai tham khảo trên mạng Canary; tốc độ và khả năng xử lý suy luận phức tạp đều còn nhiều hạn chế.
Nhưng tôi nghĩ nó đã trả lời một câu hỏi rất thực tế:
Nếu nhà phát triển muốn triển khai mô hình của mình trên các điện thoại phân tán, liệu ứng dụng hiện có có thể gọi mô hình một cách thuận tiện không?
Ít nhất, hướng đi kỹ thuật này đã có ví dụ hoạt động được.
Còn về khả năng thương mại hóa, vẫn cần tiếp tục kiểm chứng độ trễ, khả năng xử lý đồng thời, chi phí và tính ổn định lâu dài.
$ACU của Acurast phụ trách kết nối việc sử dụng mạng với các cơ chế khuyến khích sức mạnh tính toán, nhưng cuối cùng có thu hút được nhu cầu trả phí hay không vẫn còn phụ thuộc vào việc các ứng dụng này có đủ sức cạnh tranh thực tế hay không.
Một chiếc điện thoại chạy mô hình Qwen2.5-3B đã được lượng tử hóa, với tốc độ tạo khoảng 3 Token mỗi giây.
Để trả lời một câu hỏi dài khoảng 120 Token, cần khoảng 45 giây.
So với trải nghiệm sử dụng các mô hình lớn ngày nay, tốc độ này quả thực hơi chậm.
Nhưng điều khiến tôi chú ý ở trường hợp này là một thiết kế khác.
Thông qua Acurast Tunnel, mô hình vốn được lưu trữ cục bộ trên điện thoại và không có IP công khai vẫn có thể cung cấp giao diện HTTPS ra bên ngoài.
Sau đó, chỉ cần kết nối với API tương thích OpenAI của NodeGhost, nhà phát triển gần như không cần thay đổi cách gọi hiện có mà vẫn có thể gửi yêu cầu đến điện thoại để xử lý.
Nhờ vậy, điện thoại không còn chỉ là Processor thụ động chờ được giao nhiệm vụ trong mạng, mà còn có thể cung cấp dịch vụ suy luận AI tiêu chuẩn ra bên ngoài.
Tất nhiên, hiện tại trường hợp này vẫn là một bản triển khai tham khảo trên mạng Canary; tốc độ và khả năng xử lý suy luận phức tạp đều còn nhiều hạn chế.
Nhưng tôi nghĩ nó đã trả lời một câu hỏi rất thực tế:
Nếu nhà phát triển muốn triển khai mô hình của mình trên các điện thoại phân tán, liệu ứng dụng hiện có có thể gọi mô hình một cách thuận tiện không?
Ít nhất, hướng đi kỹ thuật này đã có ví dụ hoạt động được.
Còn về khả năng thương mại hóa, vẫn cần tiếp tục kiểm chứng độ trễ, khả năng xử lý đồng thời, chi phí và tính ổn định lâu dài.
$ACU của Acurast phụ trách kết nối việc sử dụng mạng với các cơ chế khuyến khích sức mạnh tính toán, nhưng cuối cùng có thu hút được nhu cầu trả phí hay không vẫn còn phụ thuộc vào việc các ứng dụng này có đủ sức cạnh tranh thực tế hay không.